
Comment optimiser votre site web pour les moteurs de réponse ?
Par Louise Linehan
Expert marketing de contenu chez Ahrefs
- Ne bloquez pas les crawlers IA dans les fichiers robots.txt
- Ne cachez pas votre contenu derrière du JavaScript lourd
- Améliorez votre vitesse de page
- Ne vous embêtez pas avec un fichier llms.txt
- Corrigez les URL que l’IA hallucine à propos de votre site
- Devenez une entité reconnue
- Préparez-vous au marketing d’agent à agent
Votre contenu peut être excellent et ne jamais apparaître dans une réponse de l’IA.
Chaque tactique d’optimisation IA part du principe que les systèmes d’IA peuvent accédez à vos pages, les lire et comprendre qui vous êtes. Rien de tout cela n’est garanti. Environ 5,89 % des sites web bloquent GPTBot purement et simplement, ChatGPT semble abandonner les pages qui mettent plus d’environ deux secondes à répondre, et la plupart des crawlers IA n’exécutent pas du tout JavaScript.
La bonne nouvelle, c’est qu’il s’agit de la partie la plus facile à corriger de l’AEO. Rien ici ne vous fait gagner une citation à lui seul, mais un seul de ces problèmes peut discrètement vous coûter toutes les citations que vous auriez autrement obtenues.
Continuez à apprendre sur YouTube
Ne bloquez pas les crawlers IA dans les fichiers robots.txt
Aucun des conseils de ce guide n’a d’importance si les crawlers IA ne peuvent pas lire vos pages. Les pages bloquées ne peuvent pas être citées, et cela arrive souvent par accident.
Nous avons analysé environ 140 millions de sites web et constaté que GPTBot est désormais le bot IA le plus bloqué (5,89 % des sites), ClaudeBot arrivant juste derrière.
Cloudflare bloque par défaut les plateformes IA, alors vérifiez que votre CDN ne vous a pas discrètement exclu.
« Autoriser les crawlers IA » n’est pas une décision unique, car chaque plateforme exécute plusieurs bots pour différentes tâches.
OpenAI à elle seule en exploite trois :
- GPTBot collecte du contenu pour l’entraînement
- OAI-SearchBot conçoit l’index de recherche dans lequel ChatGPT récupère les informations
- ChatGPT-User récupère une page en direct quand un internaute pose une question à son sujet en plein milieu d’une conversation
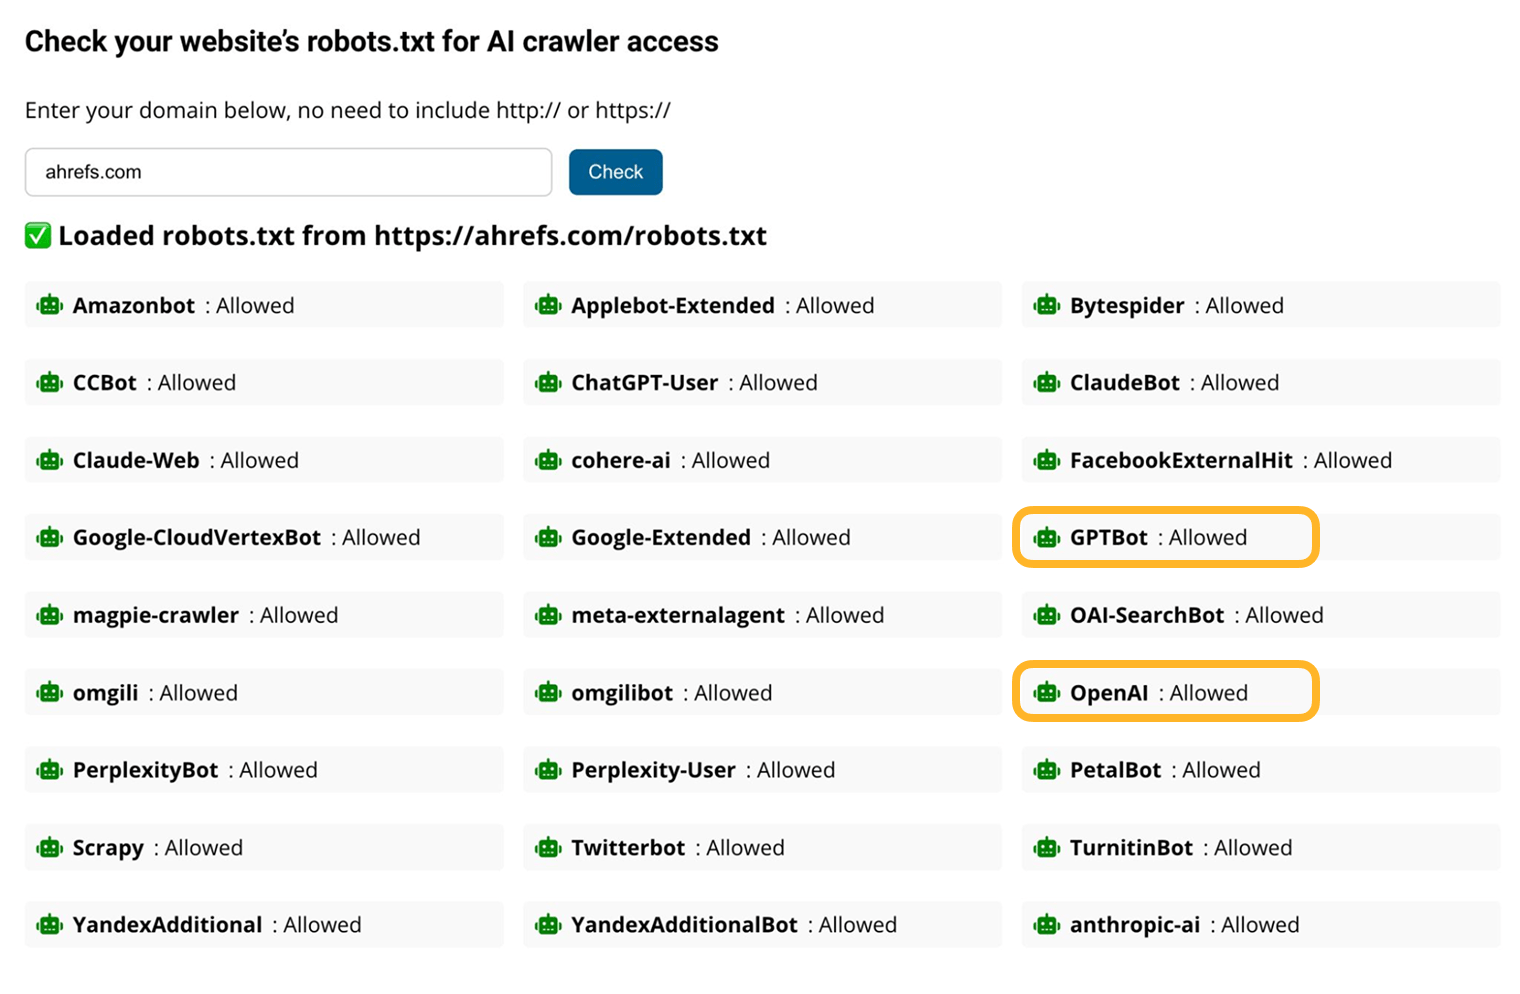
Les compromis ne sont pas les mêmes. Bloquer GPTBot empêche votre contenu d’alimenter les données d’entraînement du prochain modèle, ce qui correspond généralement au choix auquel les éditeurs sont confrontés. Bloquer OAI-SearchBot vous retire de l’index que ChatGPT explore, ce qui vous coûte aujourd’hui des citations et du trafic de référence. De nombreux sites bloquent le second par accident alors qu’ils ne voulaient bloquer que le premier.
Le moyen le plus rapide de voir où vous en êtes est d’utiliser un outil comme le vérificateur d’accès des crawlers IA, qui lit votre fichier robots.txt et vous indique quels crawlers sont autorisés à passer.
Pour voir quels bots se présentent réellement, plutôt que ceux qui sont autorisés, consultez Bot Analytics d’Ahrefs. Il suit les visites sur 12 catégories de bots, dont un filtre IA dédié, à partir de données côté serveur via Cloudflare. Par conséquent, il fonctionne sans avoir à ajouter de JavaScript à votre site.
Ne cachez pas votre contenu derrière du JavaScript lourd
Les crawlers IA ont tendance à lire le HTML brut et, la plupart du temps, n’exécutent pas le JavaScript comme le ferait un navigateur.
Cela signifie que tout ce qui n’apparaît qu’après l’exécution du JavaScript côté client peut être invisible pour eux.
Pour jouer la carte de la prudence, tenez-vous-en au rendu côté serveur afin de donner à votre page les meilleures chances d’apparaître dans l’IA.
Améliorez votre vitesse de page
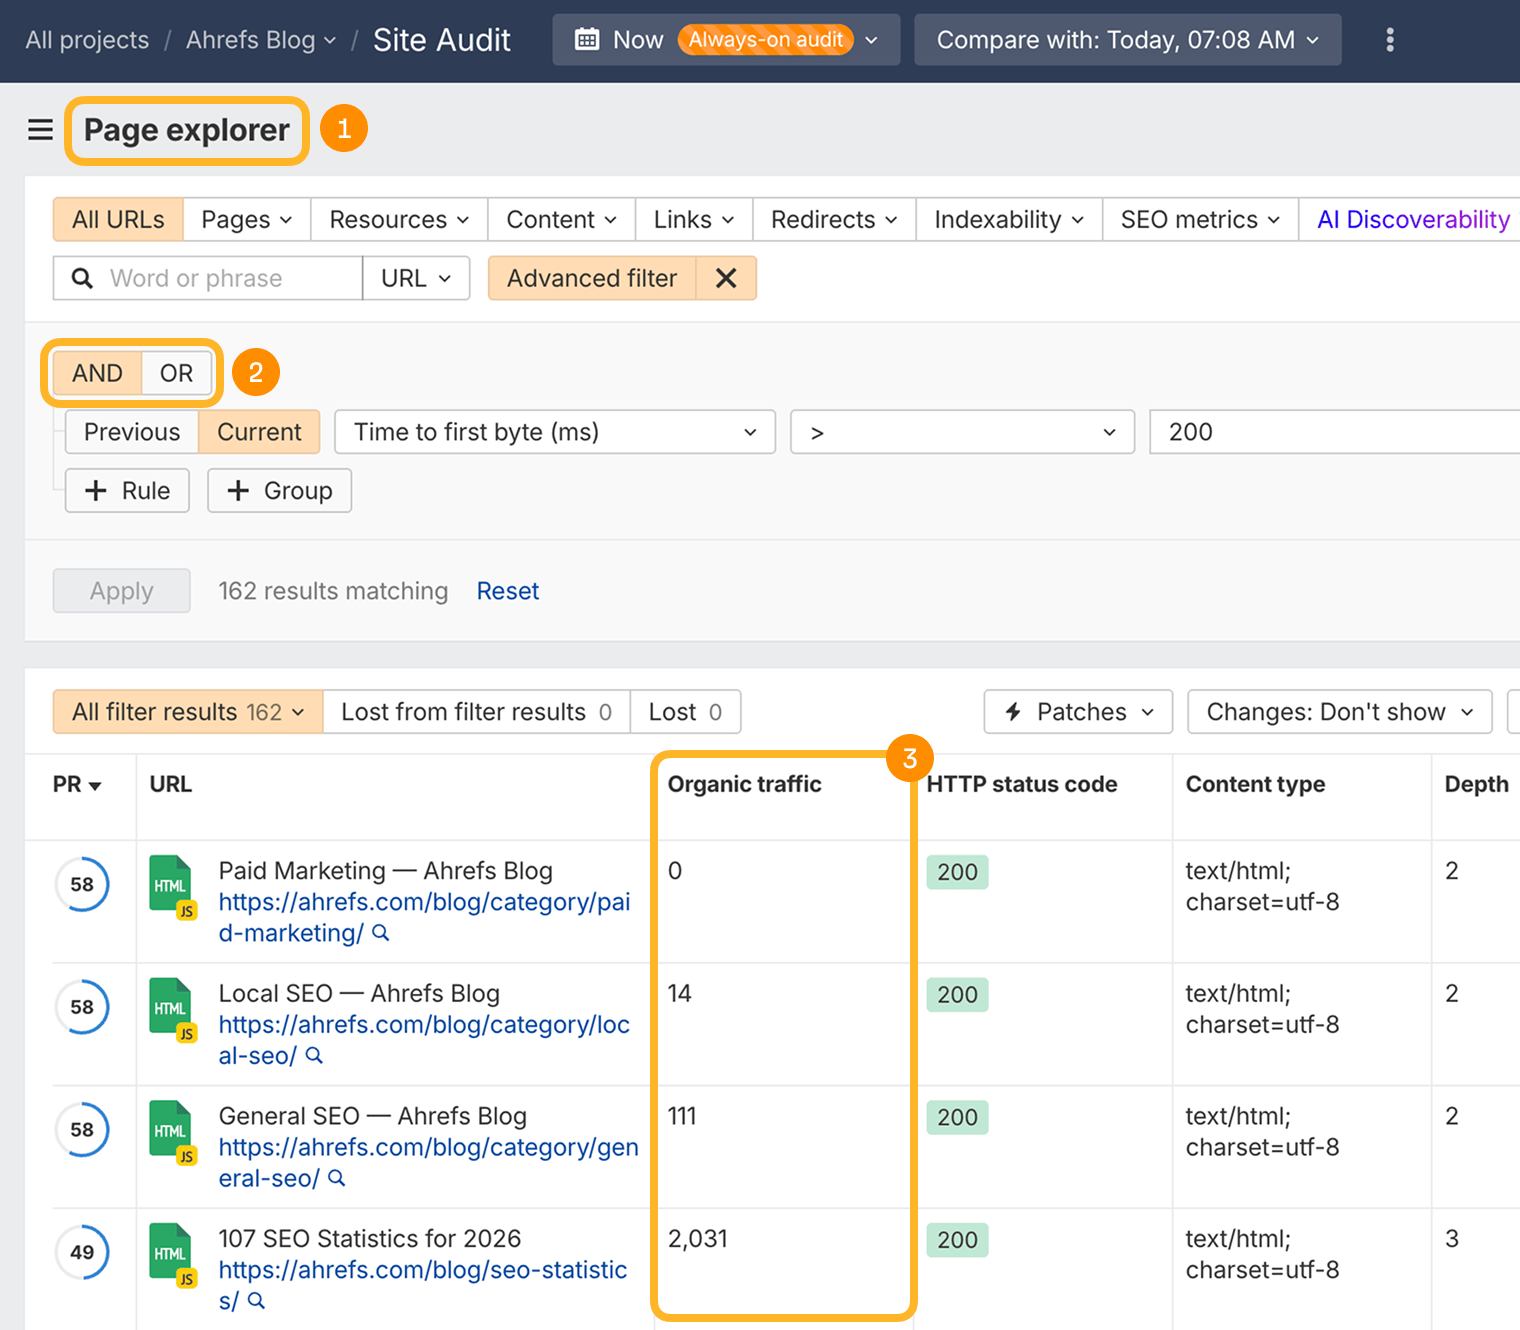
Les pages qui se chargent lentement peuvent nuire à vos performances dans la recherche classique, mais il semble que la pénalité soit encore plus forte dans les moteurs de réponse. La vitesse de page semble déterminer si vous apparaissez ou non dans la fenêtre de contexte du modèle.1
Vérifiez la vitesse de votre page (appelée « temps jusqu'au premier octet ») dans Site Audit :
Ne vous embêtez pas avec un fichier llms.txt
llms.txt est une norme proposée pour un fichier Markdown à la racine de votre domaine (p. ex. website.com/llms.txt) qui indique aux LLM où se trouve votre meilleur contenu : documentation, politiques, taxonomies de produits. En principe, c’est comme un fichier robots.txt pour les modèles de langage.
En pratique, aucun grand fournisseur de LLM ne s’est engagé à le lire. Ni OpenAI, ni Anthropic, ni Google.
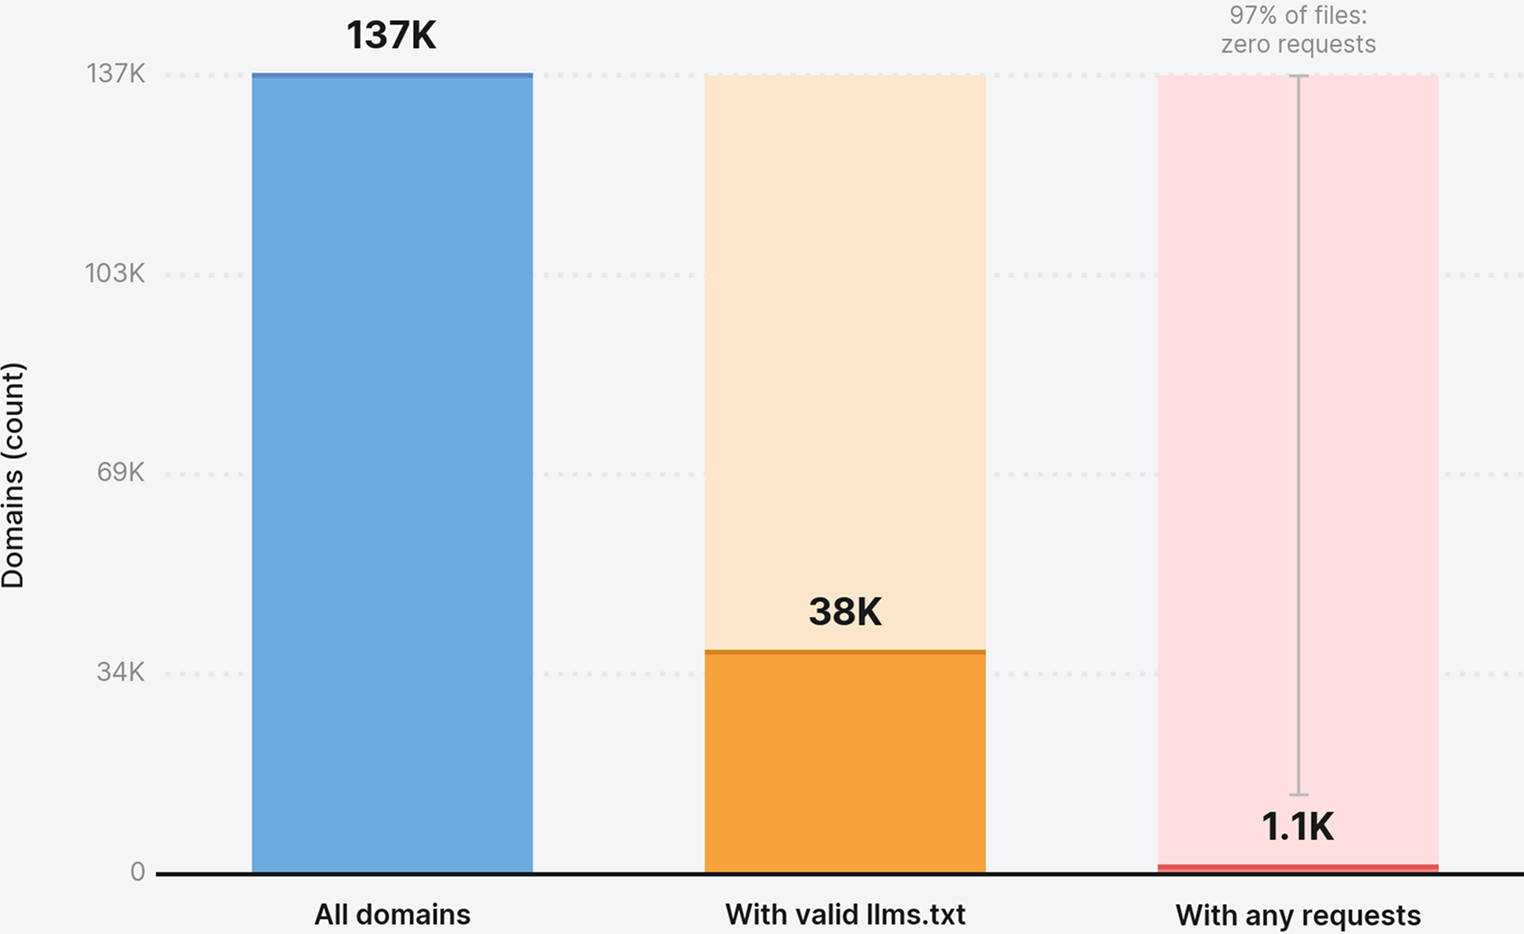
Nous avons vérifié ce qui se passe réellement lorsqu’un site web ajoute un fichier llms.txt. Sur 137 000 domaines utilisant Ahrefs Web Analytics, 28 % publient un fichier llms.txt. Sur les ~ 38 000 qui en ont un valide, 97 % n’ont reçu aucune requête pour celui-ci durant le mois que nous avons mesuré.
97 % des fichiers llms.txt ne sont jamais demandés
Étude d’Ahrefs portant sur 137 000 domaines avec Ahrefs Web Analytics.
Parmi la faible part de fichiers qui ont tout de même été récupérés, 96 % des requêtes provenaient de bots. Slackbot, le bot d’aperçu des liens, a récupéré des fichiers llms.txt plus souvent que PerplexityBot. En clair, les moteurs de recherche IA les plus importants ne semblent pas l’utiliser.
Google a été très clair à ce sujet. Son guide sur l’optimisation pour les fonctionnalités d’IA générative comporte une section intitulée littéralement « Lutter contre les idées reçues », qui explique aux propriétaires de sites que les fichiers lisibles par les machines comme llms.txt ne sont pas nécessaires pour apparaître dans la recherche basée sur l’IA générative. John Mueller est allé plus loin, en comparant cela à l’ancienne balise meta keywords :

À ma connaissance, aucun des services d’IA n’a dit qu’il utilisait LLMs.TXT (et vous pouvez voir, en consultant vos journaux de serveur, qu’ils ne le vérifient même pas). Pour moi, c’est comparable à la balise meta keywords : c’est ce qu’un propriétaire de site affirme à propos de son site… (Le site est-il vraiment comme ça ? Eh bien, vous pouvez le vérifier. À ce stade, pourquoi ne pas simplement vérifier le site directement ?)
John Mueller, Search Advocate, Google
Alors, faut-il en créer une ? Si vous publiez de la documentation pour développeurs, cela prend environ dix minutes et il existe un cas d’usage plausible. Mueller l’a décrit comme une « béquille temporaire, peut-être pour économiser des jetons » pour les outils de codage IA qui analysent la documention. Pour tous les autres, il s’agit d’un effort sans retour mesuré, avec toutefois un petit inconvénient : votre contenu devient plus facile à récupérer intégralement par vos concurrents.
Corrigez les URL que l’IA hallucine à propos de votre site
Les assistants IA inventent des liens vers votre site web, et ils le font souvent. Nous avons vérifié le statut HTTP de 16 millions d’URL citées par ChatGPT, Perplexity, Copilot, Gemini, Claude et Mistral, et nous avons constaté que les assistants IA envoient des visiteurs vers des pages 404 2,87 fois plus souvent que la recherche Google.
ChatGPT est de loin celui qui commet le plus d’erreurs. 1,01 % de ses URL cliquées renvoient vers une erreur 404, contre 0,15 % pour la référence Google.
Taux de 404 par canal référent
Données de Web Analytics : 16 000 000 d’URL analysées.
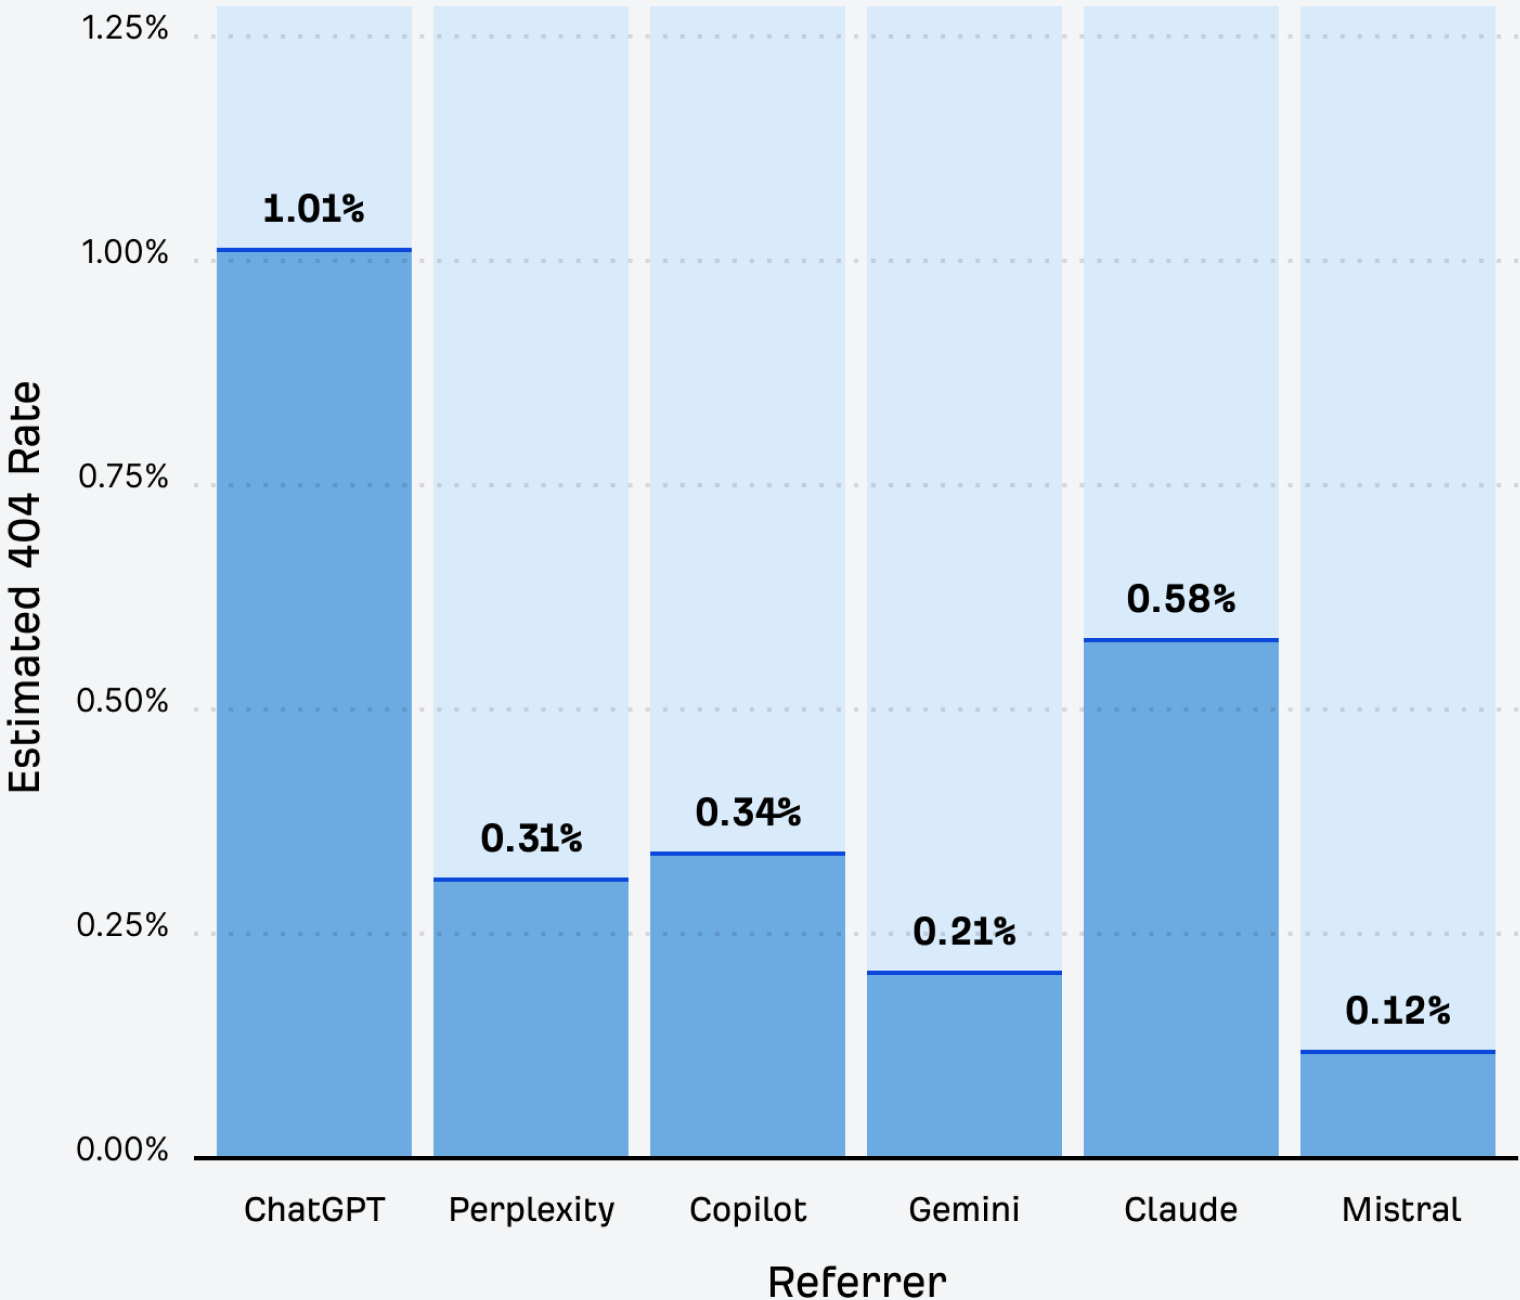
Perplexity (0,87 %) et Gemini (0,86 %) se situent presque exactement au niveau du taux de 0,84 % de Google pour les URL citées. C’est logique, puisque tous deux récupèrent des données depuis l’index de Google : ils héritent donc de ses liens brisés au lieu d’inventer les leurs.
Les URL inventées sont déduites de vos schémas existants. L’une des URL fréquemment hallucinées pour notre site était ahrefs.com/keywords, parce que nous parlons constamment de mots-clés et que le modèle a supposé qu’une page consacrée à ce sujet devait exister. Ce n’est pas le cas.
C’est l’un des rares avantages vraiment gratuits en AEO. Une personne avec une intention réelle a posé une question sur votre produit, a été dirigée vers votre site… et s’est retrouvée dans une impasse. Vous rencontrerez trois types différents :
- URL hallucinées : des pages inventées par un modèle à partir de la structure de vos URL.
- URL obsolètes : des pages qui ont existé autrefois, conservées en mémoire via les données d’entraînement ou d’autres sources de données obsolètes.
- URL mal orthographiées ou variantes : des URL presque identiques à celles des pages réelles.
C’est pourquoi nous avons ajouté un filtre à Web Analytics qui vous aidera à trouver des URL hallucinées en seulement deux clics. Si vous cherchez une alternative simple à Google Analytics, gratuite jusqu’à 1 million d’événements par mois, allez y jeter un œil :
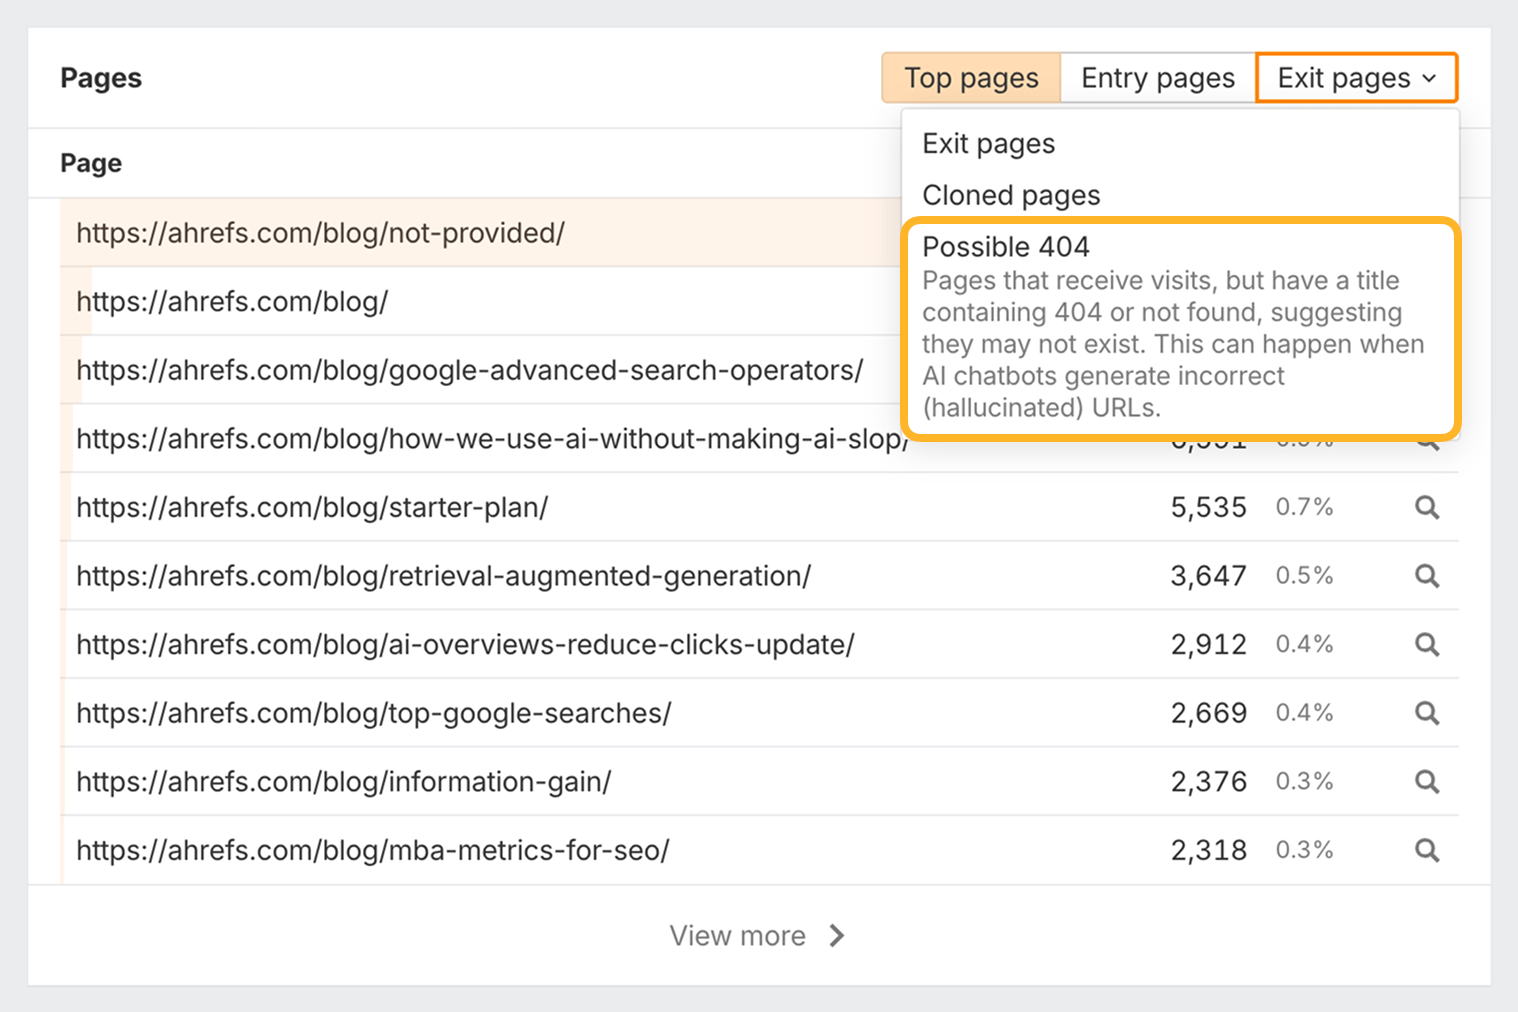
Si une URL hallucinée continue d’être demandée, le modèle vous indique quelle page vos visiteurs s’attendent à trouver sur votre site.
Devenez une entité reconnue
Chaque tactique de ce guide dépend au final d’une seule chose : la question de savoir si les systèmes d’IA reconnaissent votre marque comme une entité distincte.
Le saviez-vous ?
Une entité est toute chose distincte du monde réel qu’un moteur de recherche ou l’IA peut reconnaître et distinguer de tout le reste : une personne, un lieu, une entreprise, un produit ou un concept précis (comme « Dmytro Gerasymenko », « Ahrefs » ou « Singapour ») ; plutôt que les simples mots utilisés pour la décrire.
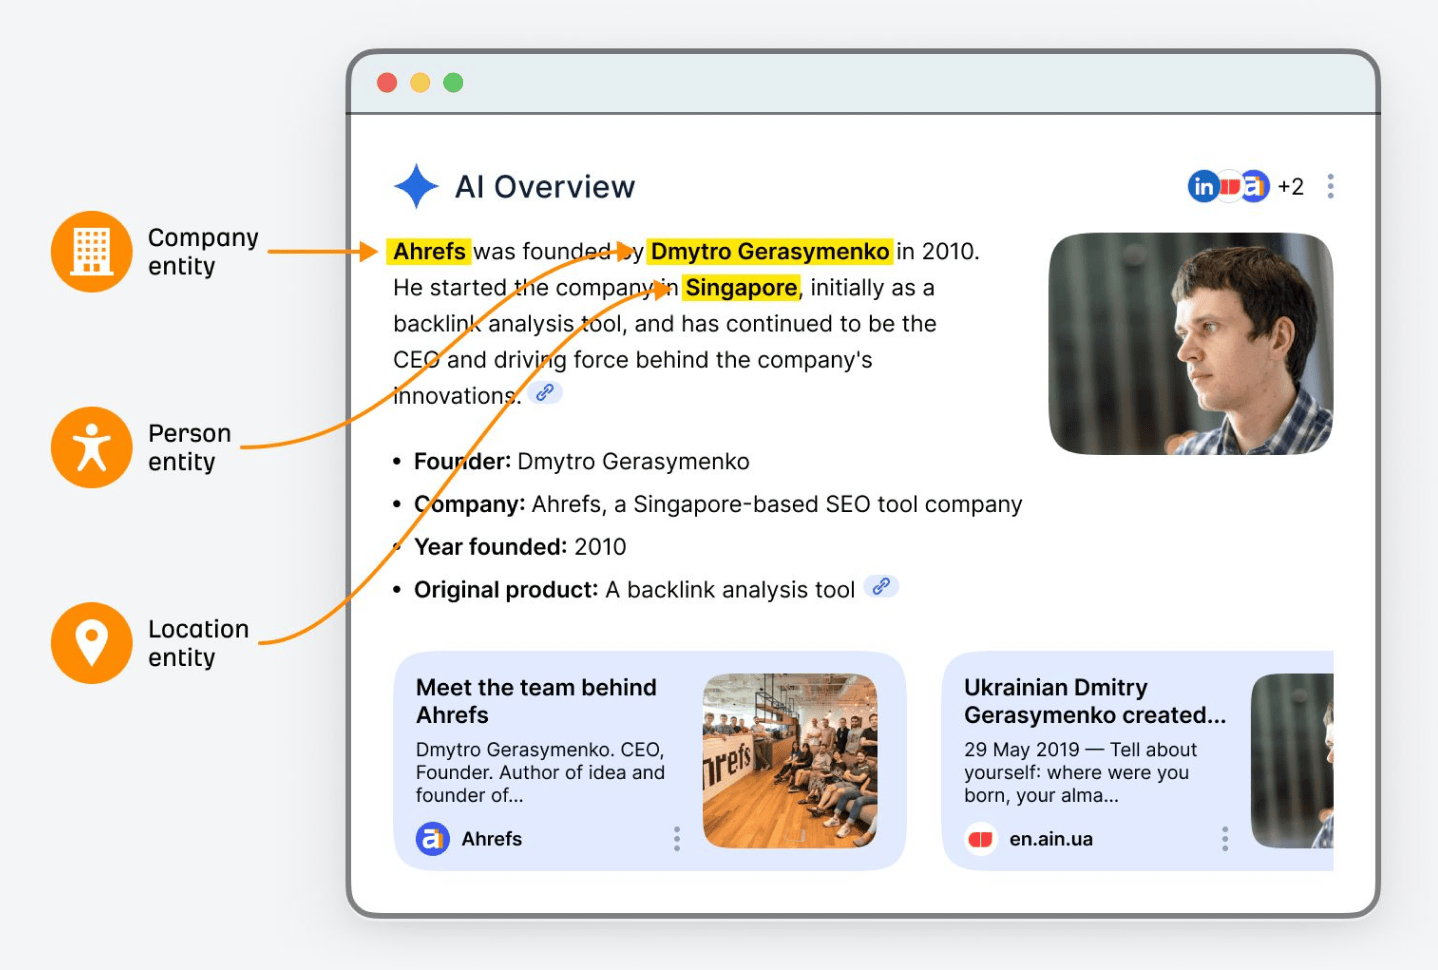
Le Knowledge Graph de Google, une base de données de 54 milliards d’entités et de plus de 1,6 billion de faits sur leurs relations, ne constitue plus simplement le moteur des Knowledge Panels.
Il s’agit désormais de l’infrastructure principale pour les AI Overviews, le Mode IA et Gemini.
Si votre marque n’est pas clairement établie en tant qu’entité, avec des signaux cohérents sur votre site, des données structurées et des sources tierces faisant autorité, vous risquez d’être invisible dans les réponses de l’IA, et pas seulement dans les liens bleus.
Le balisage Schéma est souvent présenté comme un moyen rapide d’améliorer la visibilité IA, et la corrélation apparente semble convaincante : les pages citées par l’IA sont presque trois fois plus susceptibles d’utiliser du JSON-LD.
Le balisage schéma est bien plus fréquent sur les pages citées par l’IA
Étude d’Ahrefs sur 6 M de pages (2 M de pages par groupe).
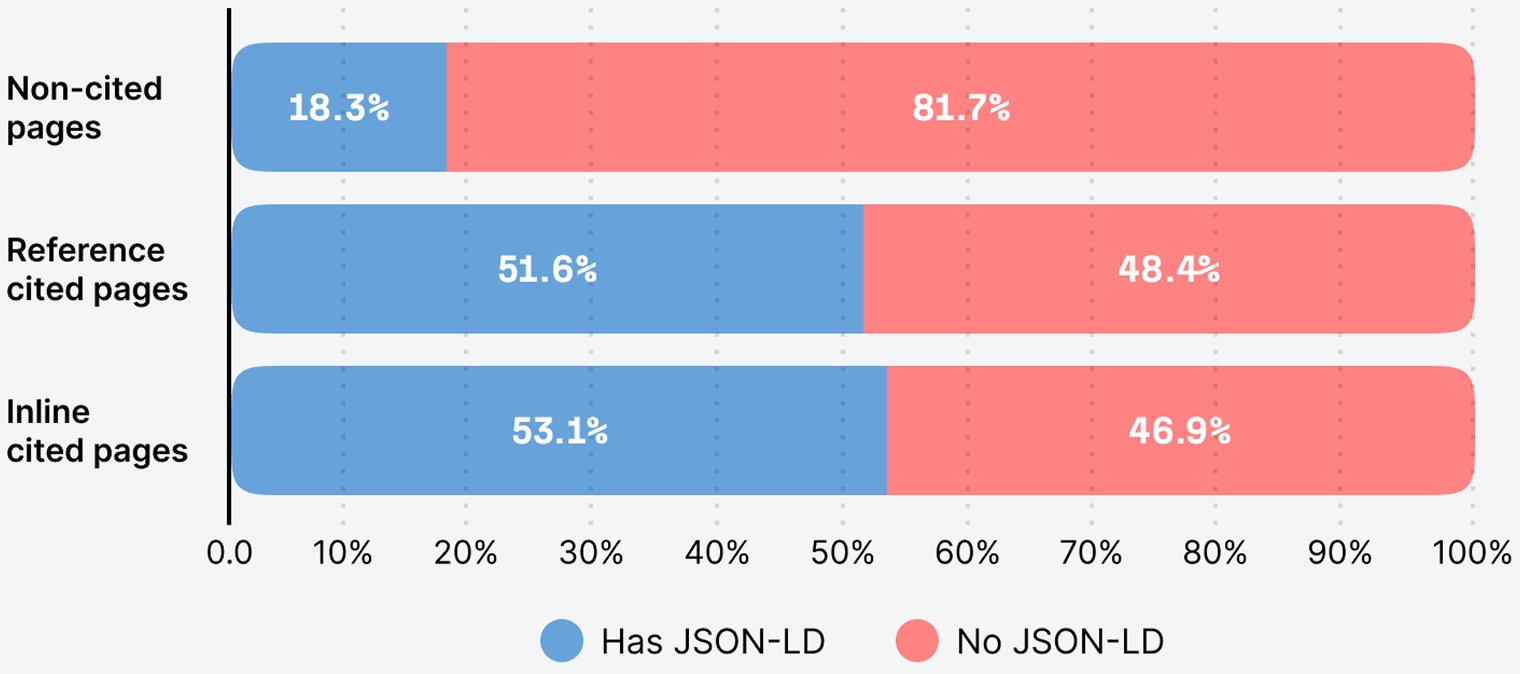
Cependant, corrélation ne veut pas dire causalité. Nous avons suivi 1 885 pages ayant ajouté du JSON-LD par rapport à 4 000 pages témoins et n’avons constaté aucune amélioration significative dans le Mode IA ou ChatGPT. Il y avait également une légère baisse dans l’AI Overview que nous n’avons pas pu attribuer au schéma.
Alors, le balisage schéma est-il inutile ? Non, mais son rôle est lent et indirect, ce n’est pas une tactique de gain rapide.
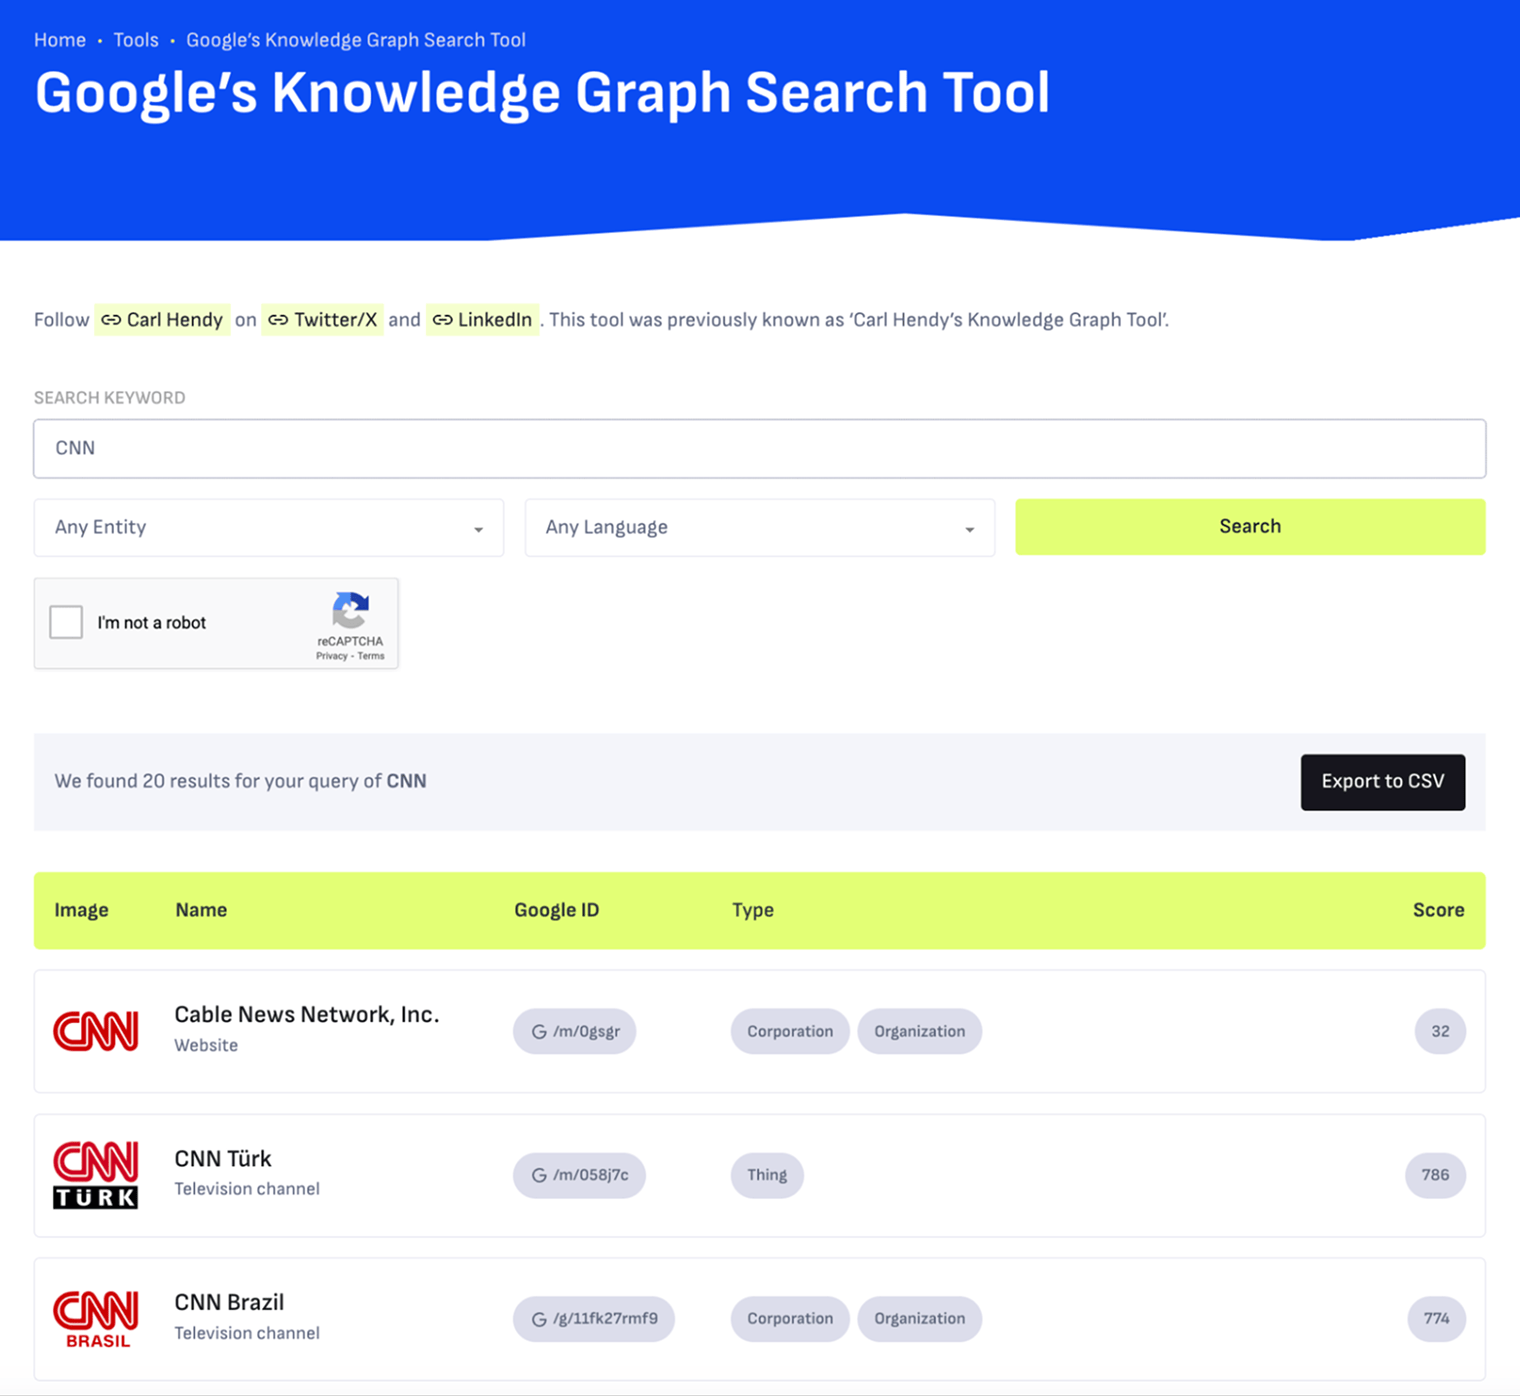
Vous pouvez vérifier si Google vous reconnaît déjà via l’API Knowledge Graph de Google ou un vérificateur gratuit afin de voir quel type d’entité il vous a attribué et si les attributs sont corrects.
Par exemple, Knowledge Graph Tool de Carl Hendy vous montre des résultats pour les personnes, les entreprises, les produits, les lieux et d’autres entités.
Essayez ensuite d’obtenir des mentions de publications faisant autorité et veillez à garder vos informations cohérentes partout : le même nom, la même description et la même catégorie sur votre site, vos profils et les annuaires tiers.
Ajoutez ensuite du schéma là où c’est pertinent, en privilégiant les types qui définissent votre entité et ses relations :
Schéma Organization et sameAs menant à vos profils Wikipédia, Wikidata et sur les réseaux sociaux
Schéma Person pour les auteurs de votre site
Schéma Product pour vos offres
Astuce
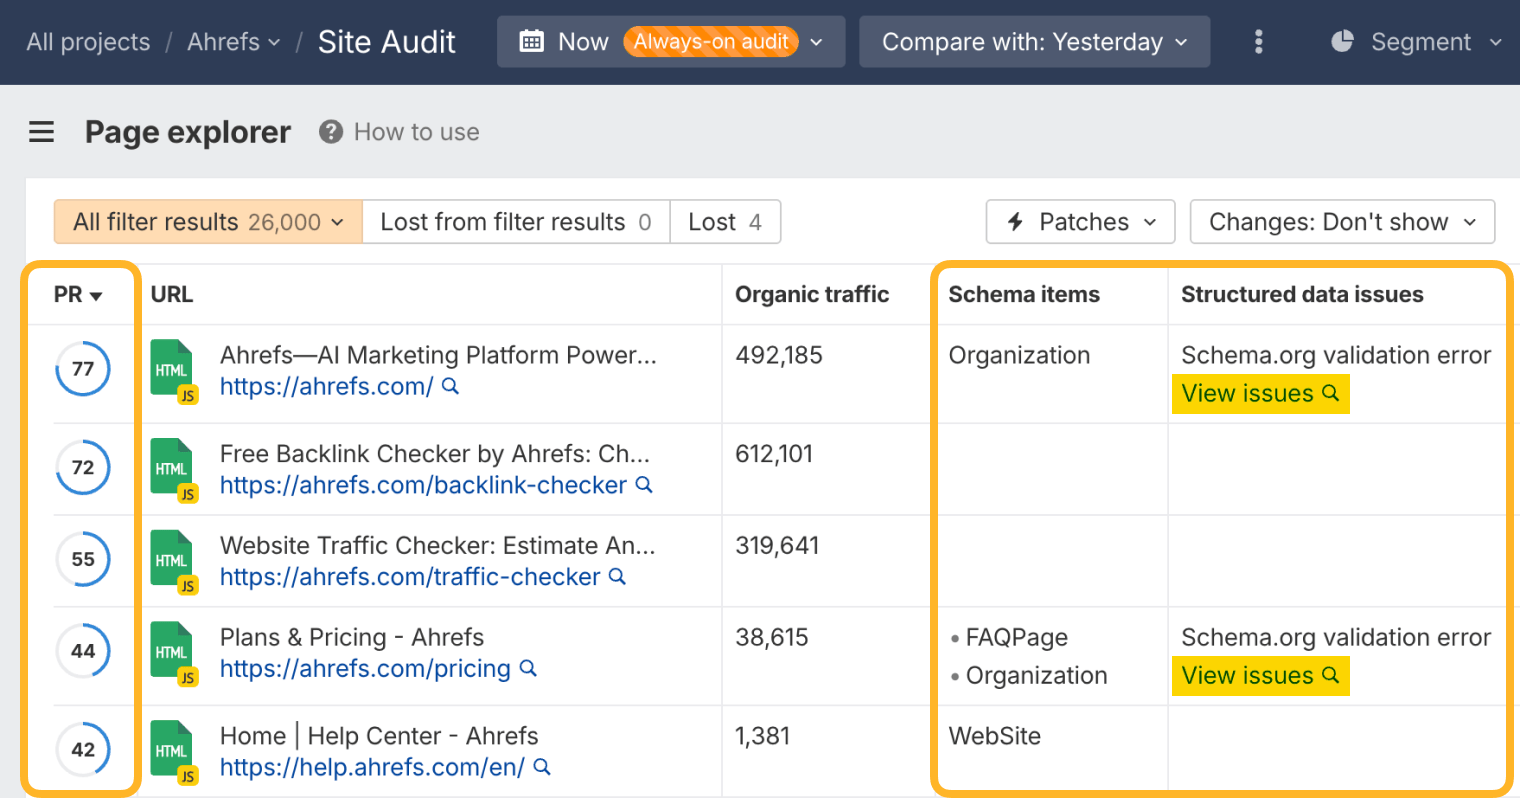
Trouvez vos pages avec la plus forte autorité et assurez-vous qu’elles contiennent un balisage schéma propre.
Pour cela, accédez au rapport Explorateur de pages dans Site Audit, puis triez par « Page Rating ».
La métrique Page Rating (PR) indique la force du profil de backlinks interne et externe de votre URL par rapport aux autres URL incluses dans votre exploration du web.
Puis cochez la colonne « Éléments de schéma » pour auditer votre schéma existant, et la colonne « Problèmes de données structurées » pour repérer les données structurées manquantes ou non valides.
Préparez-vous au marketing d’agent à agent
Je vous laisse sur cette dernière réflexion : un nombre croissant de « lecteurs » que vous cherchez à influencer sont en réalité des agents IA qui naviguent et achètent au nom de votre public.
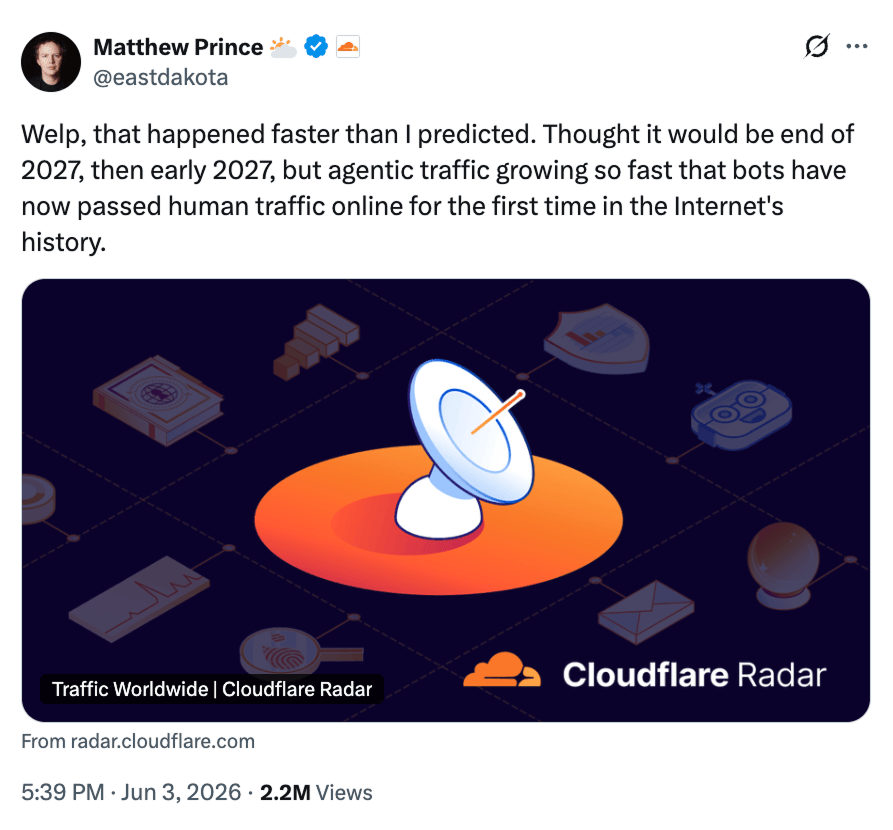
En juin 2026, le CEO de Cloudflare, Matthew Prince, a révélé que le trafic agentique (bot/crawler/agent) avait dépassé pour la première fois la barre des 50 % dans l’histoire d’Internet.2, 3
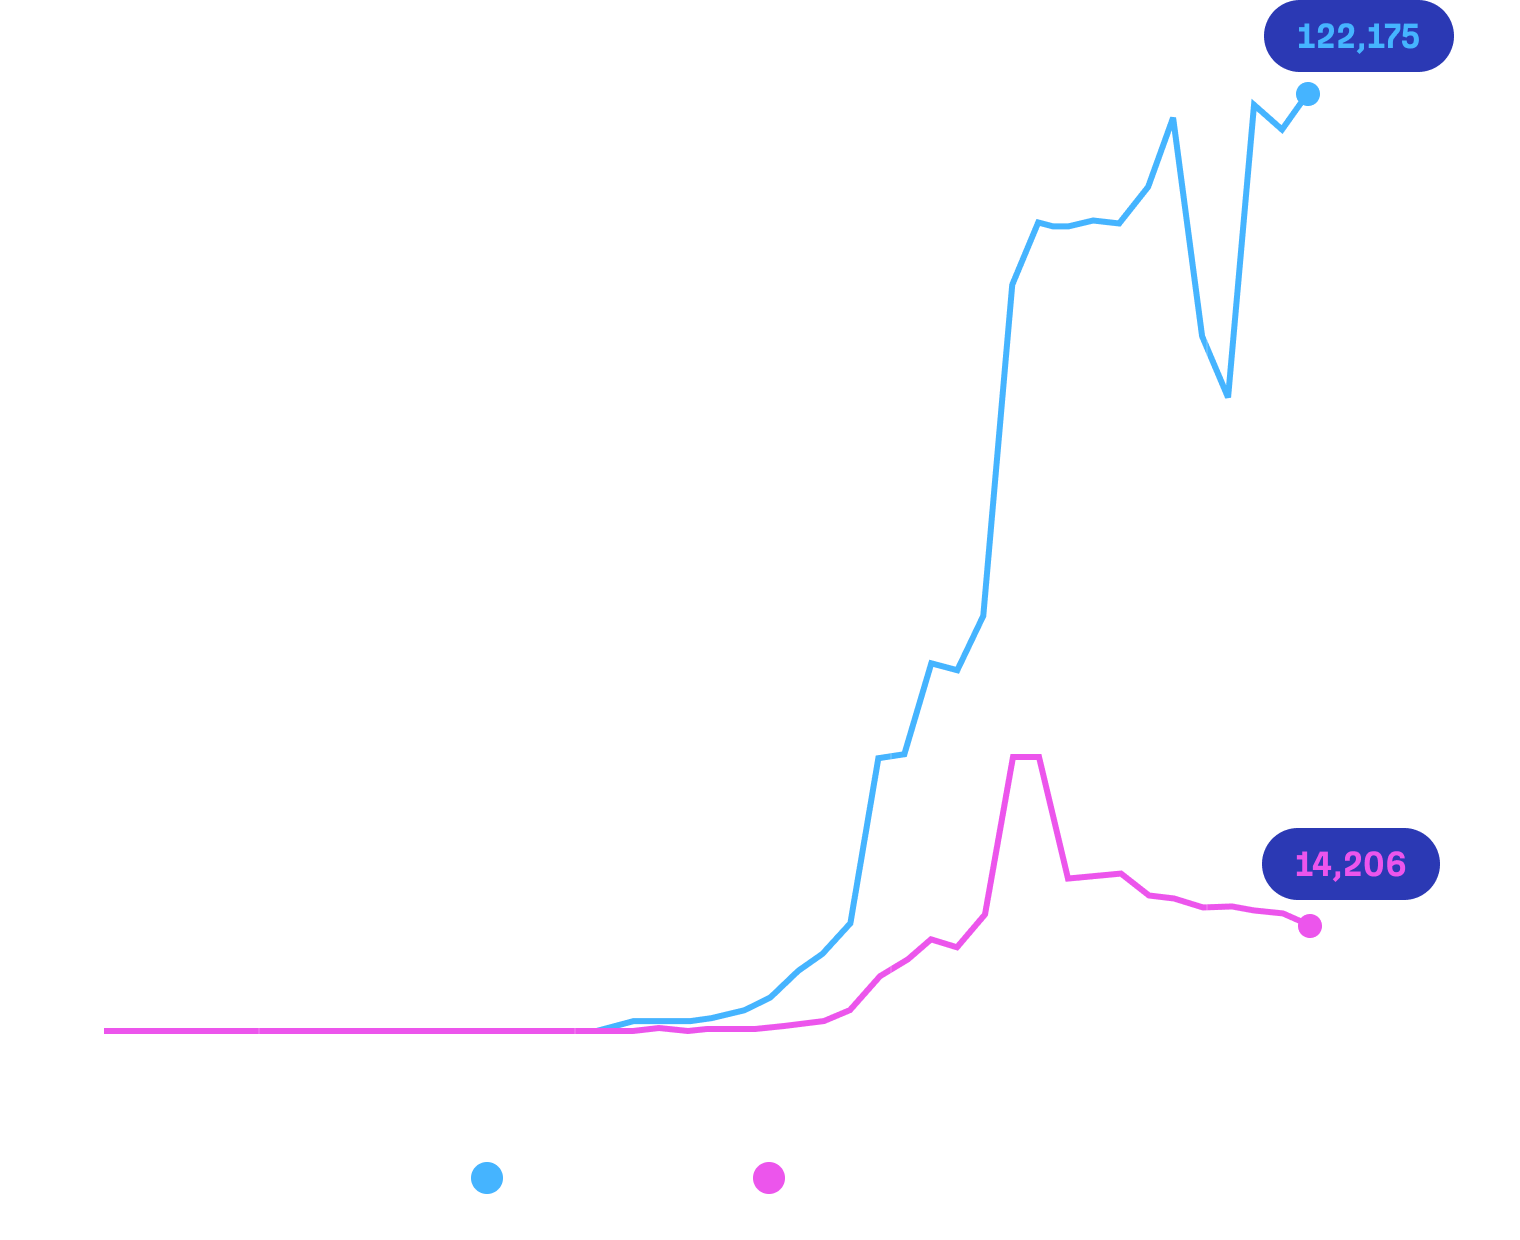
Loin d’être un cas marginal ou une nouveauté, les recherches sur « l’IA agentique » ont été multipliées par 84 en trois ans, tandis que le coût d’exécution d’un agent a chuté de quelques dollars à quelques centimes.
Pour aller plus loin
Vous n’avez pas encore besoin de repenser votre site web uniquement pour les agents IA. Cependant, l’ancien conseil consistant à créer du contenu uniquement pour les internautes sans se soucier des robots tient probablement un peu moins la route qu’avant.
Ce chapitre porte sur l’influence de l’IA à laquelle l’humain fait confiance, et le marketing d’agent à agent, c’est justement ça ; en allant un cran plus loin.
Références
- « ChatGPT est un moteur de recherche. Voici son fonctionnement. » David McSweeney, QueryBurst.
- Matthew Prince (@eastdakota) sur X. 3 juin 2026.
Louise est spécialiste en marketing de contenu chez Ahrefs. Au cours des dix dernières années, elle a occupé des postes seniors dans le domaine du contenu au sein de marques SaaS : Pi Datametrics, BuzzSumo et Cision. Durant cette période, elle a publié des centaines d’articles de blog, mené des recherches de référence dans le secteur et développé des programmes de webinaires animés par des experts.
Louise a d’abord appris les bases du SEO lors de son passage chez Pi, une société spécialisée dans le SEO pour grandes entreprises. Quelques semaines après son arrivée, elle avait publié un article sur la cannibalisation qui a attiré l’attention de la plus grande figure du SEO à l’époque : Rand Fishkin. Depuis, elle a écrit sur des sujets allant du netlinking manipulateur à la syndication de contenu, en passant par la prévision de la demande de recherche. Pendant son temps libre, elle a approfondi sa compréhension pratique du SEO en créant des sites web pour deux entreprises locales.
Vous pouvez lire les propos de Louise dans des publications du secteur comme Search Engine Watch, The Drum, The Telegraph et Spin Sucks.
Explorer tous les guides sur l’AEO
Qu’est-ce que l’AEO (Answer Engine Optimization) ?
Commencez ici : définition de l’AEO, sa différence avec le SEO et les sept étapes pour démarrer.
Comment fonctionnent les moteurs de réponse ?
Ce qui se passe réellement entre un prompt et une réponse ; et à quel moment votre marque peut entrer dans le processus.
Comment suivre la visibilité IA ?
Vous ne pouvez pas optimiser ce que vous ne voyez pas. Voici sept façons de mesurer la présence de votre marque dans les réponses de l’IA.
Comment choisir les meilleurs prompts à suivre ?
Suivez des groupes de prompts, et non des réponses ponctuelles. Onze sources où trouver les requêtes qui valent la peine d’être surveillées.
Comment optimiser votre contenu pour les moteurs de réponse ?
Un bon classement vous permet d’être pris en considération. Voici comment vous faire citer : les sujets, les formats et les modifications on-page qui fonctionnent.
Comment surveiller et obtenir des mentions de marque dans les réponses de l’IA ?
L’IA recommande les marques dont elle a entendu parler sur d’autres sites. Voici comment surveiller ces mentions et en obtenir davantage.
Comment optimiser votre site web pour les moteurs de réponse ?
Les correctifs techniques qui déterminent si l’IA peut atteindre vos pages, les lire et comprendre qui vous êtes.