


So optimierst du deine Website für Antwortmaschinen
Nach Autor Louise Linehan
Content-Marketer bei Ahrefs
Dein Content kann großartig sein und trotzdem nie in einer KI-Antwort auftauchen.
Jede KI-Optimierungstaktik setzt voraus, dass KI-Systeme deine Seiten erreichen, sie lesen und herausfinden können, wer du bist. Nichts davon ist selbstverständlich. Rund 5,89 % der Websites blockieren GPTBot vollständig, ChatGPT scheint Seiten abzubrechen, die länger als etwa zwei Sekunden zum Antworten brauchen, und die meisten KI-Crawler führen überhaupt kein JavaScript aus.
Die gute Nachricht: Das ist der am leichtesten zu behebende Teil von AEO. Nichts davon bringt dir allein schon ein Zitat, aber jedes einzelne dieser Probleme kann dich still und leise jedes Zitat kosten, das du sonst bekommen hättest.
Lerne auf YouTube weiter
Blockiere KI-Crawler nicht in der robots.txt
Keiner der Tipps in diesem Guide bringt etwas, wenn KI-Crawler deine Seiten nicht lesen können. Blockierte Seiten können nicht zitiert werden – und das passiert oft aus Versehen.
Wir haben rund 140 Millionen Websites analysiert und festgestellt: GPTBot ist inzwischen der am häufigsten blockierte KI-Bot (5,89 % der Websites), dicht gefolgt von ClaudeBot.
Cloudflare blockiert KI-Plattformen standardmäßig – prüfe also, ob dein CDN dich nicht stillschweigend ausgeschlossen hat.
„KI-Crawler zulassen“ ist keine einzelne Entscheidung, denn jede Plattform betreibt mehrere Bots, die unterschiedliche Aufgaben erledigen.
Allein OpenAI betreibt drei:
- GPTBot sammelt Inhalte fürs Training
- OAI-SearchBot erstellt den Suchindex, aus dem ChatGPT Ergebnisse abruft
- ChatGPT-User ruft eine Seite live ab, wenn jemand mitten im Gespräch danach fragt
Die Trade-offs sind bei beiden unterschiedlich. Wenn du GPTBot blockierst, landet dein Content nicht in den Trainingsdaten des nächsten Modells – das ist die Entscheidung, die Publisher normalerweise abwägen. Wenn du OAI-SearchBot blockierst, verschwindest du aus dem Index, in dem ChatGPT sucht – und das kostet dich heute Zitate und Referral-Traffic. Viele Websites blockieren das zweite aus Versehen, obwohl sie eigentlich nur das erste wollten.
Am schnellsten siehst du, wo du stehst, mit einem Tool wie dem KI-Crawler-Access-Checker: Es liest deine robots.txt und zeigt dir, welche Crawler durchgelassen werden.
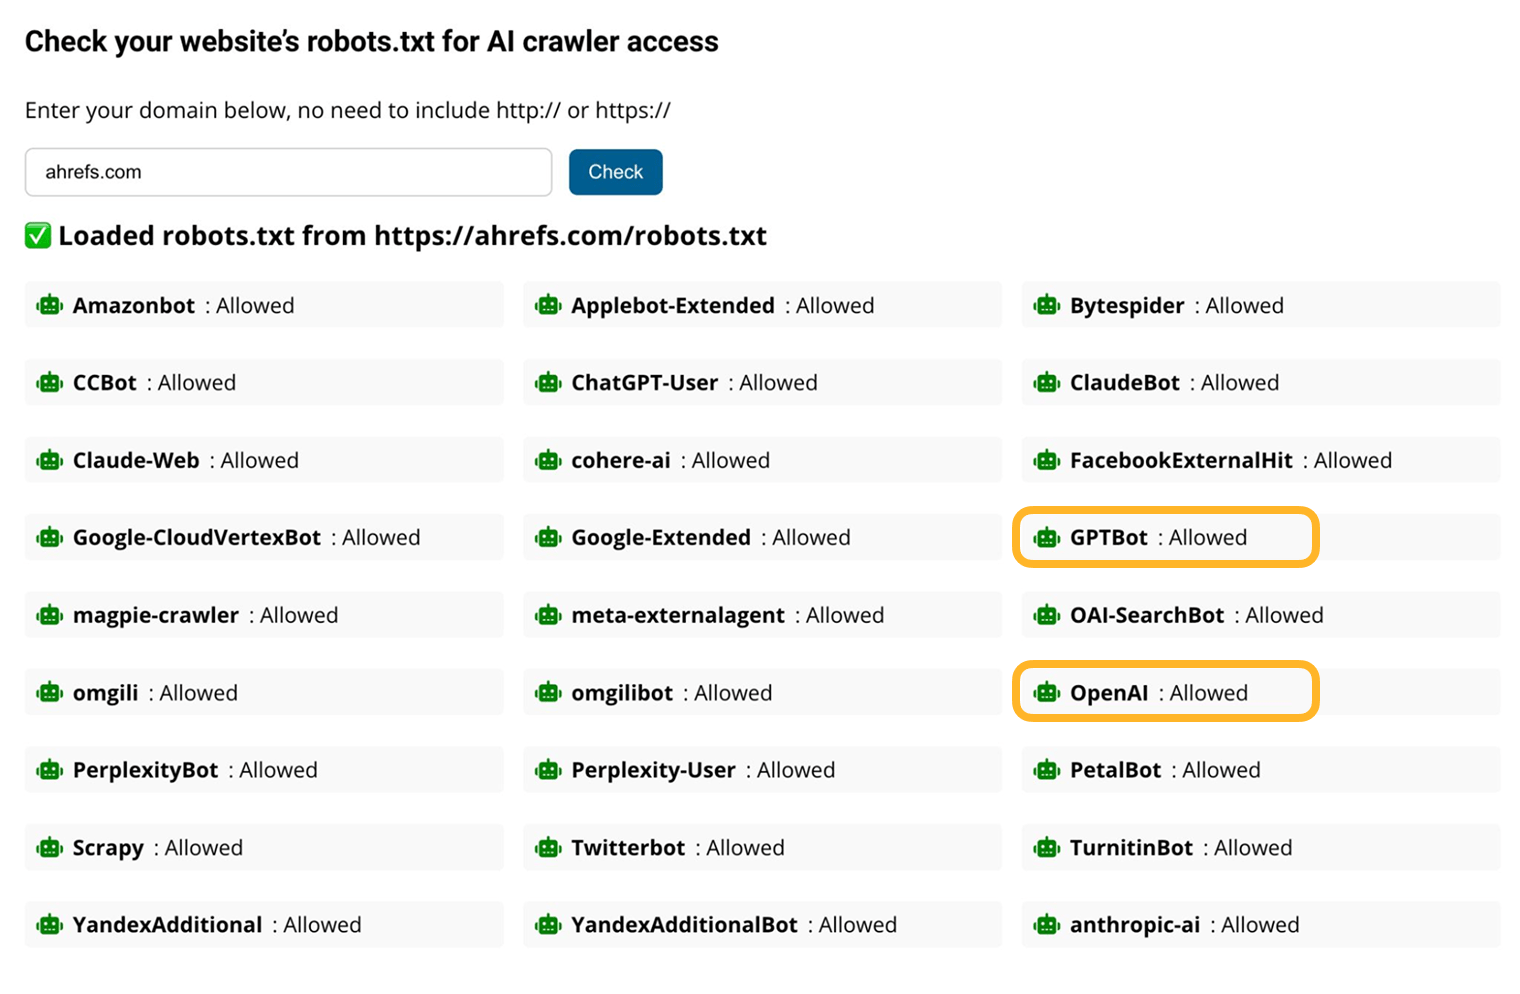
Um zu sehen, welche Bots tatsächlich auftauchen (statt nur, welche erlaubt sind), sieh dir Ahrefs’ Bot Analytics an. Es trackt Besuche in 12 Bot-Kategorien, inklusive eines eigenen KI-Filters, anhand serverseitiger Daten über Cloudflare – und funktioniert, ohne dass du JavaScript zu deiner Website hinzufügen musst.
Verstecke Inhalte nicht hinter umfangreichem JavaScript
KI-Crawler lesen meist das rohe HTML und rendern JavaScript größtenteils nicht so, wie es ein Browser tut.
Das bedeutet, dass alles, was erst nach clientseitigem JS erscheint, für sie unsichtbar sein kann.
Geh auf Nummer sicher und setze auf serverseitiges Rendering, damit deine Seite die bestmögliche Chance auf KI-Sichtbarkeit hat.
Verbessere deine Page Speed
Langsam ladende Seiten können deine Performance in der klassischen Suche negativ beeinflussen, aber wenn überhaupt, scheint die Strafe in Answer Engines sogar noch größer zu sein. Page Speed scheint mitzuentscheiden, ob du überhaupt im Kontextfenster des Modells landest.1
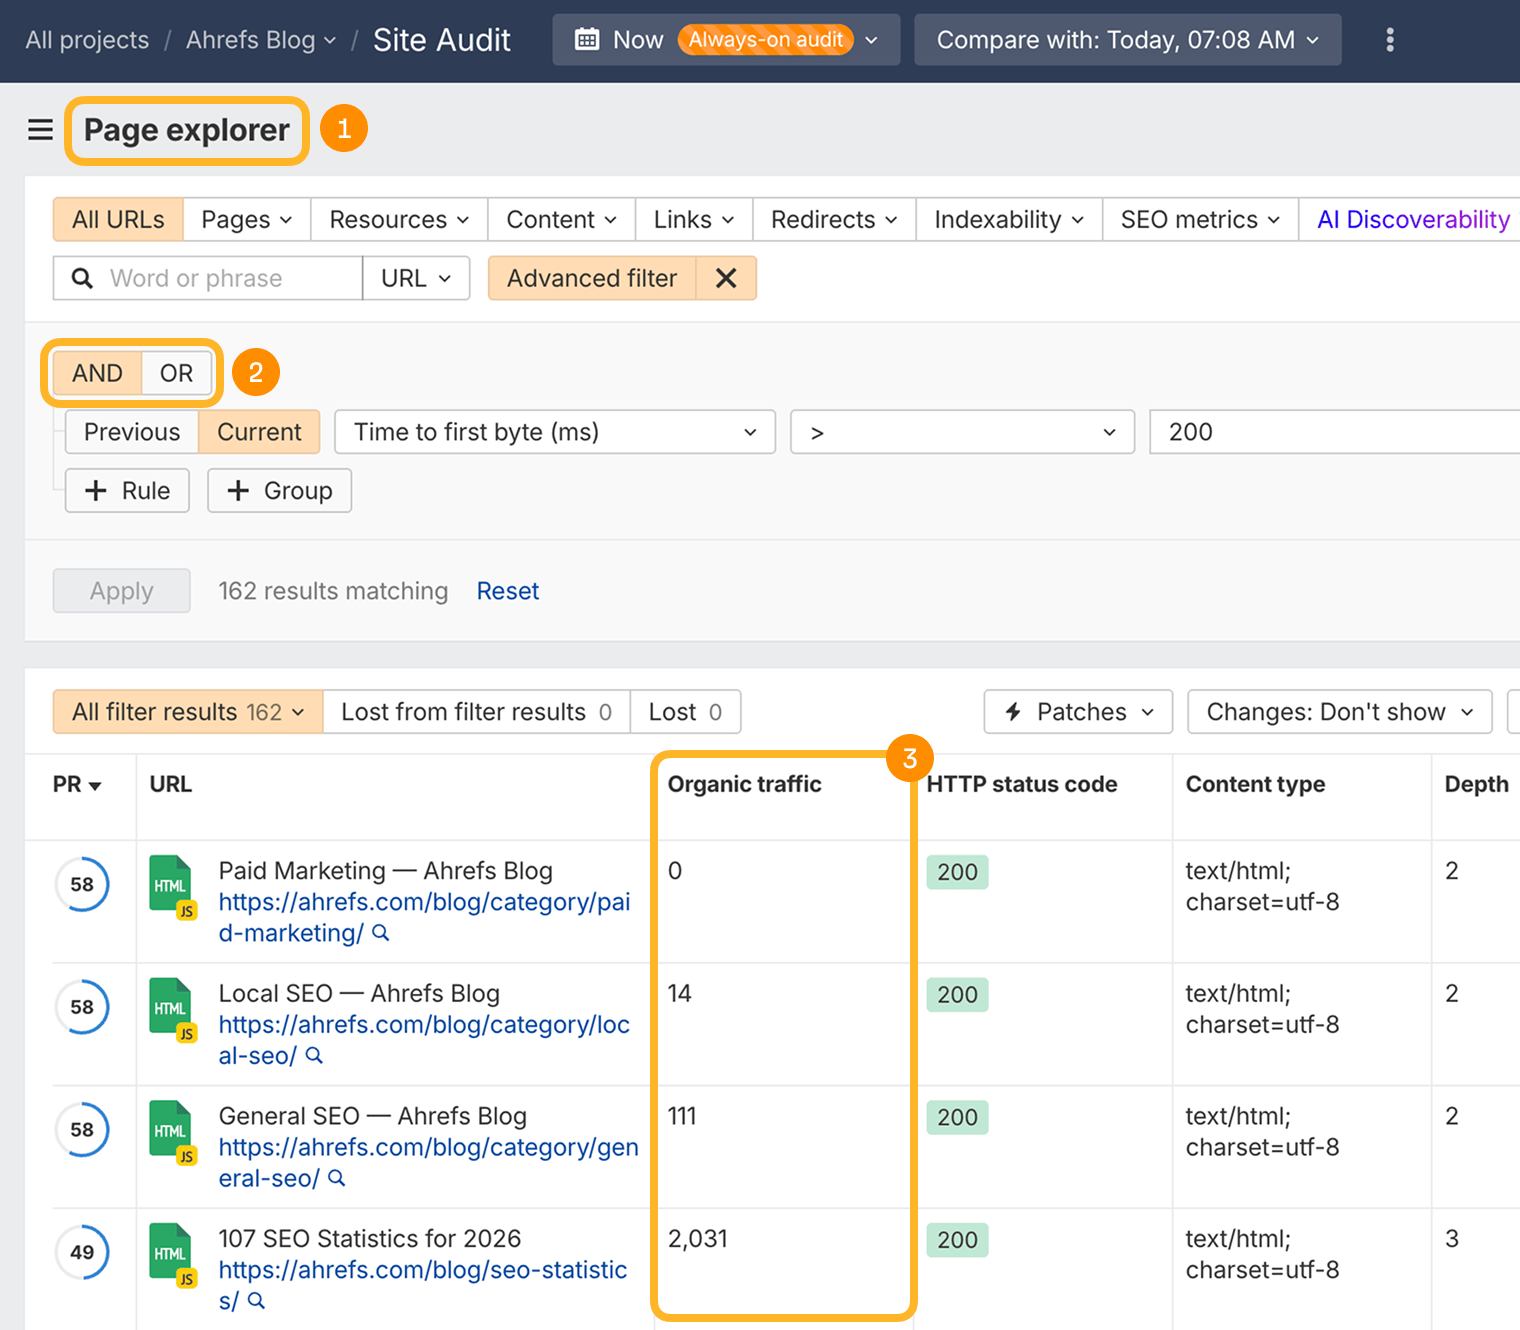
Prüfe deinen Page Speed (auch bekannt als Time-to-First-Byte) in Site Audit:
Mach dir keine Mühe mit llms.txt
llms.txt ist ein vorgeschlagener Standard für eine Markdown-Datei auf deiner Root-Domain (z. B. website.com/llms.txt), die LLMs zeigt, wo deine besten Inhalte zu finden sind: Dokumentation, Richtlinien, Produkt-Taxonomien. Im Prinzip ist es wie robots.txt für Sprachmodelle.
Aber in der Praxis hat sich kein großer LLM-Anbieter dazu verpflichtet, ihn zu lesen. Nicht OpenAI, nicht Anthropic, nicht Google.
Wir haben geprüft, was tatsächlich passiert, wenn eine Website llms.txt hinzufügt. Von 137.000 Domains, die Ahrefs Web Analytics nutzen, veröffentlichen 28% eine llms.txt-Datei. Von den ~38.000 mit einer gültigen Datei erhielten 97% im gemessenen Monat null Anfragen dafür.
97 % der llms.txt-Dateien werden nie abgerufen
Ahrefs-Studie mit 137.000 Domains unter Verwendung von Ahrefs Web Analytics.
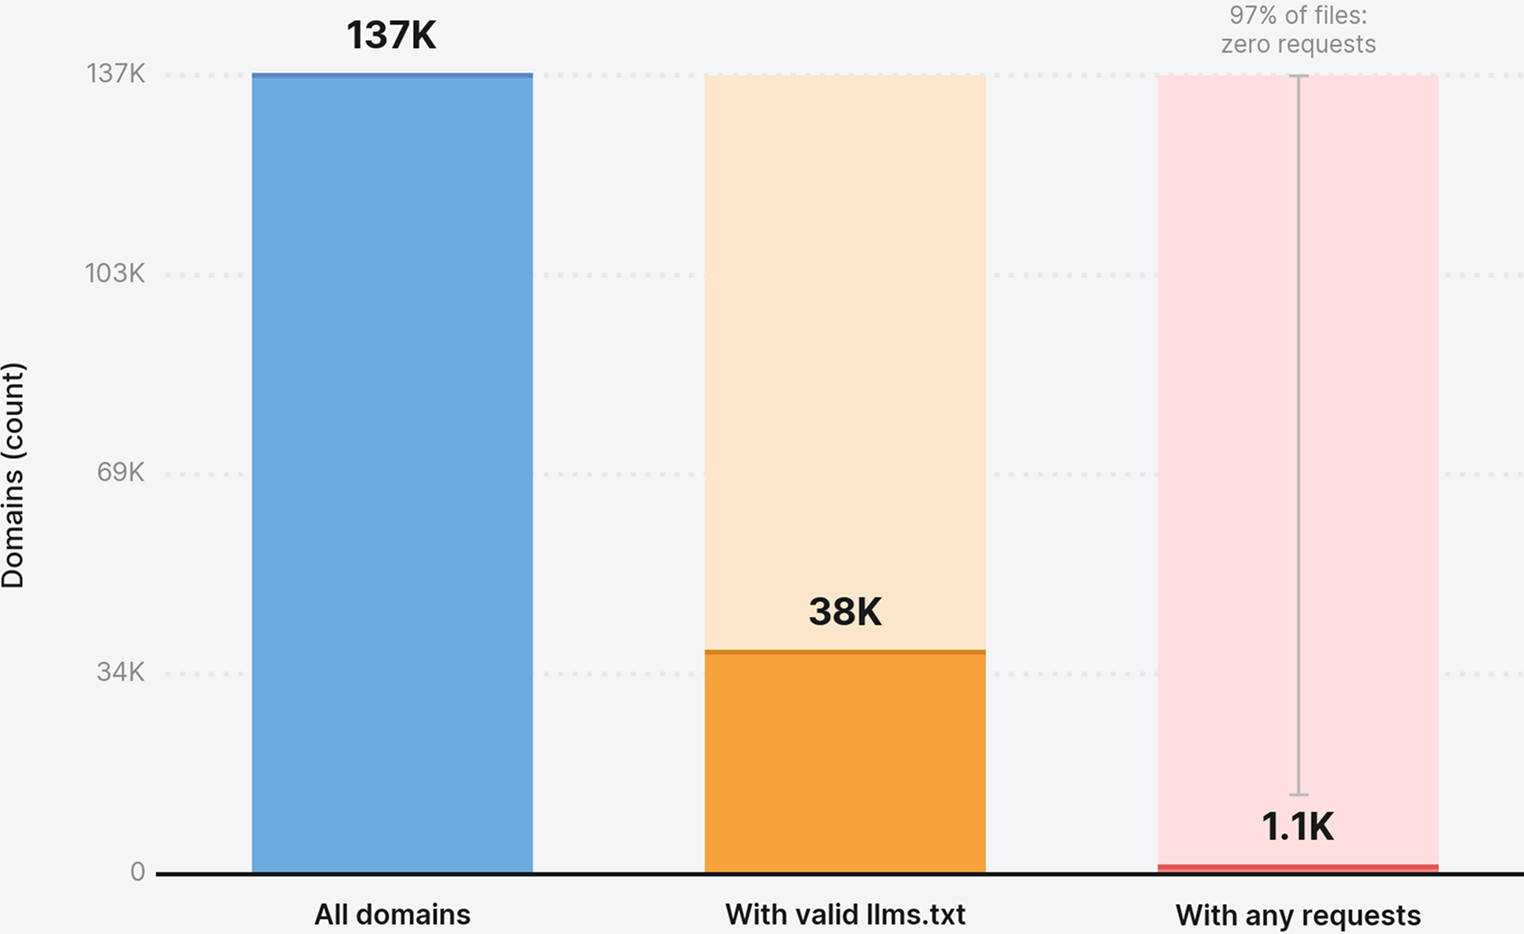
Von dem kleinen Anteil an Dateien, die tatsächlich abgerufen wurden, stammten 96 % der Requests von Bots. Slackbot, der Link-Preview-Bot, rief llms.txt häufiger ab als PerplexityBot. Kurz gesagt: Die wichtigsten KI-Suchmaschinen scheinen sie nicht zu verwenden.
Google ist dabei sehr eindeutig. In seinem Leitfaden zur Optimierung für generative KI-Features gibt es einen Abschnitt mit dem Titel „Mythbusting“, in dem Website-Betreibern erklärt wird, dass maschinenlesbare Dateien wie llms.txt nicht nötig sind, um in der generativen KI-Suche zu erscheinen. John Mueller ging noch weiter und verglich es mit dem alten Keywords-Meta-Tag:

Soweit ich weiß, hat keiner der KI-Services gesagt, dass er LLMs.TXT nutzt (und man sieht in den Server-Logs auch, dass sie nicht einmal danach suchen). Für mich ist das vergleichbar mit dem Keywords-Meta-Tag – das ist das, was ein Website-Betreiber behauptet, worum es auf seiner Seite geht … (Ist die Website wirklich so? Nun ja, das kann man prüfen. Und wenn man sowieso prüfen kann: Warum nicht einfach die Website direkt prüfen?)
John Mueller, Search Advocate, Google
Solltest du also eine erstellen? Wenn du Developer-Dokumentation veröffentlichst, kostet es etwa zehn Minuten und es gibt einen plausiblen Use Case. Mueller beschrieb es als „temporäre Krücke, vielleicht um ein paar Token zu sparen“ – für KI-Coding-Tools, die Docs parsen. Für alle anderen ist es Aufwand ohne messbaren Nutzen – plus ein kleiner Nachteil, weil du es Wettbewerbern leichter machst, deine Inhalte komplett zu scrapen.
Behebe die URLs, die die KI über deine Website halluziniert
KI-Assistenten denken sich Links zu deiner Website aus – und das ziemlich oft. Wir haben den HTTP-Status von 16 Millionen URLs geprüft, die von ChatGPT, Perplexity, Copilot, Gemini, Claude und Mistral zitiert werden, und festgestellt: KI-Assistenten schicken Besucher 2,87-mal häufiger auf 404-Seiten als die Google-Suche.
ChatGPT ist mit großem Abstand der schlimmste Übeltäter. 1,01 % seiner angeklickten URLs liefern einen 404 zurück, gegenüber einem Google-Basiswert von 0,15 %.
404-Raten nach Verweiskanal
Web-Analytics-Daten – 16.000.000 URLs analysiert.
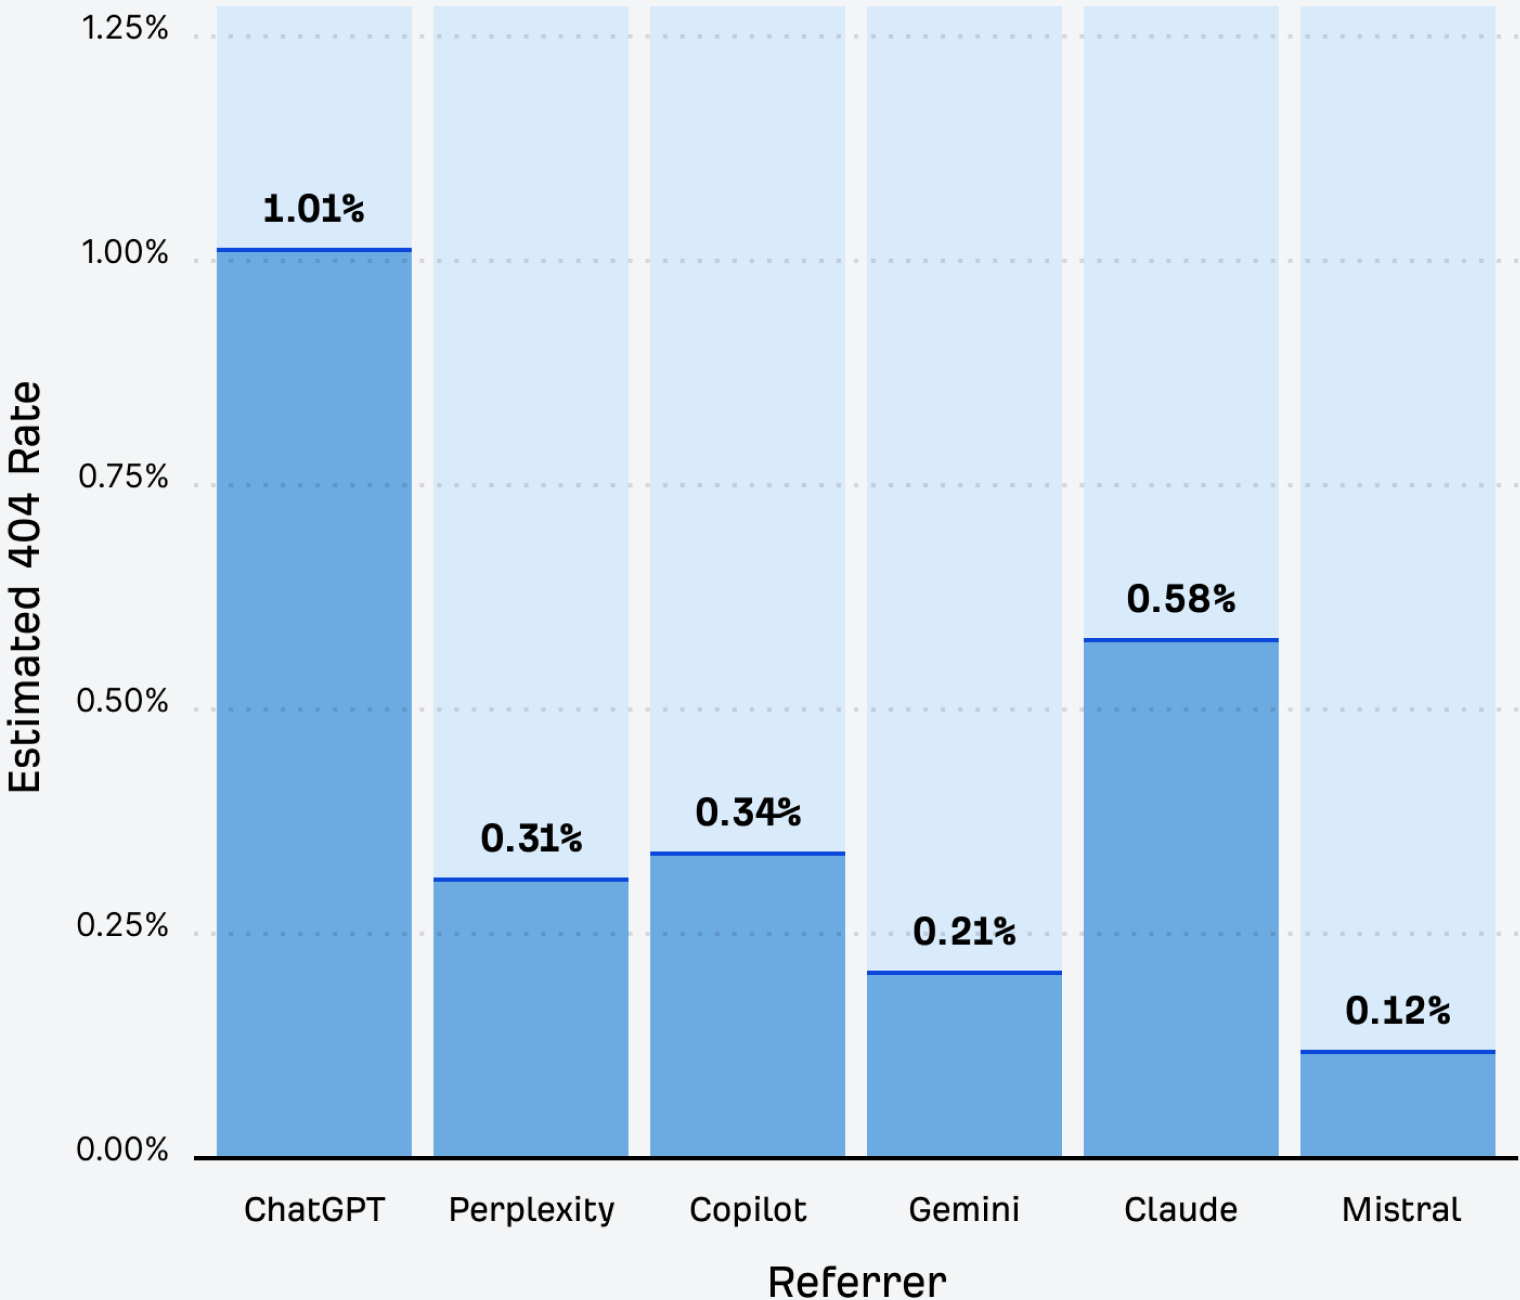
Perplexity (0,87%) und Gemini (0,86%) liegen fast exakt auf Googles eigener Rate von 0,84% für zitierte URLs. Das ergibt Sinn, da beide aus dem Google-Index abrufen und somit dessen defekte Links übernehmen, statt eigene zu erfinden.
Die erfundenen URLs werden aus deinen bestehenden Mustern abgeleitet. Eine häufig halluzinierte URL für unsere Website war ahrefs.com/keywords, weil wir ständig über Keywords schreiben und das Modell davon ausging, dass es so eine Seite geben muss. Gibt es nicht.
Das ist einer der wenigen wirklich kostenlosen Erfolge in AEO. Jemand mit echter Absicht hat nach deinem Produkt gefragt, wurde auf deine Website geschickt und ist dort in einer Sackgasse gelandet. Du wirst drei unterschiedliche Typen sehen:
- Halluzinierte URLs. Seiten, die ein Modell aus deiner URL-Struktur erfunden hat.
- Veraltete URLs. Seiten, die es früher einmal gab und die aus Trainingsdaten oder anderen veralteten Datenquellen „in Erinnerung“ geblieben sind.
- Falsch geschriebene oder abgewandelte URLs. Beinahe-Treffer auf echten Seiten.
Deshalb haben wir Web Analytics einen Filter hinzugefügt, mit dem du halluzinierte URLs in nur zwei Klicks findest. Wenn du nach einer einfachen Google-Analytics-Alternative suchst, kostenlos für bis zu 1 Million Events pro Monat, schau es dir an:
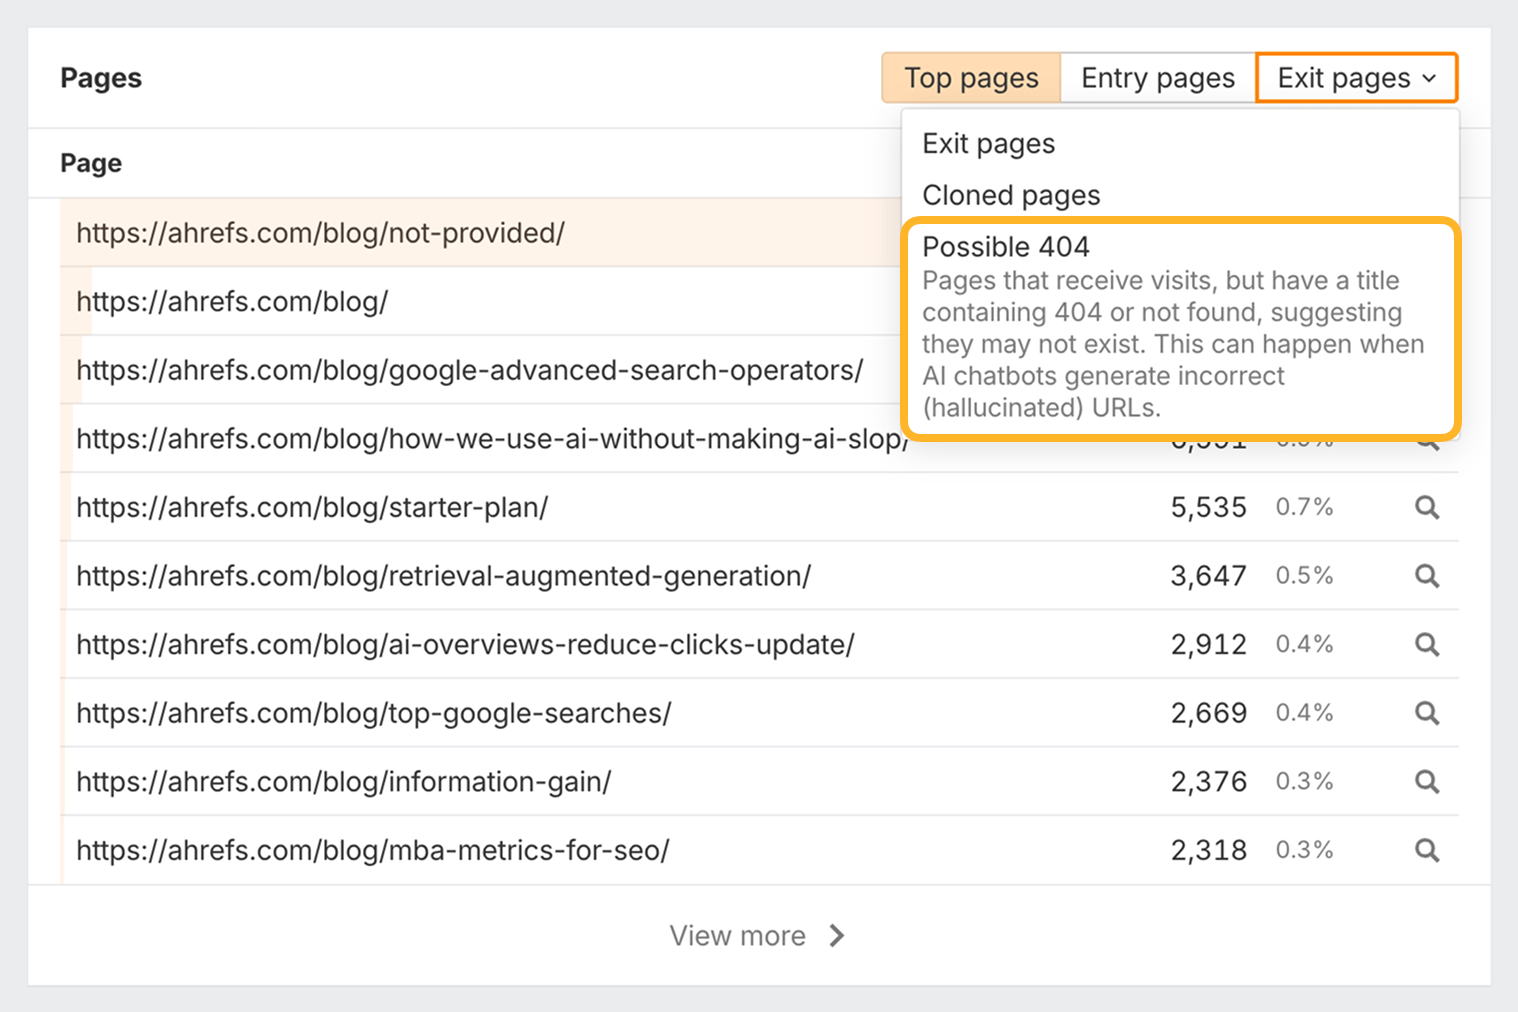
Wenn eine halluzinierte URL immer wieder angefragt wird, sagt dir das Modell damit, welche Seite deine Besucher von dir erwarten.
Werde zu einer anerkannten Instanz
Jede Taktik in diesem Guide hängt letztlich von einem einzigen Punkt ab: ob KI-Systeme deine Marke als eigenständige Entität erkennen.
Wusstest du schon?
Eine Entität ist jedes eigenständige Ding aus der realen Welt, das eine Suchmaschine oder KI erkennen und von allem anderen unterscheiden kann – eine bestimmte Person, ein Ort, ein Unternehmen, ein Produkt oder ein Konzept (wie „Dmytro Gerasymenko“, „Ahrefs“ oder „Singapur“) und nicht nur die Wörter, mit denen es beschrieben wird.
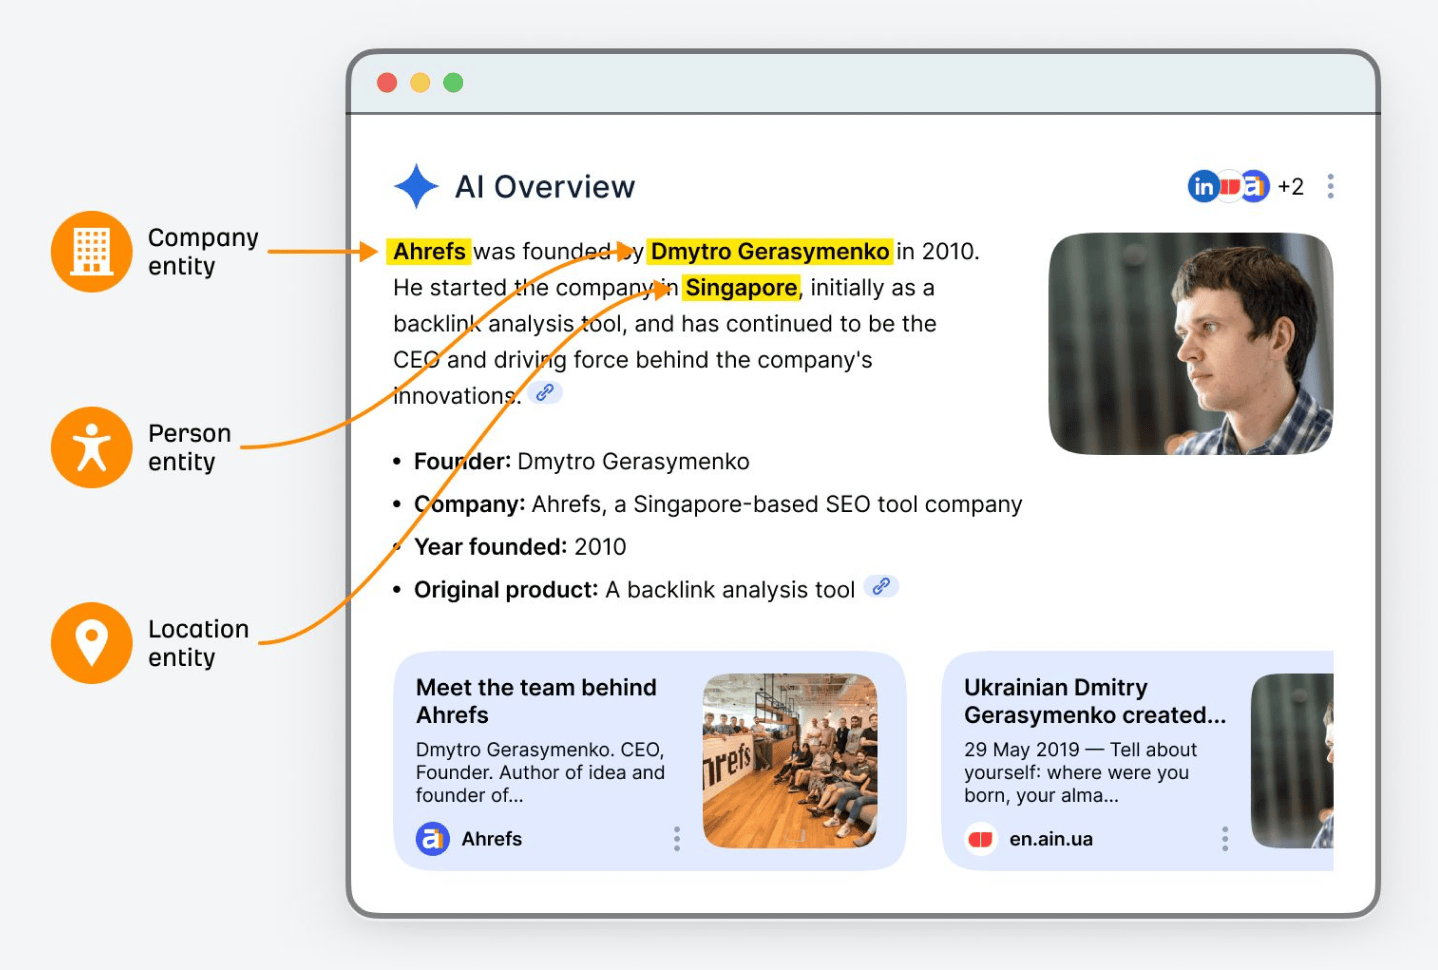
Googles Knowledge Graph – eine Datenbank mit 54 Milliarden Entitäten und über 1,6 Billionen Fakten darüber, wie sie miteinander zusammenhängen – ist nicht länger nur die Engine hinter Knowledge Panels.
Es ist jetzt die Kerninfrastruktur für AI Overviews, AI Mode und Gemini.
Wenn deine Marke nicht klar als Entität etabliert ist – mit konsistenten Signalen über deine Website, strukturierte Daten und autoritative Drittquellen hinweg –, riskierst du, in KI-Antworten unsichtbar zu sein – nicht nur in den blauen Links.
Schema wird oft als schneller Gewinn für KI-Sichtbarkeit angepriesen, und die oberflächliche Korrelation wirkt überzeugend: Von KI zitierte Seiten haben fast dreimal so häufig JSON-LD.
Schema ist auf Seiten, die von KI zitiert werden, deutlich häufiger
Ahrefs-Studie mit 6 Mio. Seiten (2 Mio. Seiten pro Gruppe).
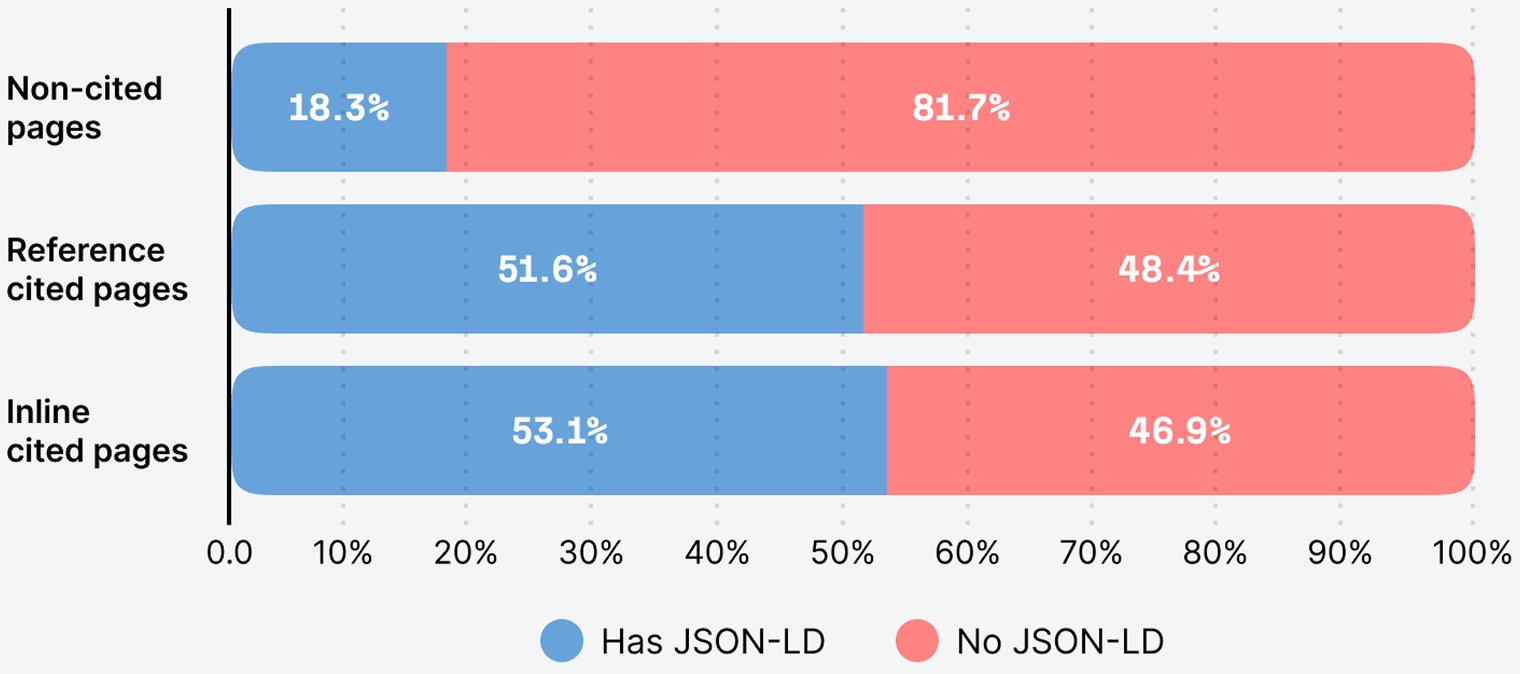
Aber Korrelation ist nicht gleich Kausalität. Wir haben 1.885 Seiten, die JSON-LD hinzugefügt haben, getrackt und mit 4.000 Kontrollseiten verglichen – und keine nennenswerte Verbesserung bei KI-Modus oder ChatGPT festgestellt sowie einen kleinen Rückgang bei AI Overview, den wir nicht auf Schema zurückführen konnten.
Ist Schema also nutzlos? Nein, aber seine Rolle ist langsam und indirekt – keine Quick-Win-Taktik.
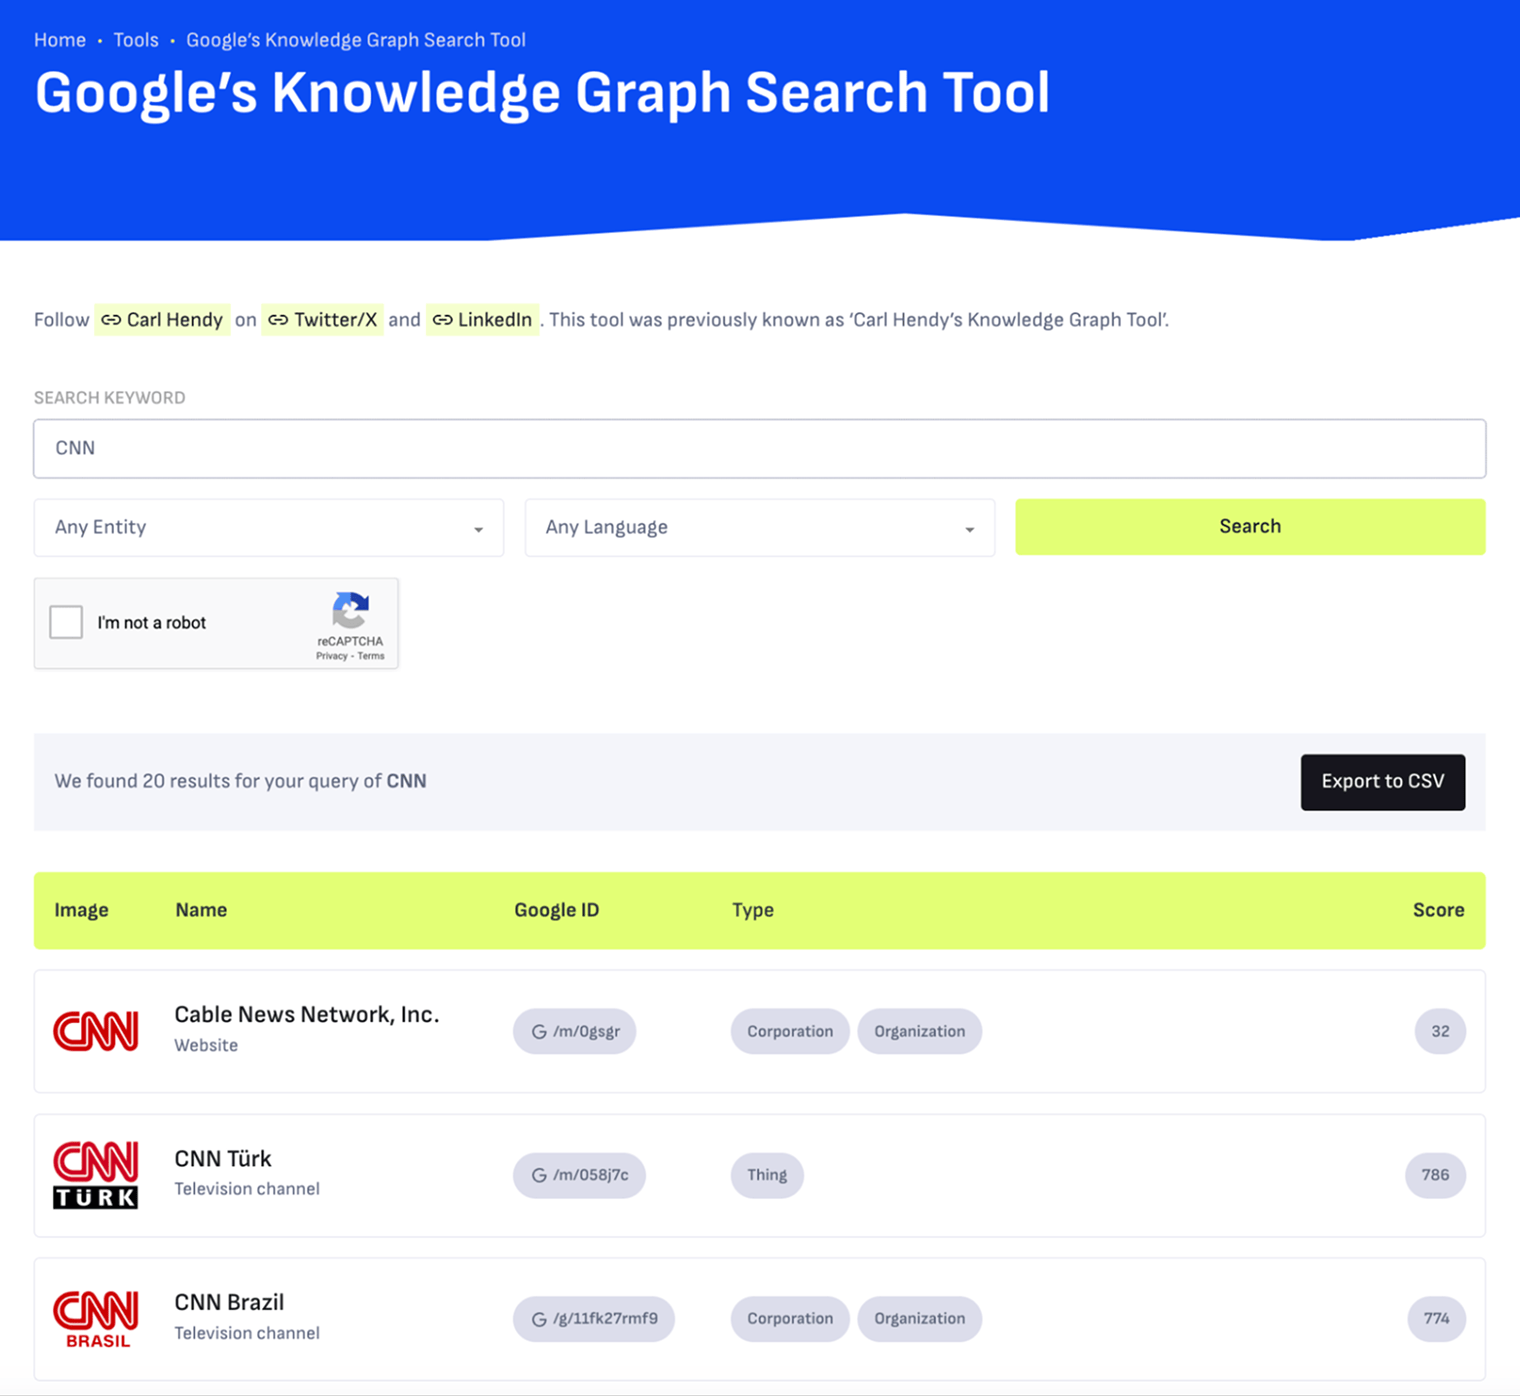
Du kannst prüfen, ob Google dich bereits erkennt, indem du Googles Knowledge Graph API oder einen kostenlosen Checker nutzt, um zu sehen, welchen Entitätstyp es dir zugewiesen hat und ob die Attribute stimmen.
Zum Beispiel zeigt dir Carl Hendys Knowledge-Graph-Tool Ergebnisse für Personen, Unternehmen, Produkte, Orte und andere Entitäten.
Versuche dann, Erwähnungen von autoritativen Publikationen zu erhalten, und halte deine Fakten überall konsistent: derselbe Name, dieselbe Beschreibung und dieselbe Kategorie auf deiner Website, in deinen Profilen und in Drittanbieter-Einträgen.
Füge dann Schema dort hinzu, wo es natürlich ist, und priorisiere die Typen, die deine Entität und ihre Beziehungen definieren:
Organization- und sameAs-Schema mit Links zu deinem Wikipedia-Eintrag, deinem Wikidata-Eintrag und deinen Social-Profilen
Person-Schema für die Autoren deiner Website
Product-Schema für deine Angebote
Tipp
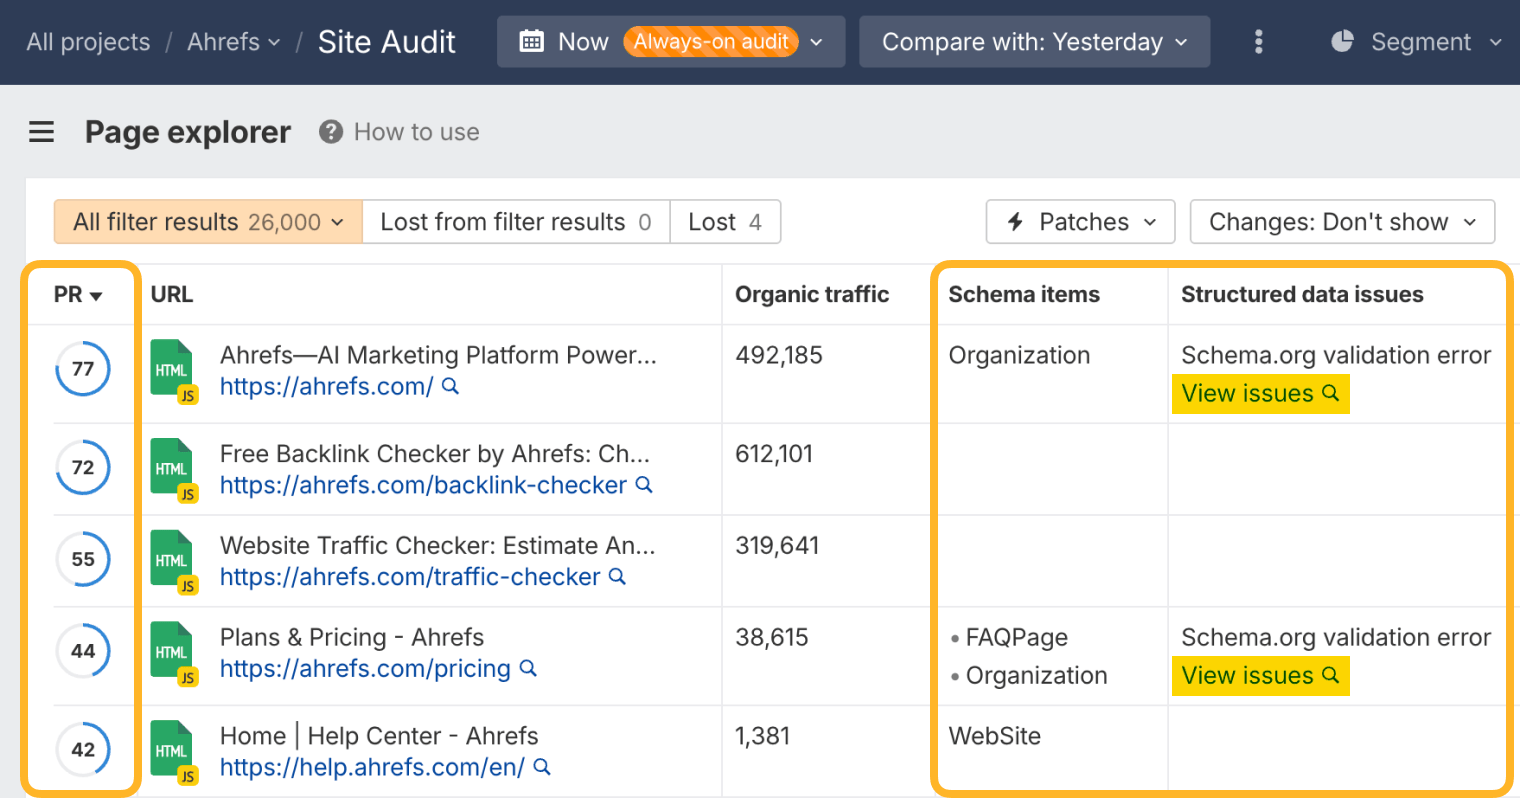
Finde deine Seiten mit der höchsten Autorität und stelle sicher, dass diese sauberes Schema-Markup enthalten.
Du kannst das tun, indem du im Site Audit zum Report Page Explorer gehst und nach „Page Rating“ sortierst.
Page Rating (PR) zeigt die Stärke des internen und externen Backlink-Profils deiner URL im Vergleich zu anderen URLs, die in deinem Crawl enthalten sind.
Prüfe dann die Spalte „Schema-Elemente“, um dein bestehendes Schema zu auditieren, und die Spalte „Probleme mit strukturierten Daten“, um fehlende oder ungültige strukturierte Daten zu erkennen.
Bereite dich auf Agent-to-Agent-Marketing vor
Zum Schluss noch dieser Gedanke: Ein wachsender Teil der „Leser“, die du beeinflussen möchtest, sind in Wirklichkeit KI-Agenten, die im Namen deiner Zielgruppe browsen und einkaufen.
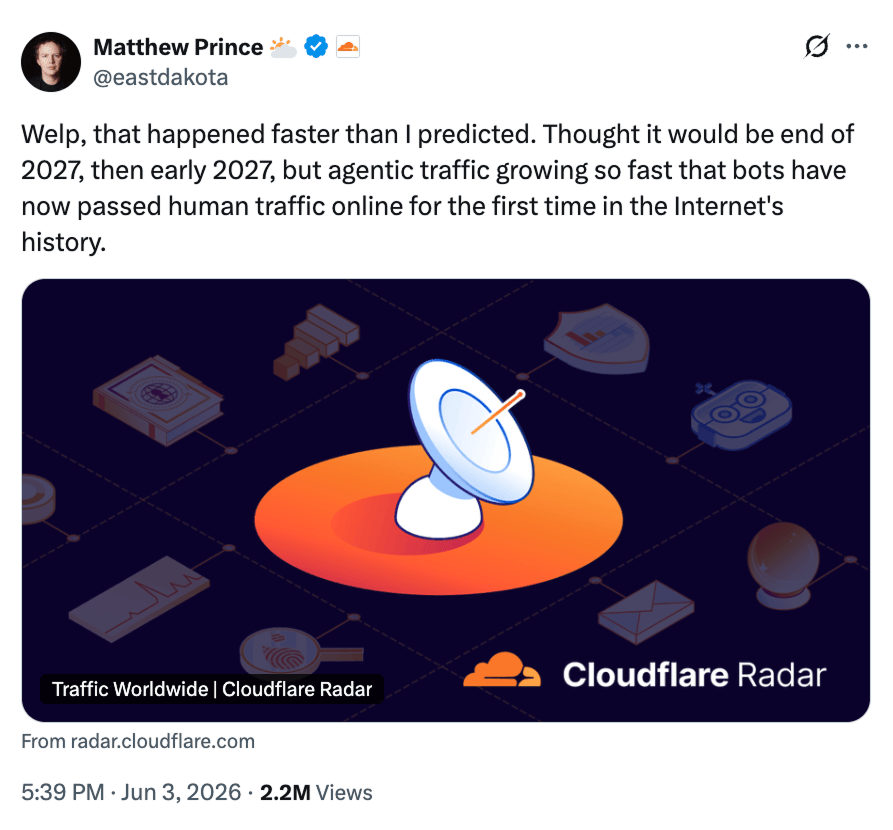
Tatsächlich hat der Cloudflare-CEO Matthew Prince im Juni 2026 bekannt gegeben, dass agentischer Traffic (Bot-/Crawler-/Agent-Traffic) zum ersten Mal in der Geschichte des Internets die 50-%-Marke überschritten hat.2, 3
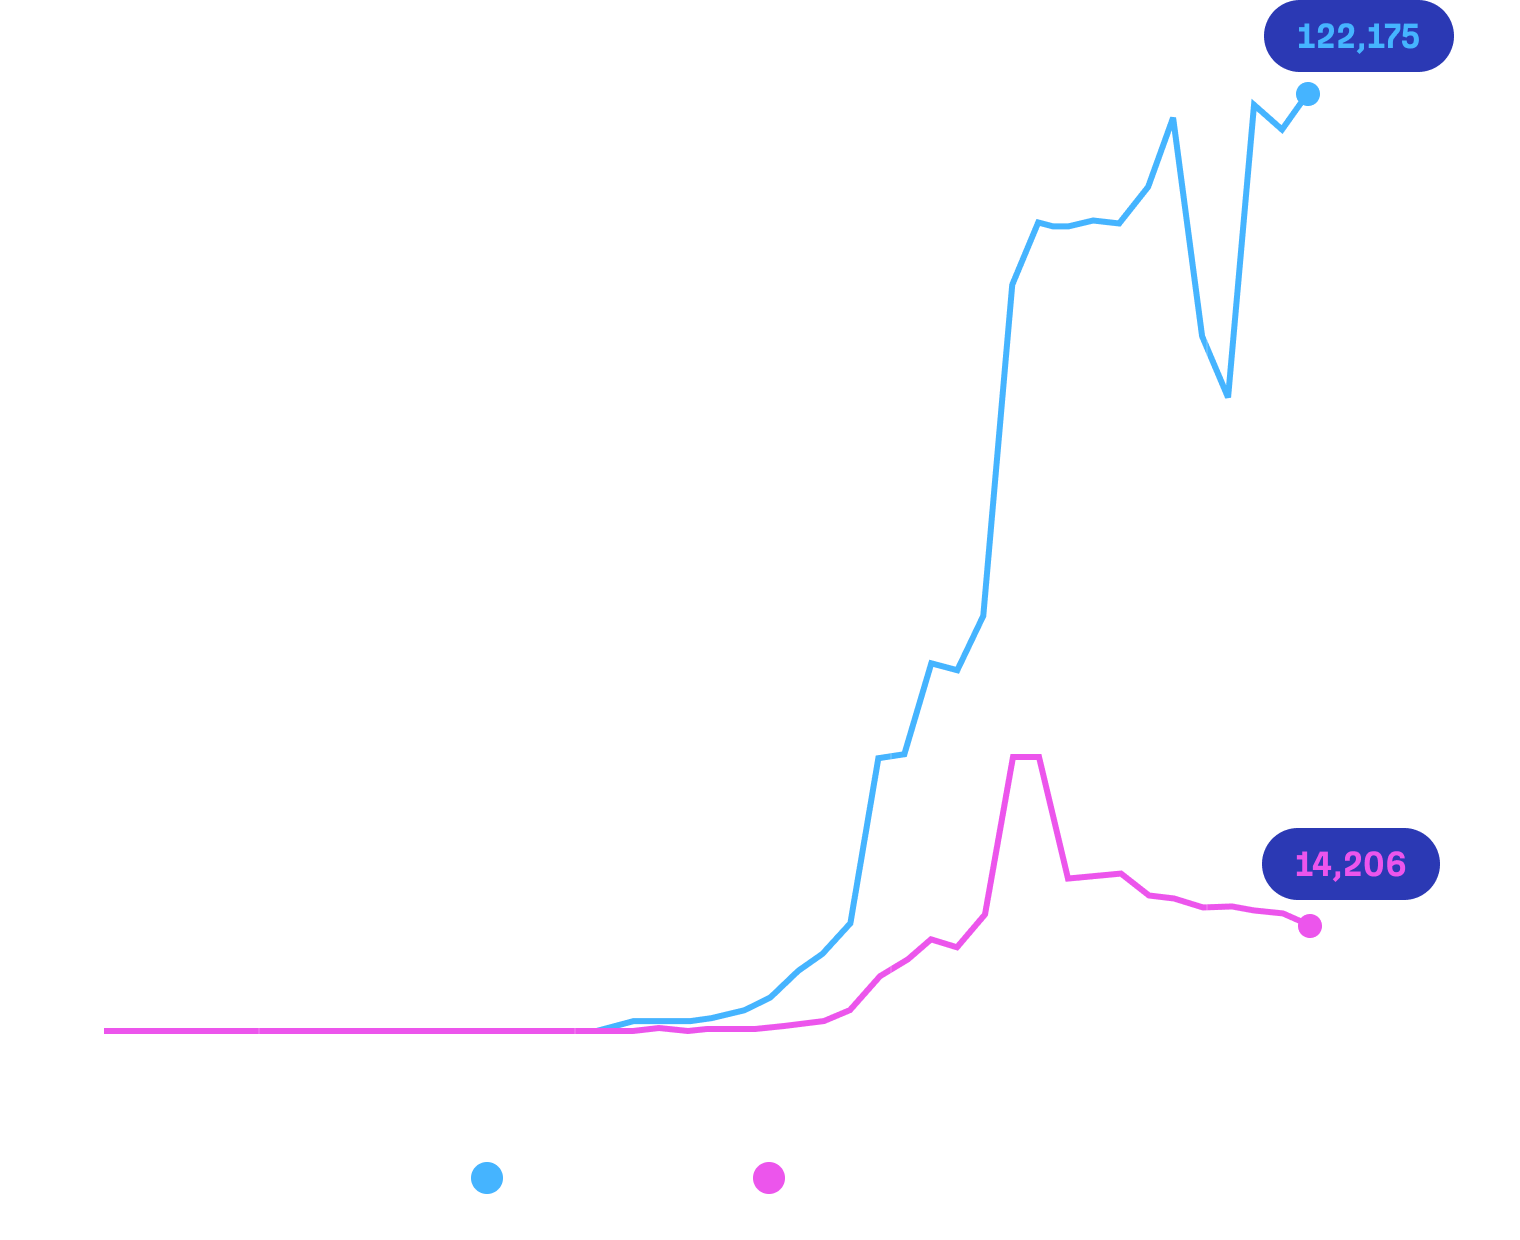
Weit davon entfernt, ein Randfall oder eine Neuheit zu sein, sind die Suchanfragen nach „agentic AI“ in drei Jahren um das 84-Fache gestiegen – während die Kosten für den Betrieb eines Agenten von Dollar auf Cent gefallen sind.
Weiterführende Lektüre
Du musst deine Website noch nicht ausschließlich für KI-Agenten neu aufbauen. Aber der alte Rat, Content nur für Menschen zu erstellen und sich nicht um Robots zu kümmern, hält wahrscheinlich nicht mehr ganz so gut stand wie früher.
In diesem Kapitel geht es darum, die KI zu beeinflussen, der Menschen vertrauen – und Agent-to-Agent-Marketing ist genau das, nur einen Schritt weitergedacht.
Verweise
- „ChatGPT ist eine Suchmaschine. So funktioniert sie.“ David McSweeney, QueryBurst.
- Matthew Prince (@eastdakota) auf X. 3. Juni 2026.
Louise ist Content Marketerin bei Ahrefs. In den letzten zehn Jahren hatte sie leitende Content-Positionen bei SaaS-Marken inne: Pi Datametrics, BuzzSumo und Cision. In dieser Zeit hat sie Hunderte Blogposts veröffentlicht, branchenführende Research-Projekte vorangetrieben und von Expert:innen geleitete Webinar-Programme entwickelt.
Louise hat die Grundlagen von SEO während ihrer Zeit beim Enterprise-SEO-Unternehmen Pi gelernt. Innerhalb weniger Wochen nach ihrem Einstieg hatte sie einen Artikel über Kannibalisierung veröffentlicht, der die Aufmerksamkeit des damals größten Namens in der SEO-Welt auf sich zog: Rand Fishkin. Seitdem hat sie über Themen von manipulativem Linkaufbau über Content-Syndizierung bis hin zu Prognosen der Suchnachfrage geschrieben. In ihrer Freizeit hat sie ihr praktisches SEO-Verständnis vertieft, indem sie Websites für zwei lokale Unternehmen aufgebaut hat.
Louises Beiträge kannst du in Branchenpublikationen wie Search Engine Watch, The Drum, The Telegraph und Spin Sucks lesen.
Alle AEO-Leitfäden entdecken
Was ist Answer Engine Optimization (AEO)?
Starte hier. Was AEO ist, wie es sich von SEO unterscheidet und die sieben Schritte für den Einstieg.
So funktionieren Antwortmaschinen
Was zwischen einem Prompt und einer Antwort wirklich passiert – und wo deine Marke ins Spiel kommen kann.
So trackst du KI-Sichtbarkeit
Du kannst nicht optimieren, was du nicht siehst. Sieben Wege, um zu messen, wo deine Marke in KI-Antworten auftaucht.
So wählst du die besten Prompts zum Tracking aus
Tracke Prompt-Cluster statt einzelner Antworten. Elf Orte, um die Suchanfragen zu finden, die sich zu überwachen lohnen.
So optimierst du Content für Antwortmaschinen
Rankings sorgen dafür, dass du in Betracht gezogen wirst. So wirst du zitiert – die Themen, Formate und On-Page-Änderungen, die funktionieren.
So überwachst du Markenerwähnungen in KI-Antworten und erzielst mehr davon
KI empfiehlt Marken, über die an anderer Stelle diskutiert wird. So überwachst du diese Erwähnungen und sorgst für mehr davon.
So optimierst du deine Website für Antwortmaschinen
Die technischen Korrekturen, die darüber entscheiden, ob KI deine Seiten erreichen, sie lesen und herausfinden kann, wer du bist.