
Jak zoptymalizować witrynę pod silniki odpowiedzi?
Autor: Louise Linehan
Specjalista ds. marketingu treści w Ahrefs
- Nie blokuj robotów internetowych AI w pliku robots.txt
- Nie ukrywaj treści za rozbudowanym kodem JavaScript
- Popraw prędkość ładowania strony
- Nie zawracaj sobie głowy plikiem llms.txt
- Popraw błędne adresy URL, które AI przypisuje Twojej witrynie
- Zbuduj rozpoznawalność swojej marki
- Przygotuj się na marketing oparty na komunikacji między agentami AI
Twoje treści mogą być świetne, a mimo to mogą nigdy nie być wykorzystane w odpowiedziach AI.
Każda taktyka optymalizacji pod AI zakłada, że systemy AI mogą dotrzeć do Twoich stron, odczytać ich zawartość i ustalić, kim jesteś. Żadne z tych założeń nie jest jednak oczywiste. Około 5,89% stron internetowych całkowicie blokuje GPTBot, z kolei ChatGPT najwyraźniej rezygnuje ze stron, w przypadku których czas odpowiedzi przekracza ok. 2 sekund, a większość robotów internetowych AI w ogóle nie wykonuje kodu JavaScript.
Dobra wiadomość jest taka, że to najłatwiejsza do naprawienia część AEO. Żaden z tych czynników sam w sobie nie zapewni Ci cytowania, ale każdy z tych problemów może po cichu pozbawić Cię wszystkich cytowań, które w przeciwnym razie udałoby Ci się zdobyć.
Poszerz swoją wiedzę na YouTube
Nie blokuj robotów internetowych AI w pliku robots.txt
Żadna z porad zawartych w tym przewodniku nie ma znaczenia, jeśli roboty internetowe AI nie mogą odczytać Twoich stron. Zablokowanych stron nie da się cytować, a do ich blokowania często dochodzi przypadkowo.
Przeanalizowaliśmy około 140 milionów witryn i odkryliśmy, że GPTBot jest teraz najczęściej blokowanym botem AI (5,89% witryn), a tuż za nim plasuje się ClaudeBot.
Cloudflare domyślnie blokuje platformy AI, więc sprawdź, czy Twoja sieć CDN nie zablokowała ich po cichu.
„Dopuszczenie robotów internetowych AI” nie jest pojedynczą decyzją, ponieważ każda platforma korzysta z kilku botów wykonujących różne zadania.
Samo OpenAI obsługuje trzy:
- GPTBot zbiera treści na potrzeby trenowania modeli
- Bot OAI-SearchBot tworzy indeks wyszukiwania, z którego korzysta ChatGPT
- ChatGPT-User pobiera stronę na żywo, gdy ktoś pyta o nią w trakcie rozmowy
W każdym przypadku kompromisy są inne. Zablokowanie robota GPTBot sprawia, że Twoje treści nie trafią do danych treningowych kolejnego modelu – i właśnie nad tą decyzją zwykle zastanawiają się wydawcy. Zablokowanie OAI-SearchBot usuwa natomiast Twoją witrynę z indeksu, z którego korzysta wyszukiwarka ChatGPT, co dziś oznacza utratę cytowań i ruchu z poleceń. Wiele witryn przypadkowo blokuje ten drugi bot, choć ich intencją jest zablokowanie tylko pierwszego.
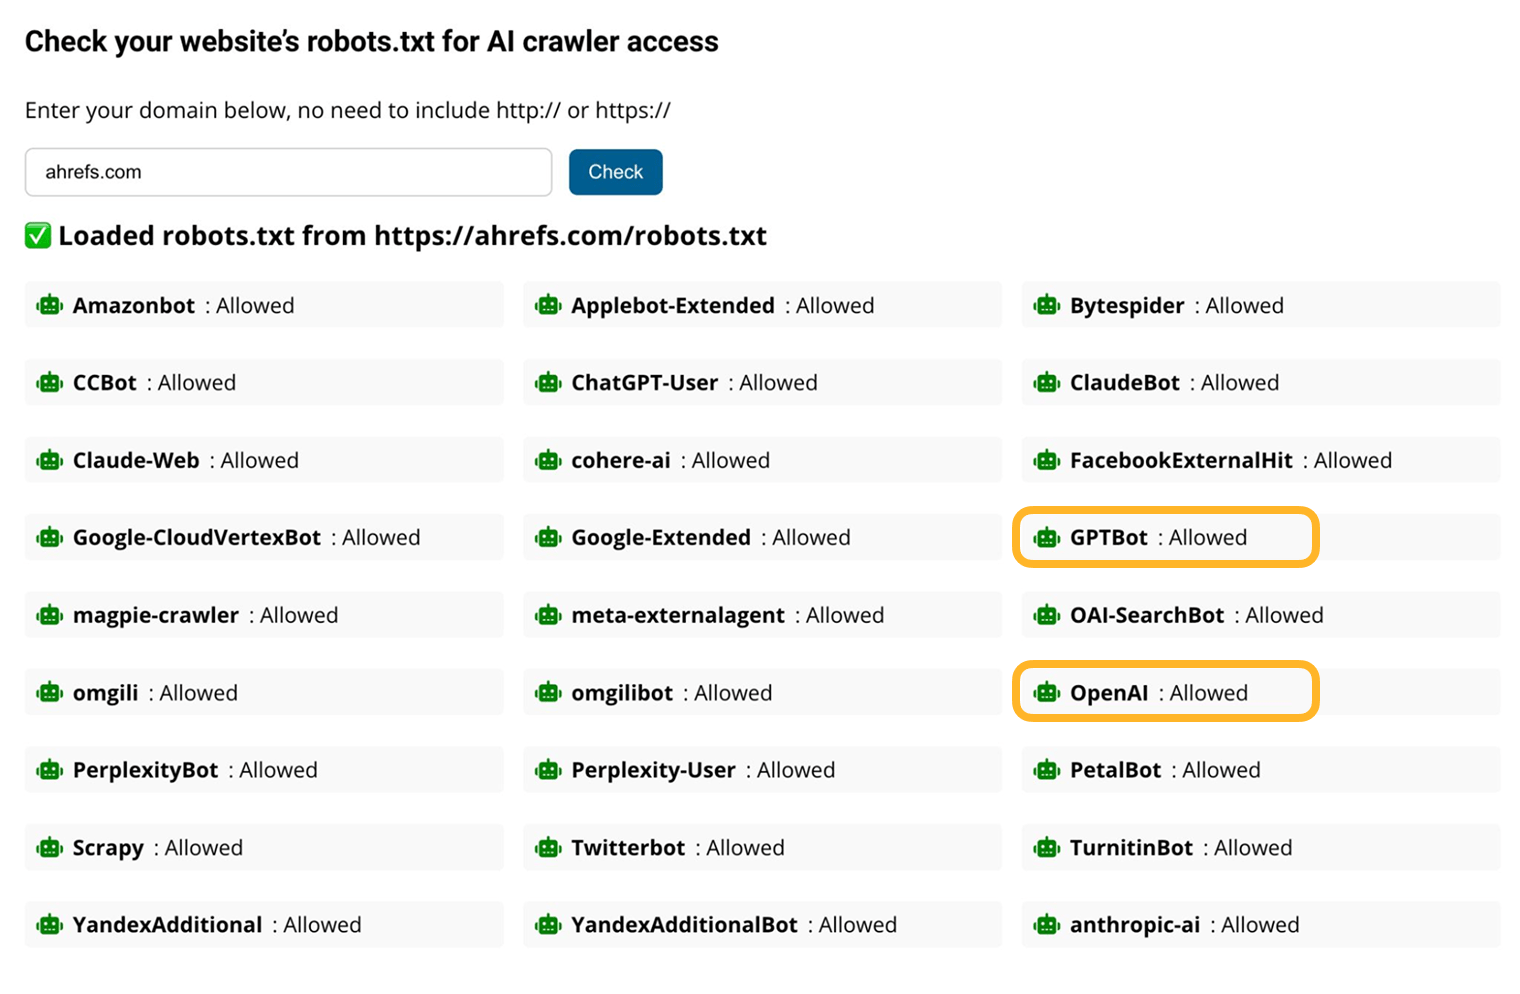
Najszybszym sposobem na sprawdzenie, jak wygląda sytuacja w Twoim przypadku, jest skorzystanie z narzędzia takiego jak AI Crawler Access Checker, które odczytuje Twój plik robots.txt i informuje, które roboty internetowe mają dostęp do witryny.
Aby sprawdzić, które boty faktycznie odwiedzają Twoją witrynę, a nie tylko które są do niej dopuszczone, skorzystaj z narzędzia Bot Analytics firmy Ahrefs. Śledzi ono wizyty w 12 kategoriach botów, w tym w dedykowanej kategorii AI, korzystając z danych po stronie serwera za pośrednictwem Cloudflare, dzięki czemu nie wymaga dodawania do witryny żadnego kodu JavaScript.
Nie ukrywaj treści za rozbudowanym kodem JavaScript
Roboty internetowe AI zwykle odczytują surowy kod HTML i w większości przypadków nie wykonują JavaScriptu tak, jak robi to przeglądarka.
Oznacza to, że wszystko, co pojawia się dopiero po wykonaniu JS po stronie klienta, może być dla nich niewidoczne.
Na wszelki wypadek postaw na renderowanie po stronie serwera, aby zapewnić swojej stronie jak największą szansę na widoczność w AI.
Popraw prędkość ładowania strony
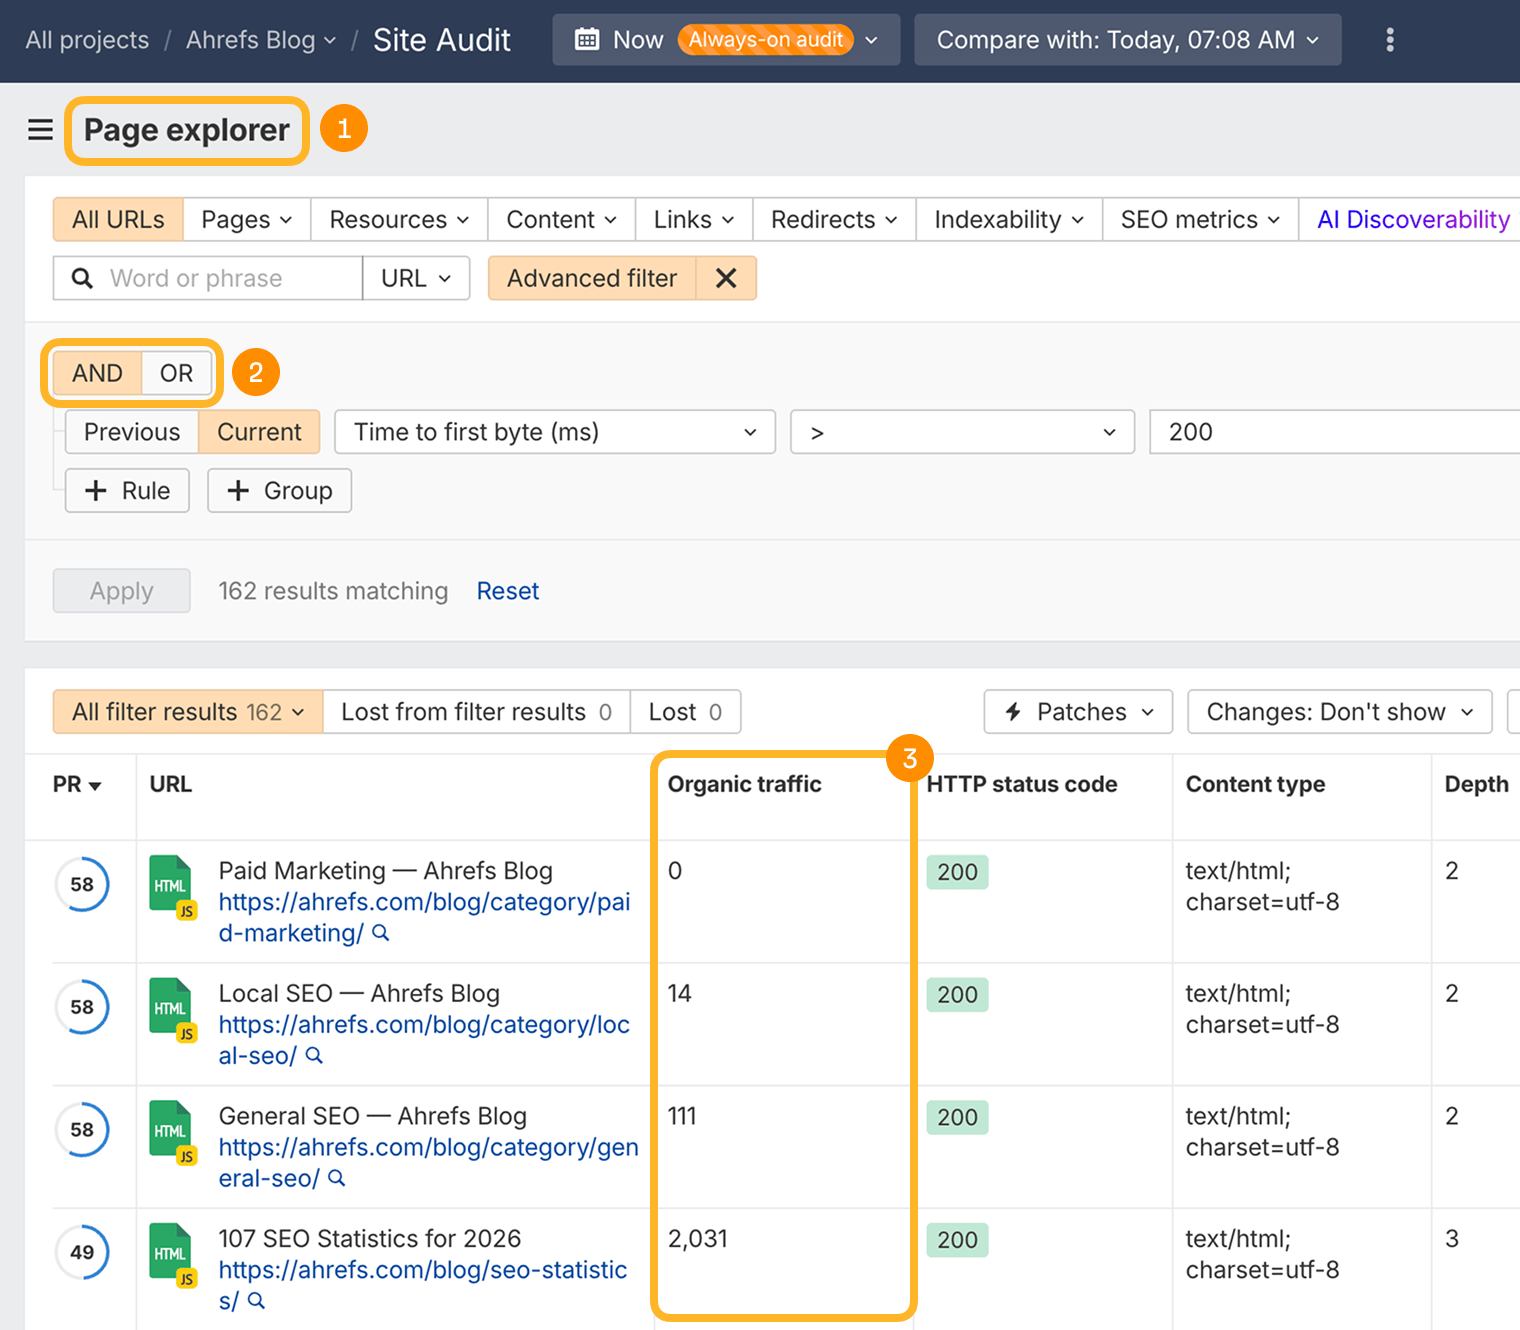
Wolno ładujące się strony mogą negatywnie wpływać na wyniki w tradycyjnym wyszukiwaniu, ale wygląda na to, że w silnikach odpowiedzi kara za niską szybkość może być jeszcze większa. Prędkość ładowania strony może decydować o tym, czy Twoja strona w ogóle trafi do okna kontekstowego modelu1.
Sprawdź prędkość ładowania strony (określaną jako „czas do pierwszego bajtu”) w narzędziu Site Audit:
Nie zawracaj sobie głowy plikiem llms.txt
llms.txt to proponowany standard pliku Markdown umieszczanego w katalogu głównym domeny (np. website.com/llms.txt), który informuje duże modele językowe, gdzie znajdują się najważniejsze treści: dokumentacja, zasady i polityki czy taksonomie produktów. W założeniu działa podobnie jak plik robots.txt, ale jest przeznaczony dla modeli językowych.
W praktyce jednak żaden z głównych dostawców LLM nie zobowiązał się do jego odczytywania. Ani OpenAI, ani Anthropic, ani Google.
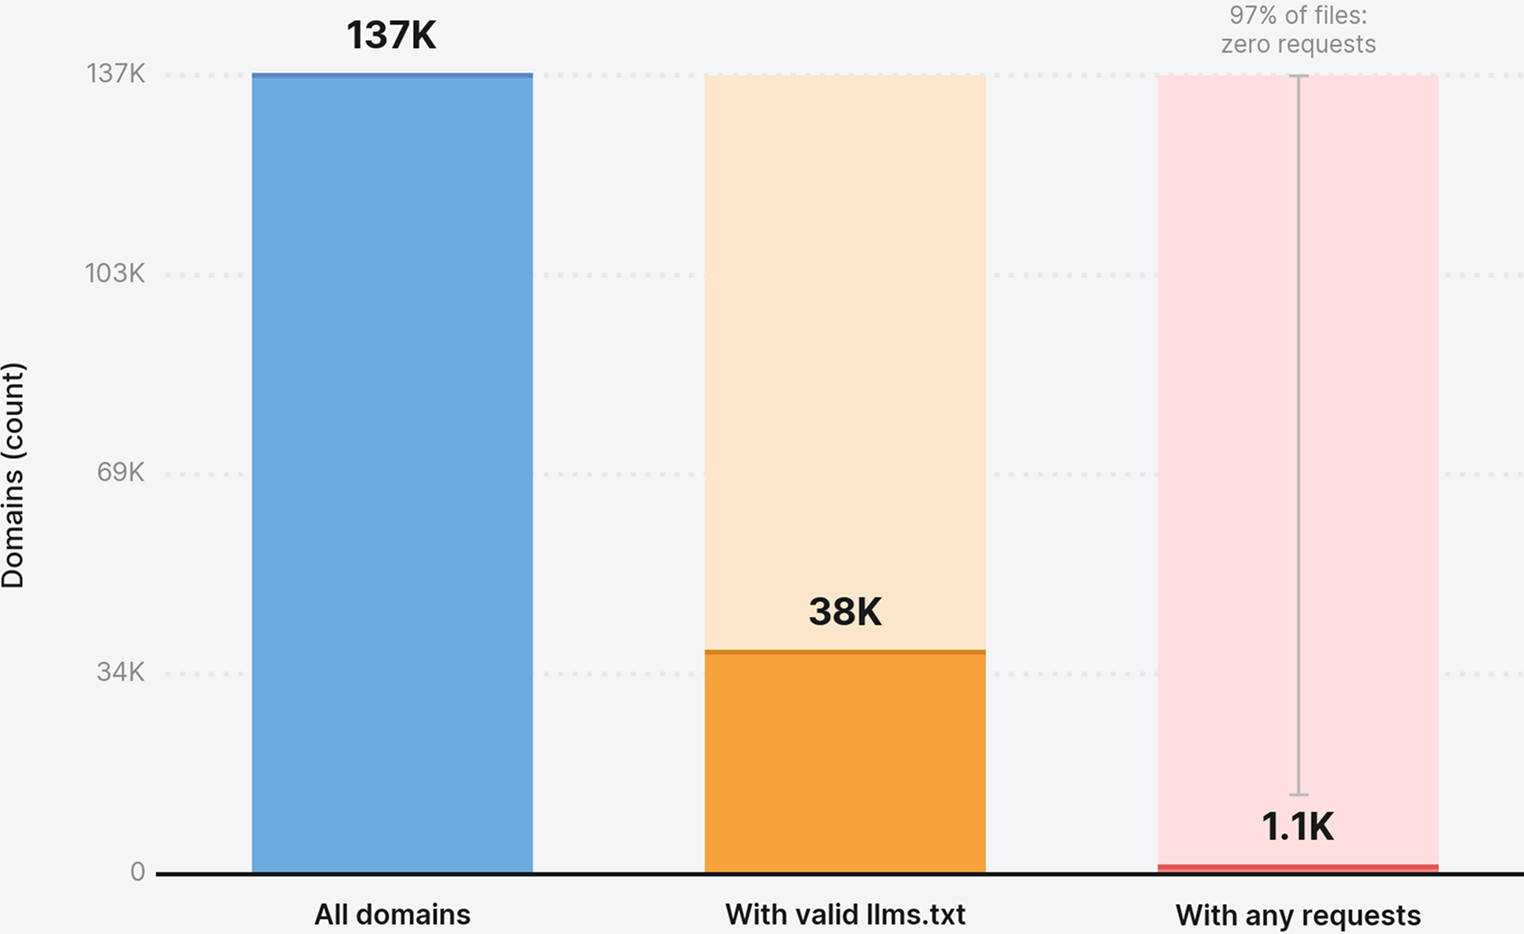
Sprawdziliśmy, co faktycznie dzieje się po dodaniu pliku llms.txt do witryny. Spośród 137 000 domen korzystających z narzędzia Web Analytics firmy Ahrefs 28% publikuje plik llms.txt. Spośród około 38 000 witryn z prawidłowym plikiem aż 97% odnotowało zero żądań dotyczących tego pliku w miesiącu, w którym prowadziliśmy pomiar.
97% plików llms.txt nigdy nie jest pobieranych
Badanie Ahrefs obejmujące 137 000 domen korzystających z Ahrefs Web Analytics.
Spośród niewielkiego odsetka plików, które faktycznie zostały pobrane, 96% żądań pochodziło od botów. Slackbot, czyli bot odpowiedzialny za podgląd linków, pobierał plik llms.txt częściej niż PerplexityBot. Mówiąc wprost: najważniejsze wyszukiwarki AI najwyraźniej z niego nie korzystają.
Google mówi o tym wprost. W swoim przewodniku dotyczącym optymalizacji pod funkcje generatywnej AI ma sekcję dosłownie zatytułowaną „mythbusting”, w której informuje właścicieli witryn, że pliki do odczytu maszynowego, takie jak llms.txt, nie są potrzebne, aby pojawiać się w wyszukiwaniu generatywnej AI. John Mueller poszedł o krok dalej, porównując to do starego metatagu keywords:

O ile mi wiadomo, żadna z usług AI nie zadeklarowała, że korzysta z LLMs.TXT (a po logach serwera widać, że nawet nie sprawdzają tego pliku). Moim zdaniem jest to porównywalne z metatagiem keywords – właściciel witryny deklaruje w nim, czego dotyczy jego strona… (Czy rzeczywiście tak jest? Cóż, można to sprawdzić. A skoro tak, to dlaczego po prostu nie sprawdzić od razu samej witryny?)
John Mueller, Search Advocate, Google
Czy zatem warto go utworzyć? Jeśli publikujesz dokumentację dla deweloperów, zajmie Ci to około dziesięciu minut, a zastosowanie takiego pliku wydaje się uzasadnione. Mueller określił go jako „tymczasowe rozwiązanie, być może pozwalające zaoszczędzić trochę tokenów” w przypadku narzędzi AI do kodowania, które analizują dokumentację. W pozostałych przypadkach jest to wysiłek bez zmierzonego efektu, a dodatkowo wiąże się z niewielkim minusem – ułatwia konkurencji masowe scrapowanie Twoich treści.
Popraw błędne adresy URL, które AI przypisuje Twojej witrynie
Asystenci AI często wymyślają nieistniejące linki do Twojej witryny. Sprawdziliśmy status HTTP 16 milionów adresów URL cytowanych przez platformy ChatGPT, Perplexity, Copilot, Gemini, Claude i Mistral – i odkryliśmy, że asystenci AI kierują użytkowników na strony zwracające błąd 404 o 2,87 raza częściej niż wyszukiwarka Google.
ChatGPT zdecydowanie wypada najgorzej. Aż 1,01% klikniętych adresów URL prowadzi do stron zwracających błąd 404, podczas gdy w przypadku Google wartość ta wynosi 0,15%.
Wskaźnik występowania błędu 404 według kanału odsyłającego
Dane z narzędzia Web Analytics – 16 000 000 przeanalizowanych adresów URL.
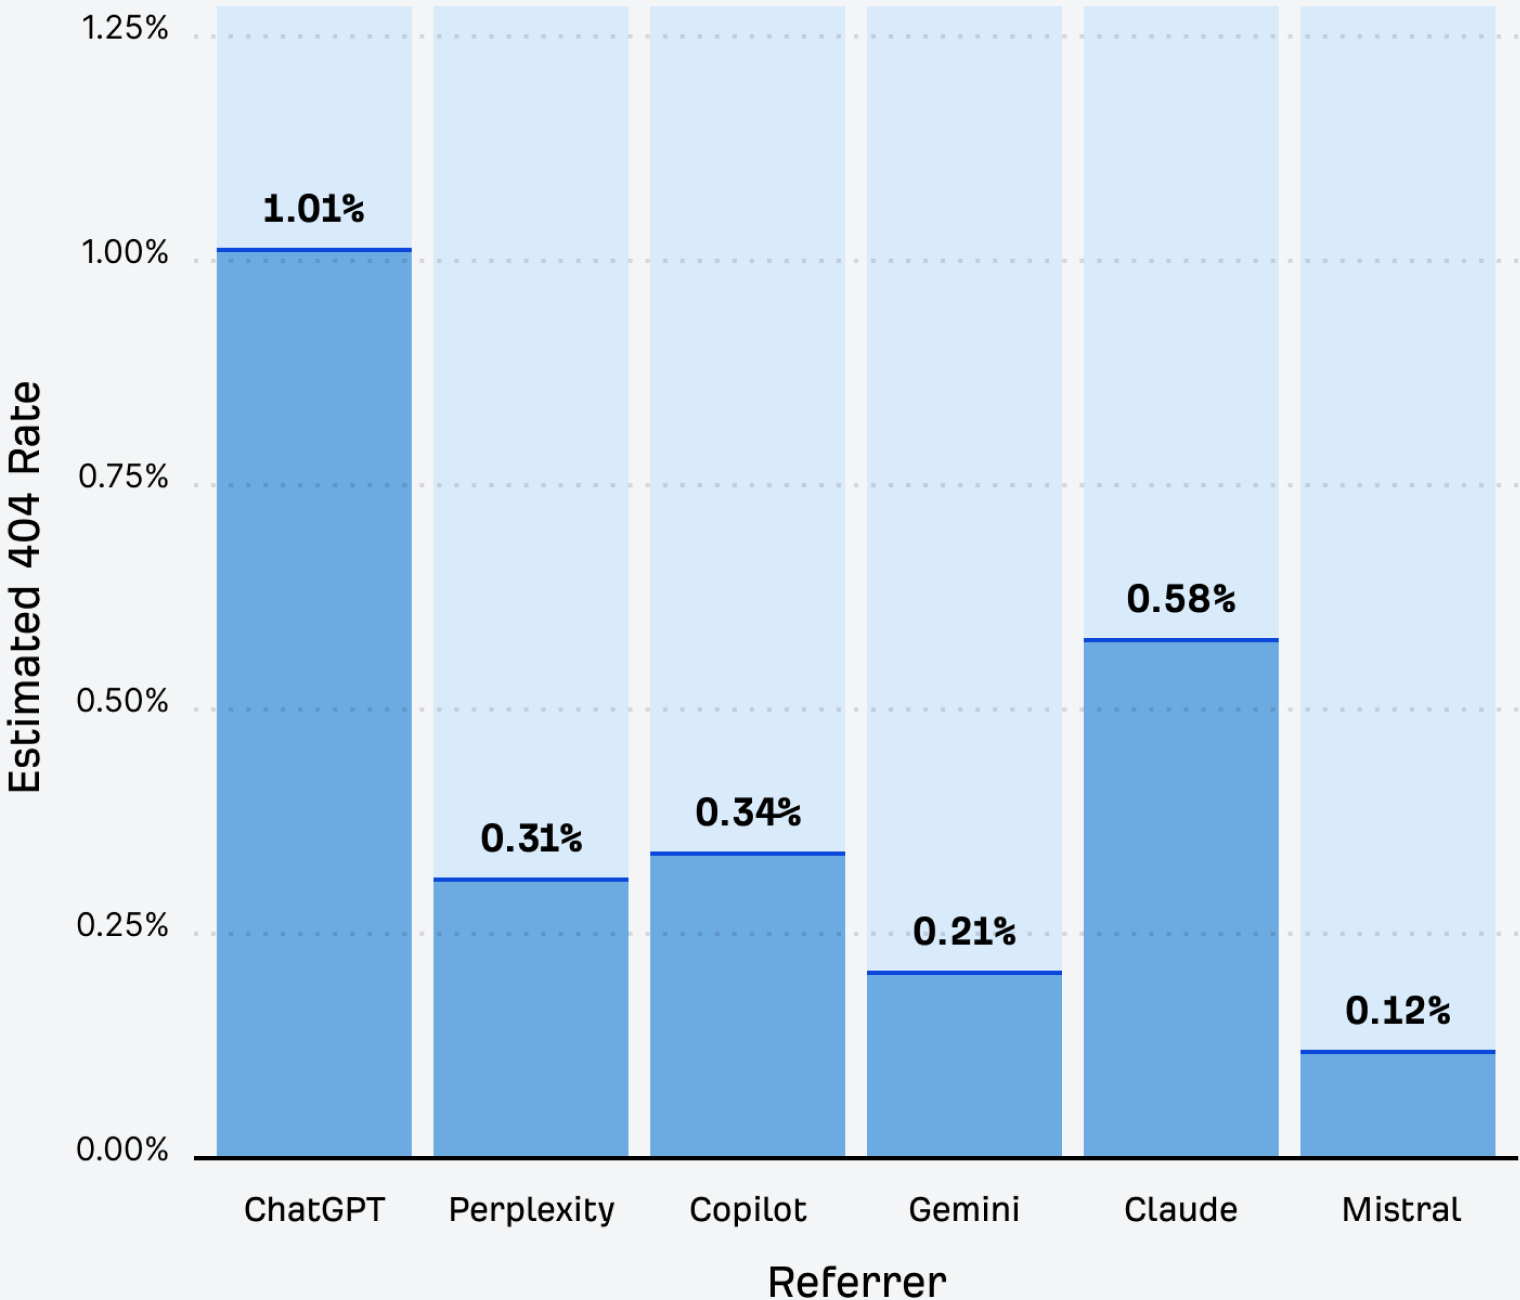
Perplexity (0,87%) i Gemini (0,86%) mają niemal dokładnie taki sam odsetek cytowanych adresów URL zwracających błędy jak Google (0,84%). To ma sens, ponieważ obie platformy pobierają dane z indeksu Google, więc dziedziczą znajdujące się w nim niedziałające linki, zamiast „wymyślać” własne.
Wymyślone adresy URL są generowane na podstawie istniejących wzorców w Twojej witrynie. W przypadku naszej strony często pojawiał się nieistniejący adres ahrefs.com/keywords, ponieważ nieustannie piszemy o słowach kluczowych i model założył, że strona o takim adresie z pewnością musi istnieć. Tak nie jest.
To jedna z niewielu naprawdę bezpłatnych możliwości w AEO. Ktoś, kto rzeczywiście był zainteresowany, zapytał o Twój produkt, trafił na Twoją stronę i… utknął. Możesz spotkać się z trzema różnymi typami takich sytuacji:
- Adresy URL będące wytworem halucynacji. Nieistniejące strony, które model „wymyślił” na podstawie struktury Twoich adresów URL.
- Nieaktualne adresy URL. Strony, które kiedyś istniały i zostały zapamiętane na podstawie danych treningowych lub innych nieaktualnych źródeł danych.
- Błędnie zapisane lub wariantowe adresy URL. Adresy niewiele różniące się od rzeczywistych adresów stron.
Dlatego dodaliśmy do narzędzia Web Analytics filtr, który za pomocą zaledwie dwóch kliknięć pozwala znaleźć adresy URL będące wytworem halucynacji. Jeśli szukasz prostej alternatywy dla Google Analytics, bezpłatnej do 1 miliona zdarzeń miesięcznie, sprawdź:
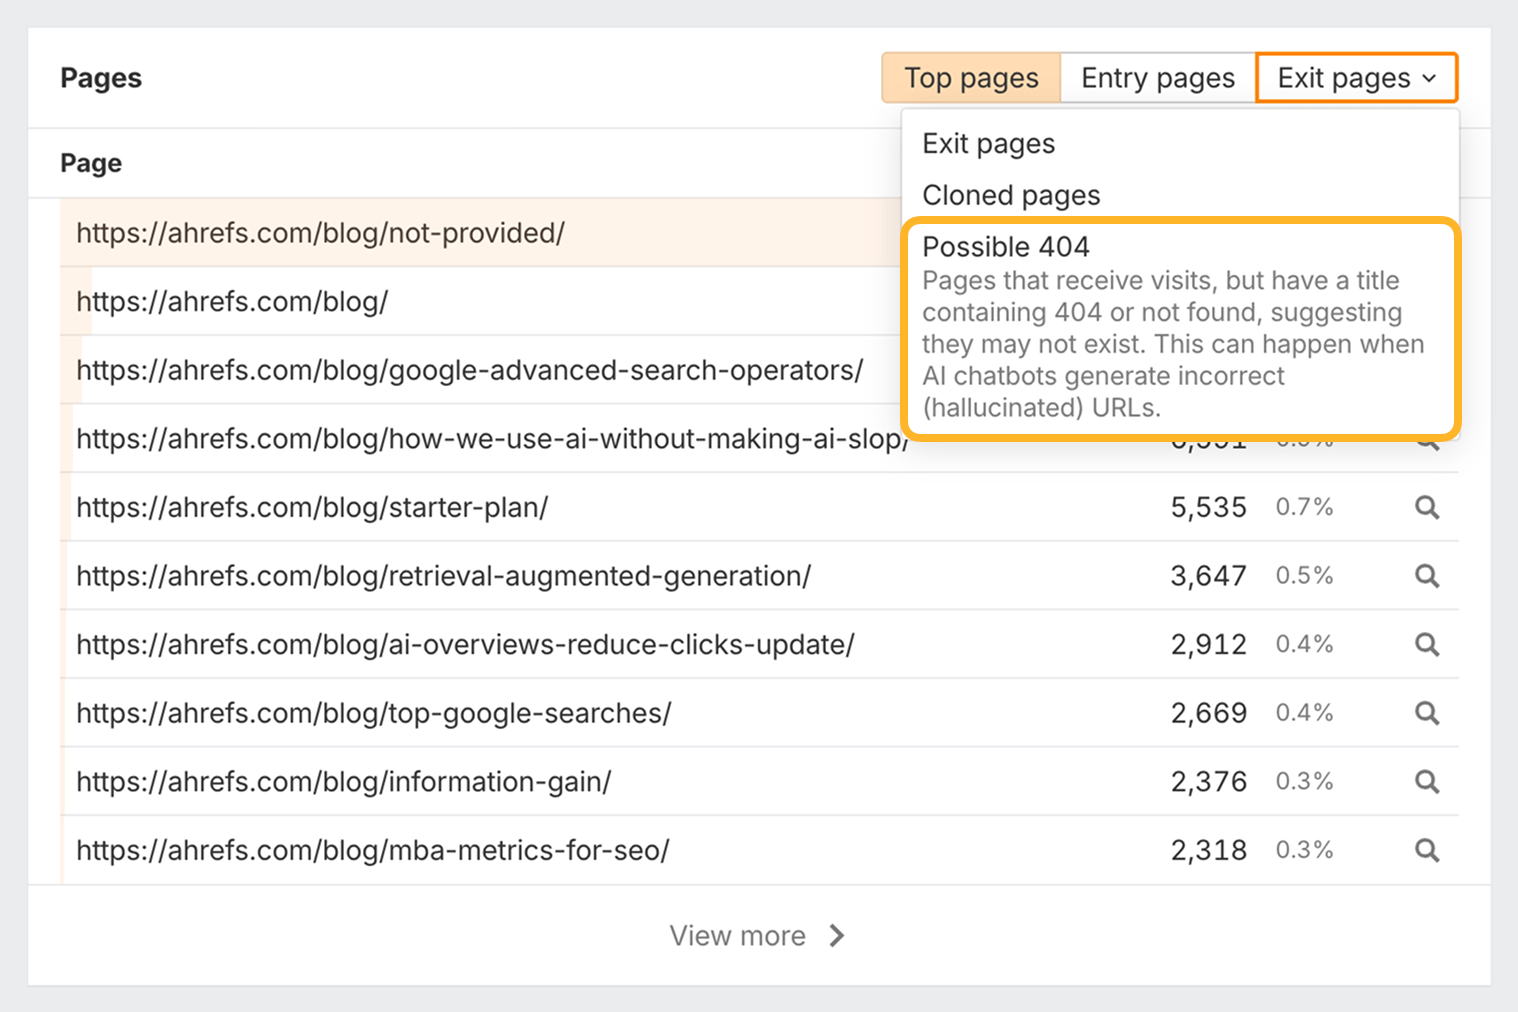
Jeśli adres URL będący wytworem halucynacji jest wielokrotnie wyszukiwany, model wskazuje Ci, jakiej strony spodziewają się u Ciebie odwiedzający.
Zbuduj rozpoznawalność swojej marki
Każda taktyka przedstawiona w tym przewodniku ostatecznie zależy od jednej kwestii: czy systemy AI rozpoznają Twoją markę jako odrębną encję.
Czy wiesz, że…
Encja to każdy odrębny byt w świecie rzeczywistym, który wyszukiwarka lub AI jest w stanie rozpoznać i odróżnić od wszystkich innych – np. konkretna osoba, miejsce, firma, produkt lub koncepcja (np. „Dmytro Gerasymenko”, „Ahrefs” czy „Singapur”), a nie tylko słowa użyte do jej opisania.
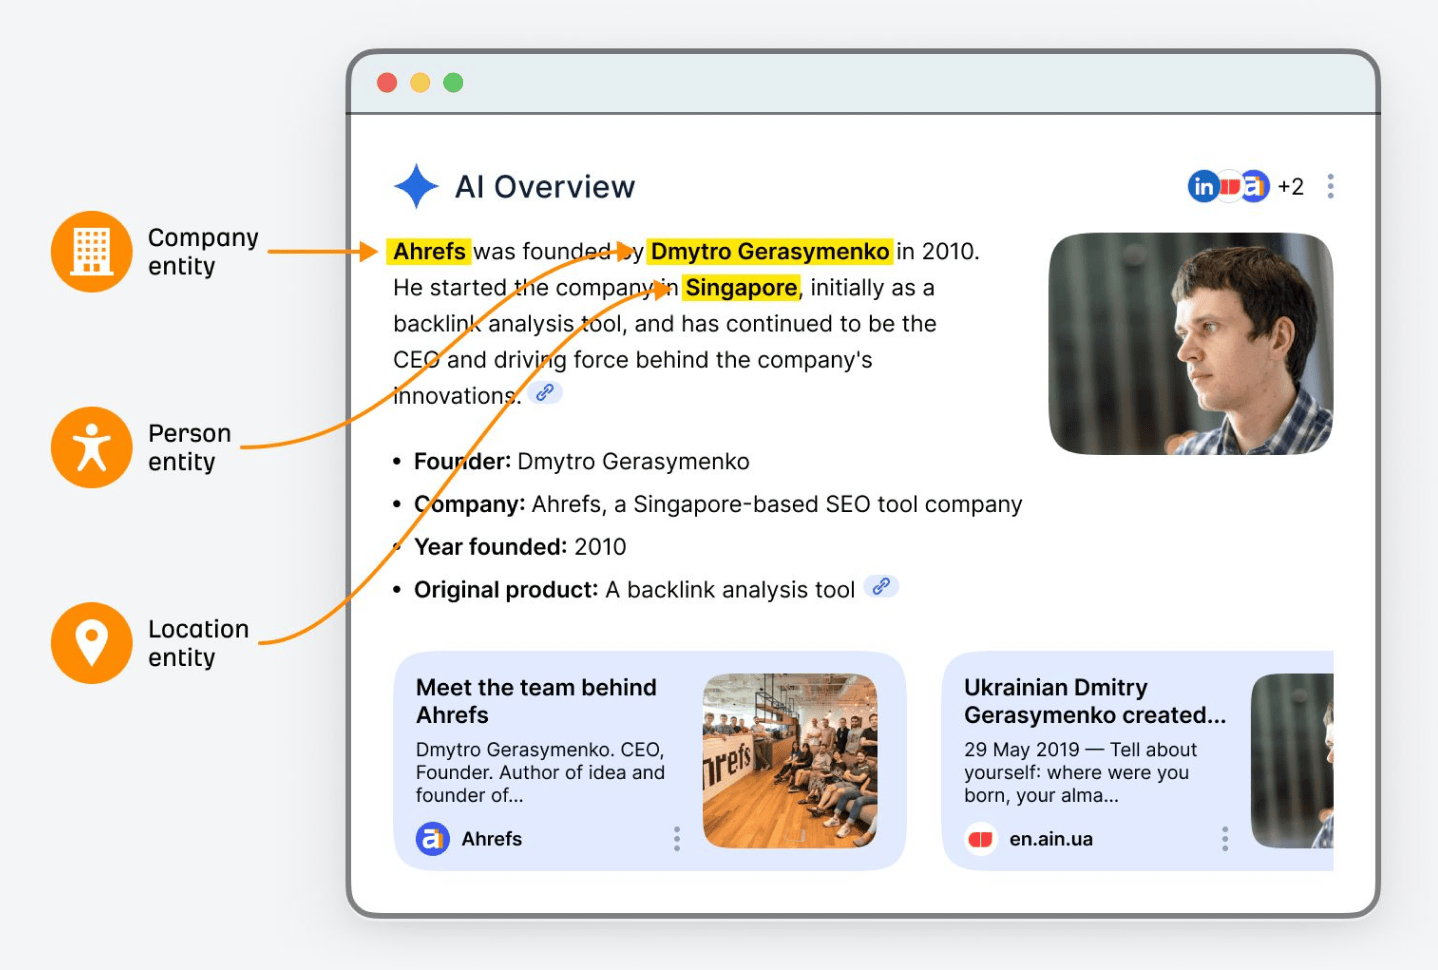
Graf Wiedzy Google – baza danych obejmująca 54 mld encji i ponad 1,6 bln informacji o relacjach między nimi – jest czymś więcej niż tylko mechanizmem stojącym za panelami wiedzy.
To obecnie podstawowa infrastruktura w przypadku AI Overviews, AI Mode i Gemini.
Jeśli Twoja marka nie jest wyraźnie ugruntowana jako encja, a sygnały dotyczące jej tożsamości nie są spójne w całej witrynie, w danych strukturalnych i w wiarygodnych źródłach zewnętrznych, ryzykujesz, że Twoja marka będzie niewidoczna w odpowiedziach AI – nie tylko w organicznych wynikach wyszukiwania.
Znaczniki schematu często przedstawia się jako szybki sposób na poprawę widoczności w AI, a powierzchowna korelacja wygląda przekonująco: strony cytowane przez AI niemal trzy razy częściej zawierają dane JSON-LD.
Na stronach cytowanych przez AI obecność znaczników schematu jest zdecydowanie częstsza
Badanie Ahrefs obejmujące 6 mln stron (2 mln stron na grupę).
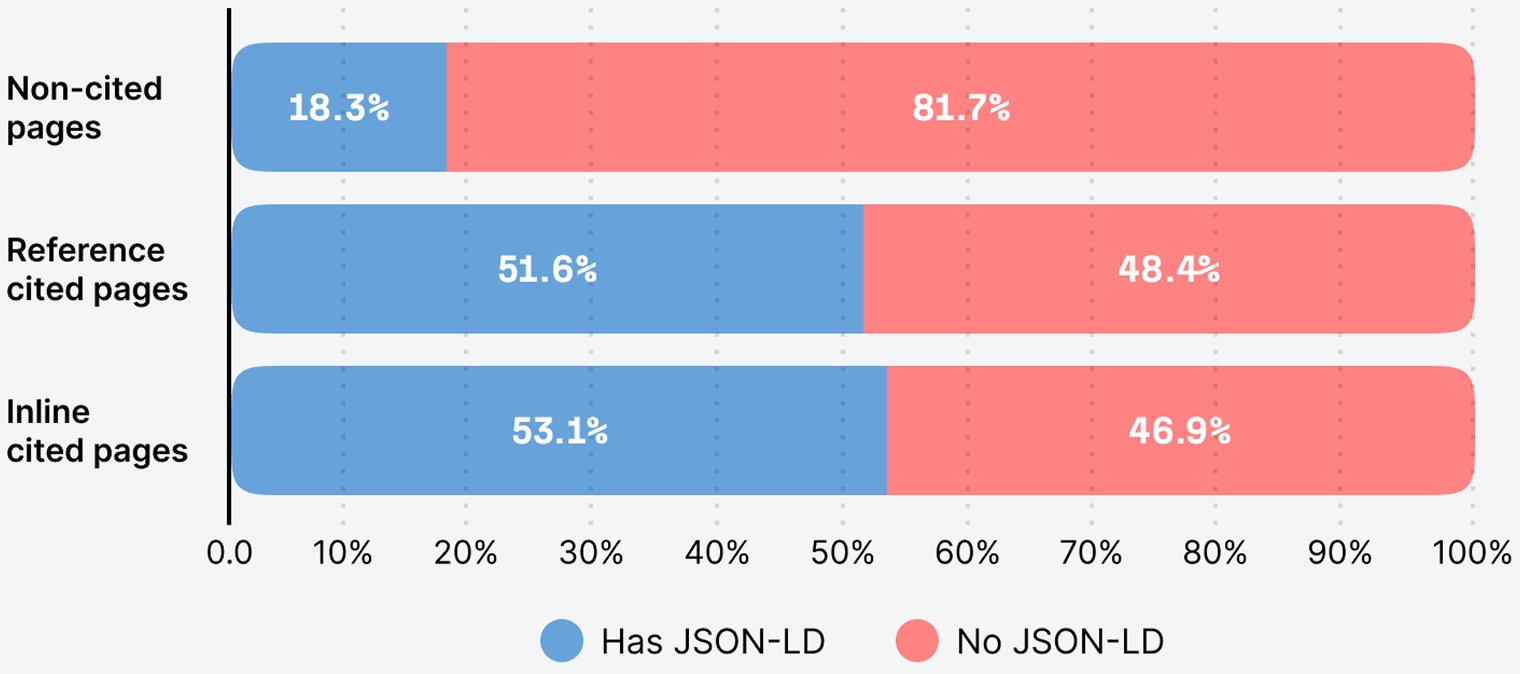
Korelacja nie oznacza jednak związku przyczynowego. Przeanalizowaliśmy 1885 stron, które dodały JSON-LD, i porównaliśmy je z 4000 stronami kontrolnymi. Nie stwierdziliśmy istotnego wzrostu widoczności w AI Mode ani w ChatGPT, natomiast odnotowaliśmy niewielki spadek w AI Overviews, którego nie udało się jednoznacznie powiązać z wykorzystaniem danych strukturalnych.
Czy zatem znaczniki schematu są bezużyteczne? Nie, ale ich rola jest powolna i pośrednia, nie jest to taktyka przynosząca szybkie efekty.
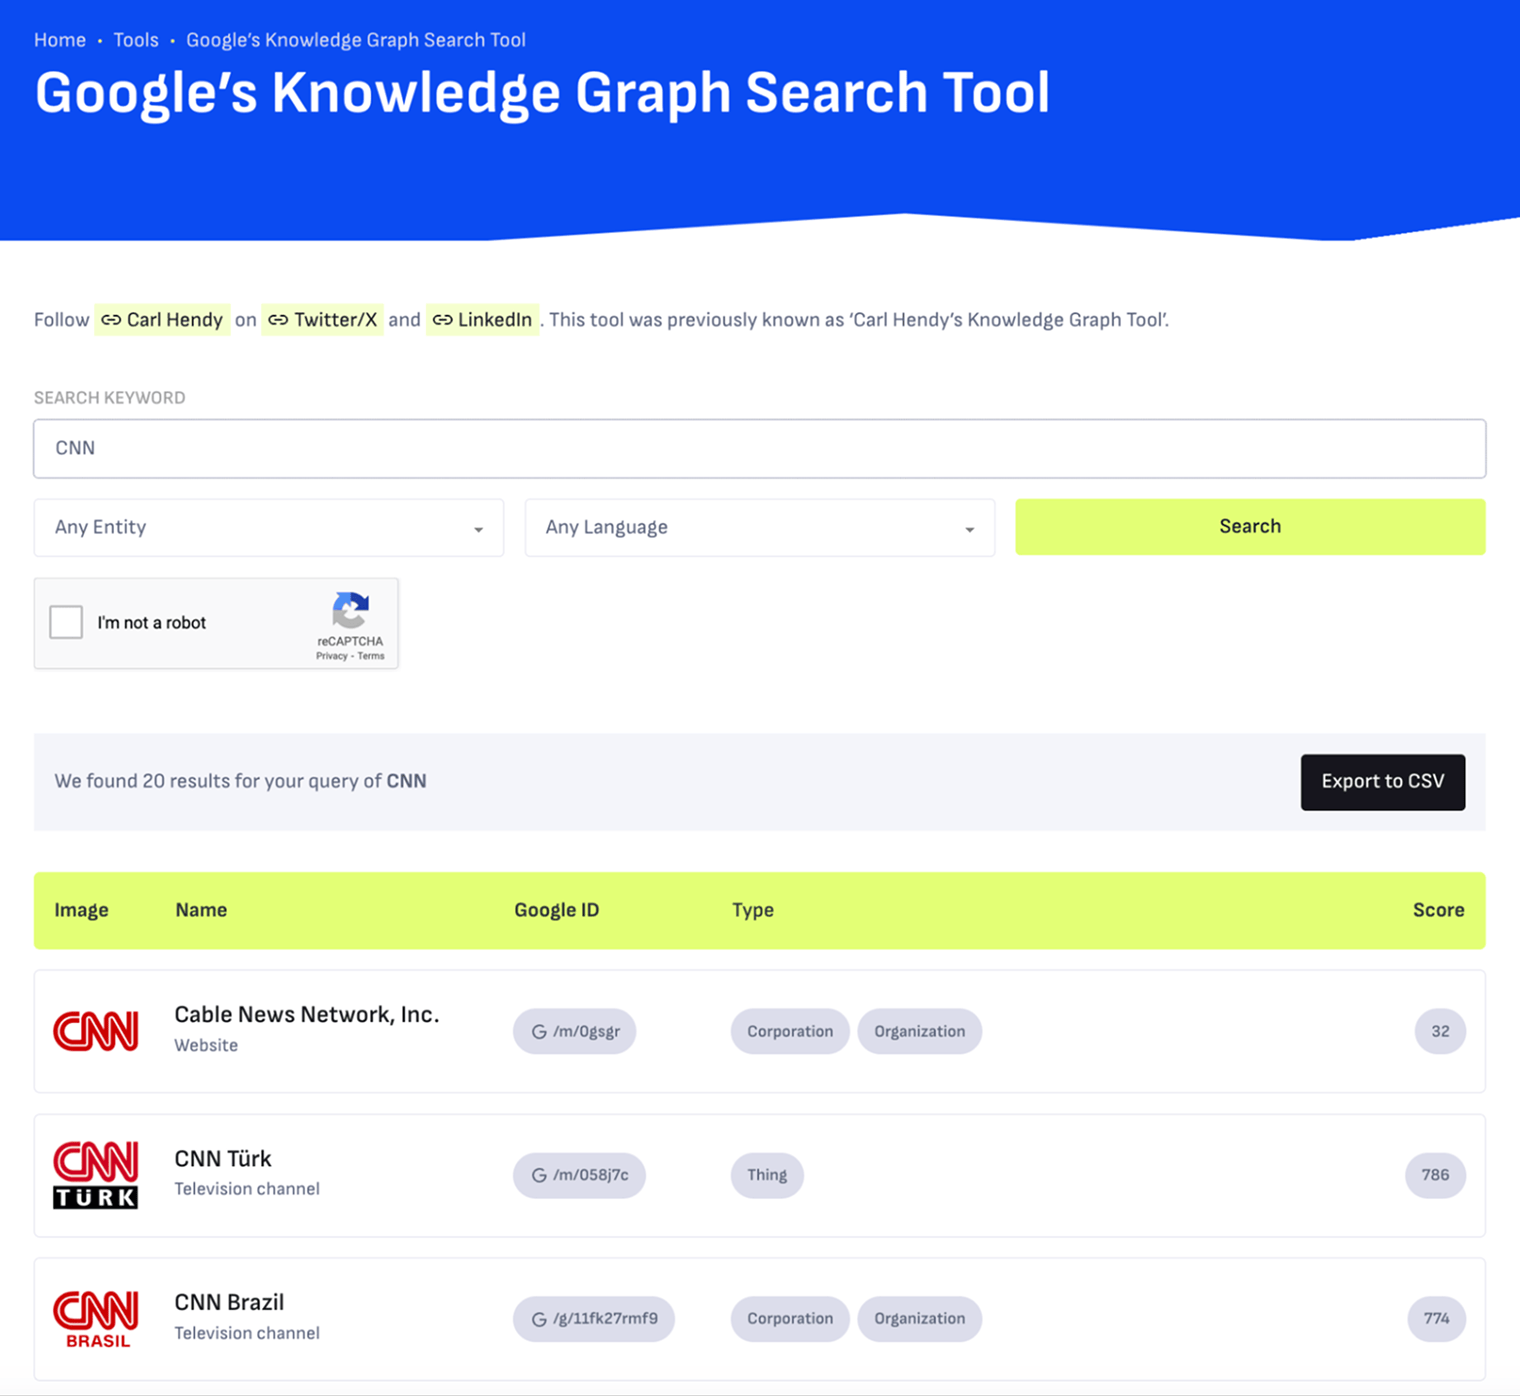
Możesz sprawdzić, czy Google już Cię rozpoznaje, korzystając z Knowledge Graph API Google lub bezpłatnego narzędzia, które pokaże, jaki typ encji został Ci przypisany i czy jej atrybuty są prawidłowe.
Na przykład narzędzie Knowledge Graph Carla Hendy’ego pokazuje wyniki dotyczące osób, firm, produktów, miejsc i innych encji.
Następnie postaraj się zdobywać wzmianki w wiarygodnych publikacjach i zadbaj o spójność informacji we wszystkich miejscach: ta sama nazwa, opis i kategoria w Twojej witrynie, profilach społecznościowych oraz w zewnętrznych katalogach.
Następnie dodaj znaczniki schematu tam, gdzie jest to naturalne, w pierwszej kolejności uwzględniając typy, które najlepiej definiują Twoją encję i jej relacje:
Znaczniki schematu Organization i sameAs łączące Twoją organizację z jej profilami w Wikipedii, Wikidanych oraz w mediach społecznościowych
Znaczniki „Person” dla autorów w Twojej witrynie
Znaczniki „Product” dla oferowanych produktów
Porada
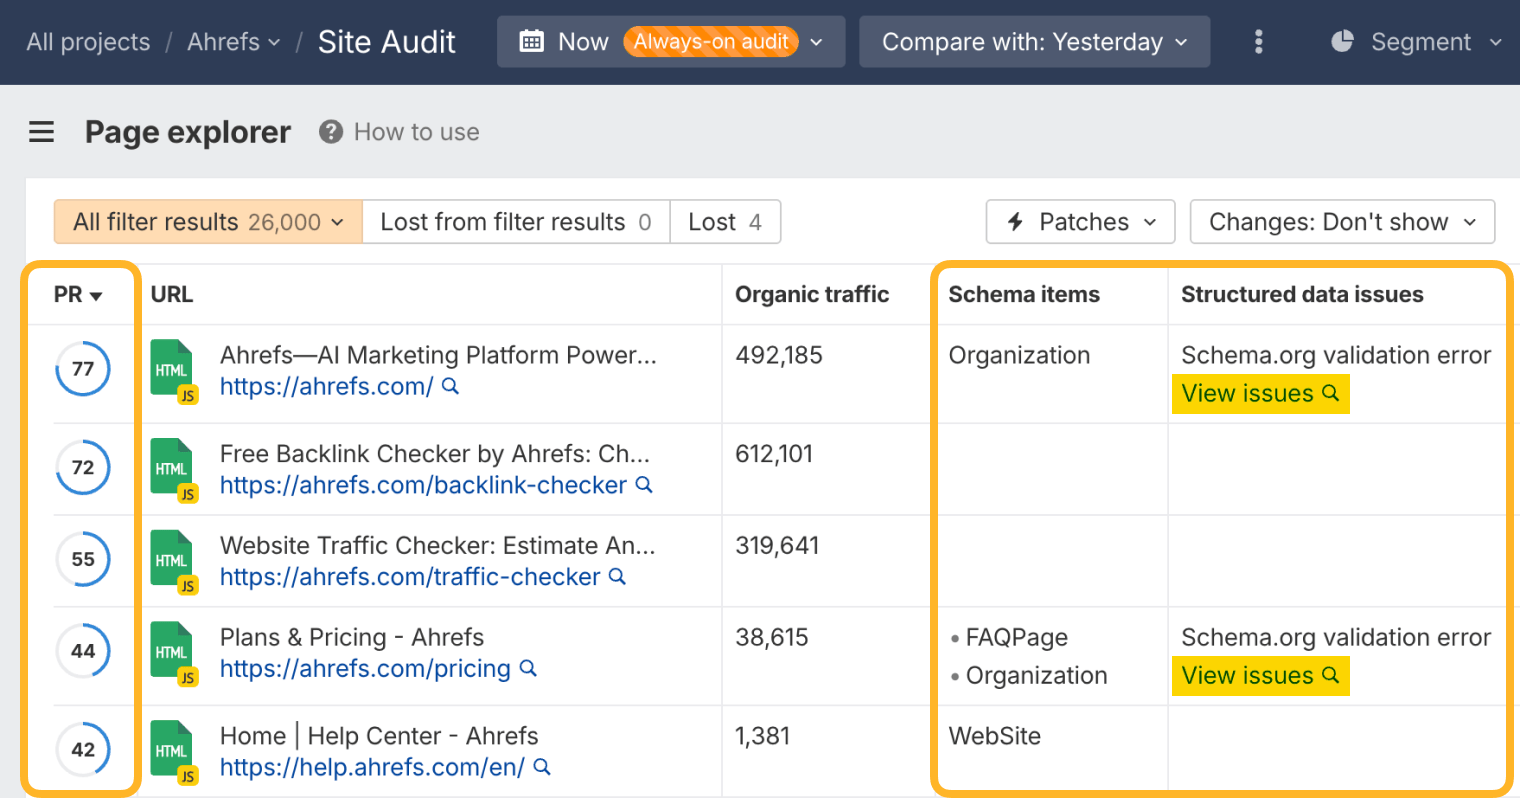
Znajdź swoje strony o najwyższym autorytecie i upewnij się, że zawierają poprawne znaczniki schematu.
Możesz to zrobić, przechodząc do raportu Eksplorator stron w narzędziu Site Audit i sortując według „Oceny strony” (PR).
Ocena strony (PR) pokazuje siłę profilu linków wewnętrznych i zewnętrznych Twojego adresu URL w porównaniu z innymi adresami URL uwzględnionymi w skanowaniu.
Następnie sprawdź kolumnę „Znaczniki schematu”, aby przeprowadzić audyt istniejących danych strukturalnych, oraz kolumnę „Problemy z danymi uporządkowanymi”, aby wykryć brakujące lub nieprawidłowe dane strukturalne.
Przygotuj się na marketing oparty na komunikacji między agentami AI
Na koniec zostawię Cię z jedną myślą: coraz więcej „czytelników”, na których próbujesz wpłynąć, to tak naprawdę agenci AI, którzy w imieniu Twoich odbiorców przeglądają oferty i dokonują zakupów.
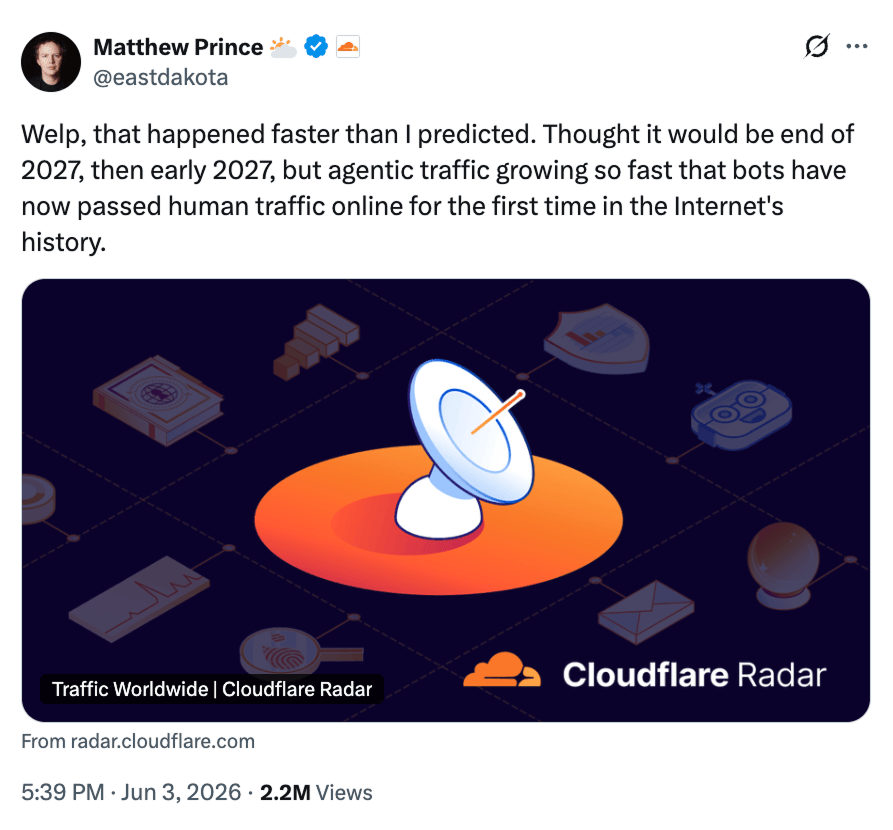
W czerwcu 2026 roku Matthew Prince, dyrektor generalny Cloudflare, ujawnił, że ruch agentowy (generowany przez boty, roboty internetowe i agentów) po raz pierwszy w historii internetu przekroczył poziom 50%2, 3.
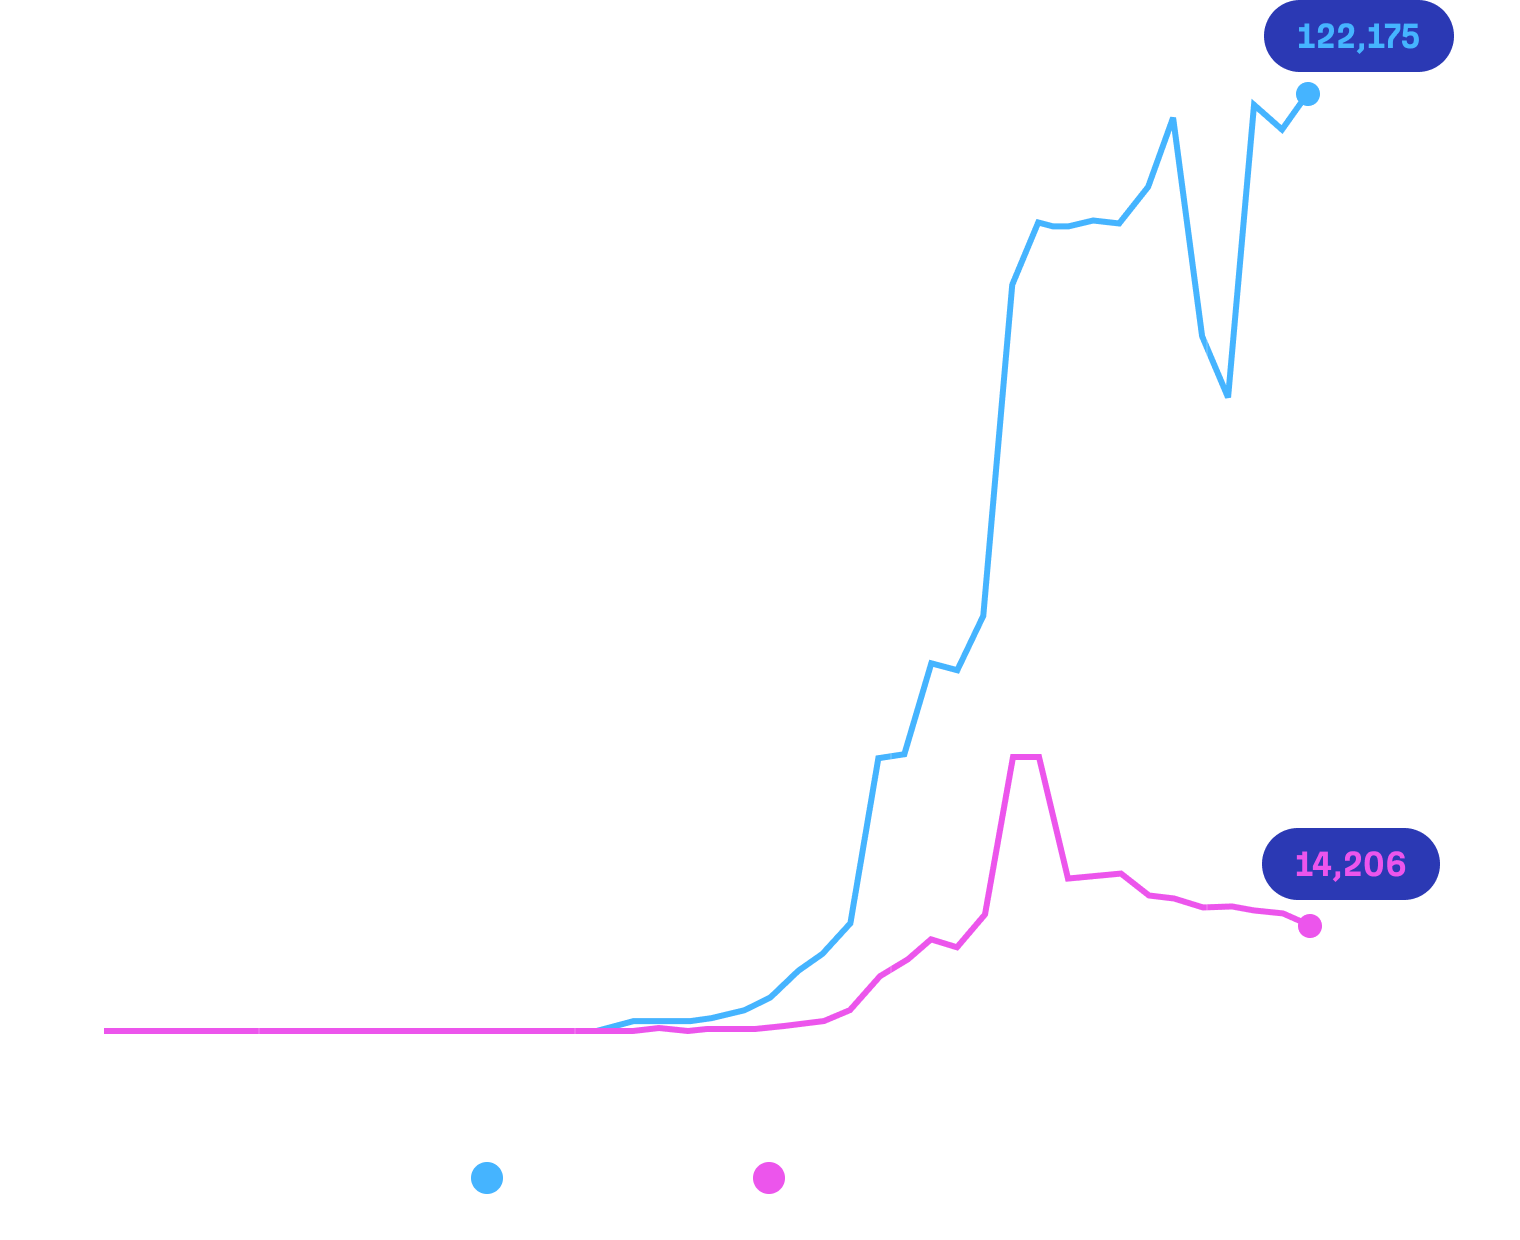
To nie jest niszowy przypadek ani chwilowa moda: liczba wyszukiwań frazy „agentic AI” wzrosła w ciągu trzech lat 84-krotnie, ponieważ koszt uruchomienia agenta spadł z kilku dolarów do kilku centów.
Warto przeczytać
Nie musisz jeszcze przebudowywać swojej witryny wyłącznie pod agentów AI. Jednak stara rada, aby tworzyć treści wyłącznie dla ludzi i nie przejmować się robotami, chyba nie jest już tak aktualna jak kiedyś.
Ten rozdział dotyczy wpływania na AI, któremu ufa człowiek, a marketing między agentami właśnie na tym polega – tylko idzie o krok dalej.
Odniesienia
- „ChatGPT Is a Search Engine. Here’s How It Works.” David McSweeney, QueryBurst.
- Matthew Prince (@eastdakota) na X. 3 czerwca 2026.
Louise jest specjalistką ds. marketingu treści w Ahrefs. Przez ostatnią dekadę zajmowała kierownicze stanowiska związane z marketingiem treści w firmach z branży SaaS: Pi Datametrics, BuzzSumo i Cision. W tym czasie opublikowała setki artykułów na blogach, kierowała projektami badawczymi o dużym znaczeniu dla branży oraz opracowywała programy webinarów prowadzonych przez ekspertów.
Louise poznała podstawy SEO podczas pracy w Pi, firmie specjalizującej się w SEO dla przedsiębiorstw. W ciągu kilku tygodni od rozpoczęcia pracy opublikowała artykuł o kanibalizacji słów kluczowych, który zwrócił uwagę jednej z najbardziej znanych wówczas postaci w świecie SEO – Randa Fishkina. Od tego czasu pisała na tematy obejmujące m.in. manipulacyjne budowanie linków, syndykację treści oraz prognozowanie popytu w wyszukiwarce. W wolnym czasie pogłębia swoją praktyczną wiedzę na temat SEO, tworząc strony internetowe dla dwóch lokalnych firm.
Teksty Louise można znaleźć w branżowych publikacjach, takich jak Search Engine Watch, The Drum, The Telegraph i Spin Sucks.
Sprawdź wszystkie poradniki dotyczące AEO
Czym jest optymalizacja pod silniki odpowiedzi (AEO)?
Od tego zacznij. Dowiedz się, czym jest AEO, czym różni się ono od SEO i poznaj siedem kroków, od których warto zacząć.
Jak działają silniki odpowiedzi?
Co naprawdę następuje pomiędzy wpisaniem promptu a wygenerowaniem odpowiedzi – i gdzie w tym procesie może pojawić się Twoja marka?
Jak monitorować widoczność w AI
Nie da się zoptymalizować czegoś, czego nie widać. Oto siedem sposobów na sprawdzenie, w których miejscach Twoja marka pojawia się w odpowiedziach wygenerowanych przez AI.
Jak wybrać najlepsze prompty, które warto monitorować?
Monitoruj klastry promptów zamiast pojedynczych odpowiedzi. Oto jedenaście miejsc, w których znajdziesz zapytania warte monitorowania.
Jak optymalizować treści pod silniki odpowiedzi?
Wysokie pozycjonowanie sprawia, że inni Cię zauważają. Oto jak uzyskać cytowania – przedstawiamy tematy, formaty oraz zmiany na stronie, które naprawdę działają.
Jak monitorować i zdobywać wzmianki o marce w odpowiedziach AI?
AI poleca te marki, o których dyskutowano w innych miejscach. Oto jak monitorować te wzmianki i zdobywać ich więcej.
Jak zoptymalizować witrynę pod silniki odpowiedzi?
Poprawki techniczne, które decydują o tym, czy AI jest w stanie dotrzeć do Twoich stron, odczytać je i zrozumieć, kim jesteś.