
Як оптимізувати вебсайт для пошукових систем відповідей
Автор: Louise Linehan
Контент-маркетолог в Ahrefs
Навіть чудовий та якісний контент може так і не потрапити у відповіді ШІ.
Кожен методи оптимізації для ШІ передбачає, що системи ШІ можуть отримати доступ до ваших сторінок, прочитати їх і зрозуміти, хто ви. Але це зовсім не гарантовано. Приблизно 5,89 % вебсайтів повністю блокують GPTBot, ChatGPT, схоже, припиняє завантаження сторінок, які не відповідають протягом приблизно двох секунд, а більшість ШІ-сканерів узагалі не виконують JavaScript.
Хороша новина полягає в тому, що цю частину AEO виправити найпростіше. Окремо жоден із цих заходів не забезпечить вам цитування, але будь-яка з цих проблем може непомітно позбавити вас усіх цитувань, які ви могли б отримати.
Продовжуйте навчання на YouTube
Не блокуйте сканери ШІ у файлі robots.txt
Жодна з порад у цьому посібнику не допоможе, якщо ШІ-сканери не можуть прочитати ваші сторінки. Заблоковані сторінки неможливо цитувати, причому сторінки нерідко виявляються заблокованими випадково.
Ми проаналізували приблизно 140 мільйонів вебсайтів і виявили, що GPTBot зараз блокують найчастіше серед усіх ШІ-ботів (на 5,89 % вебсайтів), а ClaudeBot посідає друге місце з невеликим відривом.
Cloudflare за замовчуванням блокує платформи ШІ, тому перевірте, чи раптом ваш CDN непомітно не заблокував їм доступ.
Не можна просто «дозволити ШІ-сканери», адже кожна платформа використовує кілька ботів для різних завдань.
Лише в OpenAI їх три:
- GPTBot збирає контент для навчання моделей
- OAI-SearchBot формує пошуковий індекс, з якого ChatGPT отримує дані
- ChatGPT-User отримує актуальну версію сторінки, коли користувач запитує про неї під час розмови
Наслідки блокування цих ботів різні. Блокуючи GPTBot, ви не дозволяєте використовувати свій контент для навчання наступної моделі — зазвичай саме це питання й постає перед видавцями. Натомість блокування OAI-SearchBot виключає ваш вебсайт із пошукового індексу ChatGPT, через що ви вже зараз втрачаєте цитування та реферальний трафік. Багато вебсайтів ненавмисно блокують OAI-SearchBot, хоча хотіли обмежити лише GPTBot.
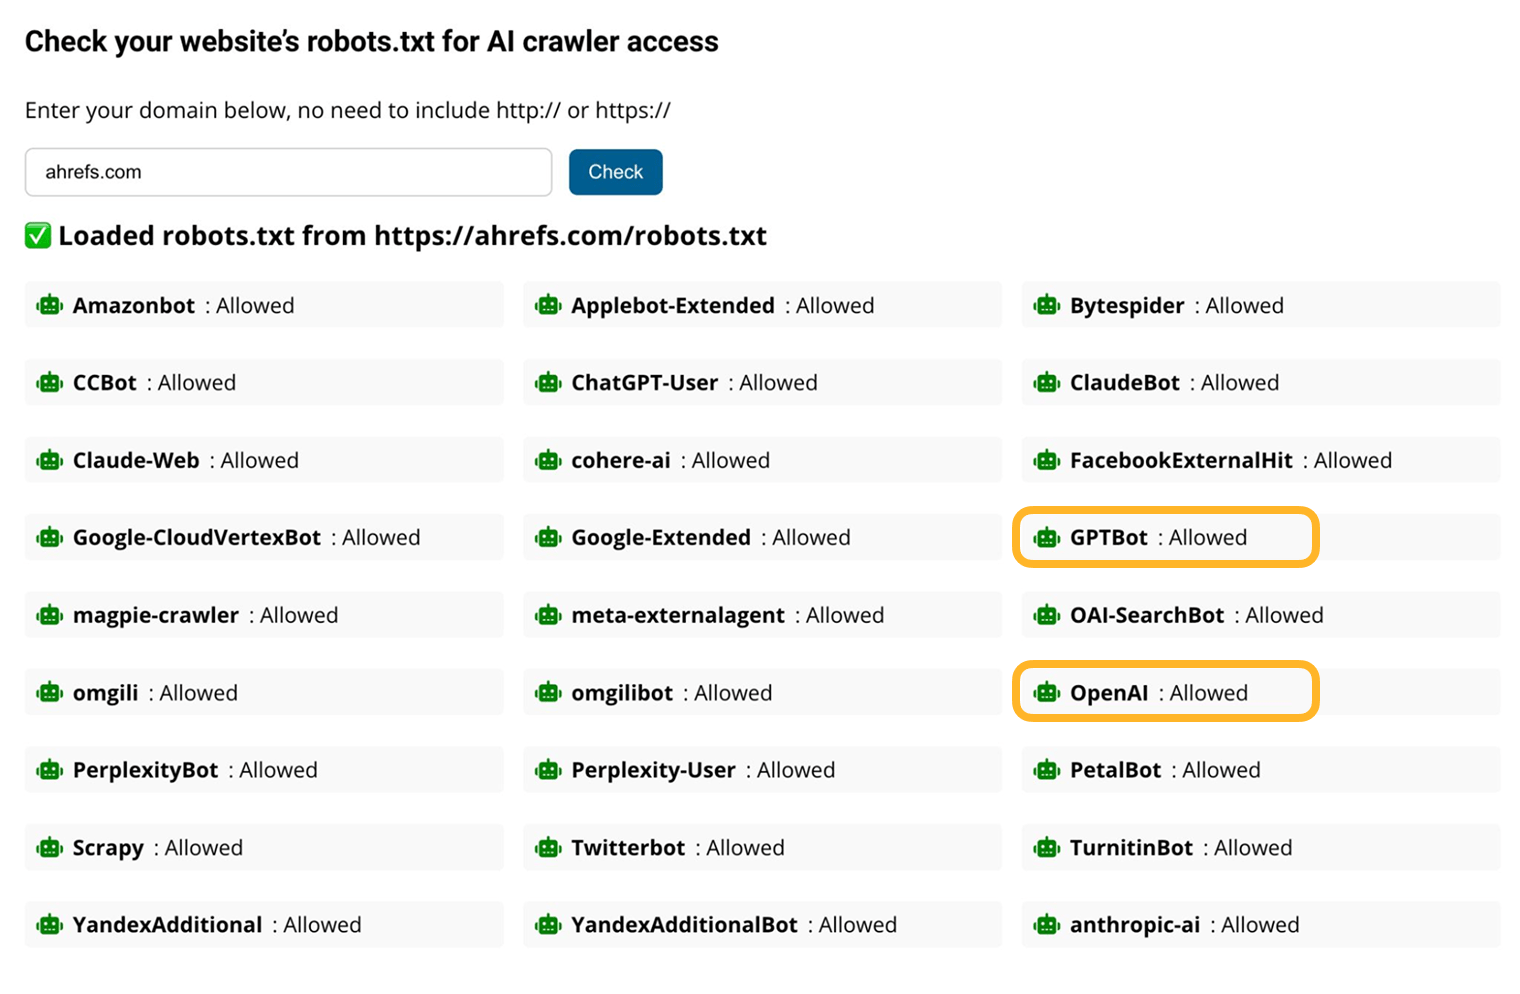
Найшвидший спосіб перевірити, які сканери мають доступ до вашого вебсайту, — скористатися AI Crawler Access Checker. Цей інструмент аналізує файл robots.txt і показує, яким сканерам це дозволено.
Щоб дізнатися, які боти насправді відвідують ваш вебсайт, а не лише яким із них дозволено доступ, скористайтеся Bot Analytics від Ahrefs. Цей інструмент відстежує відвідування ботів за 12 категоріями, зокрема за допомогою окремого фільтра ШІ, використовуючи серверні дані через Cloudflare, тому додавати JavaScript на вебсайт не потрібно.
Не робіть контент залежним від JavaScript
ШІ-сканери зазвичай читають вихідний HTML-код і здебільшого не виконують рендеринг JavaScript так, як це робить браузер.
Це означає, що контент, який з’являється лише після виконання JS на боці клієнта, може бути для них недоступним.
Для надійності використовуйте серверний рендеринг — так у вашої сторінки буде більше шансів стати видимою для ШІ.
Підвищте швидкість сторінки
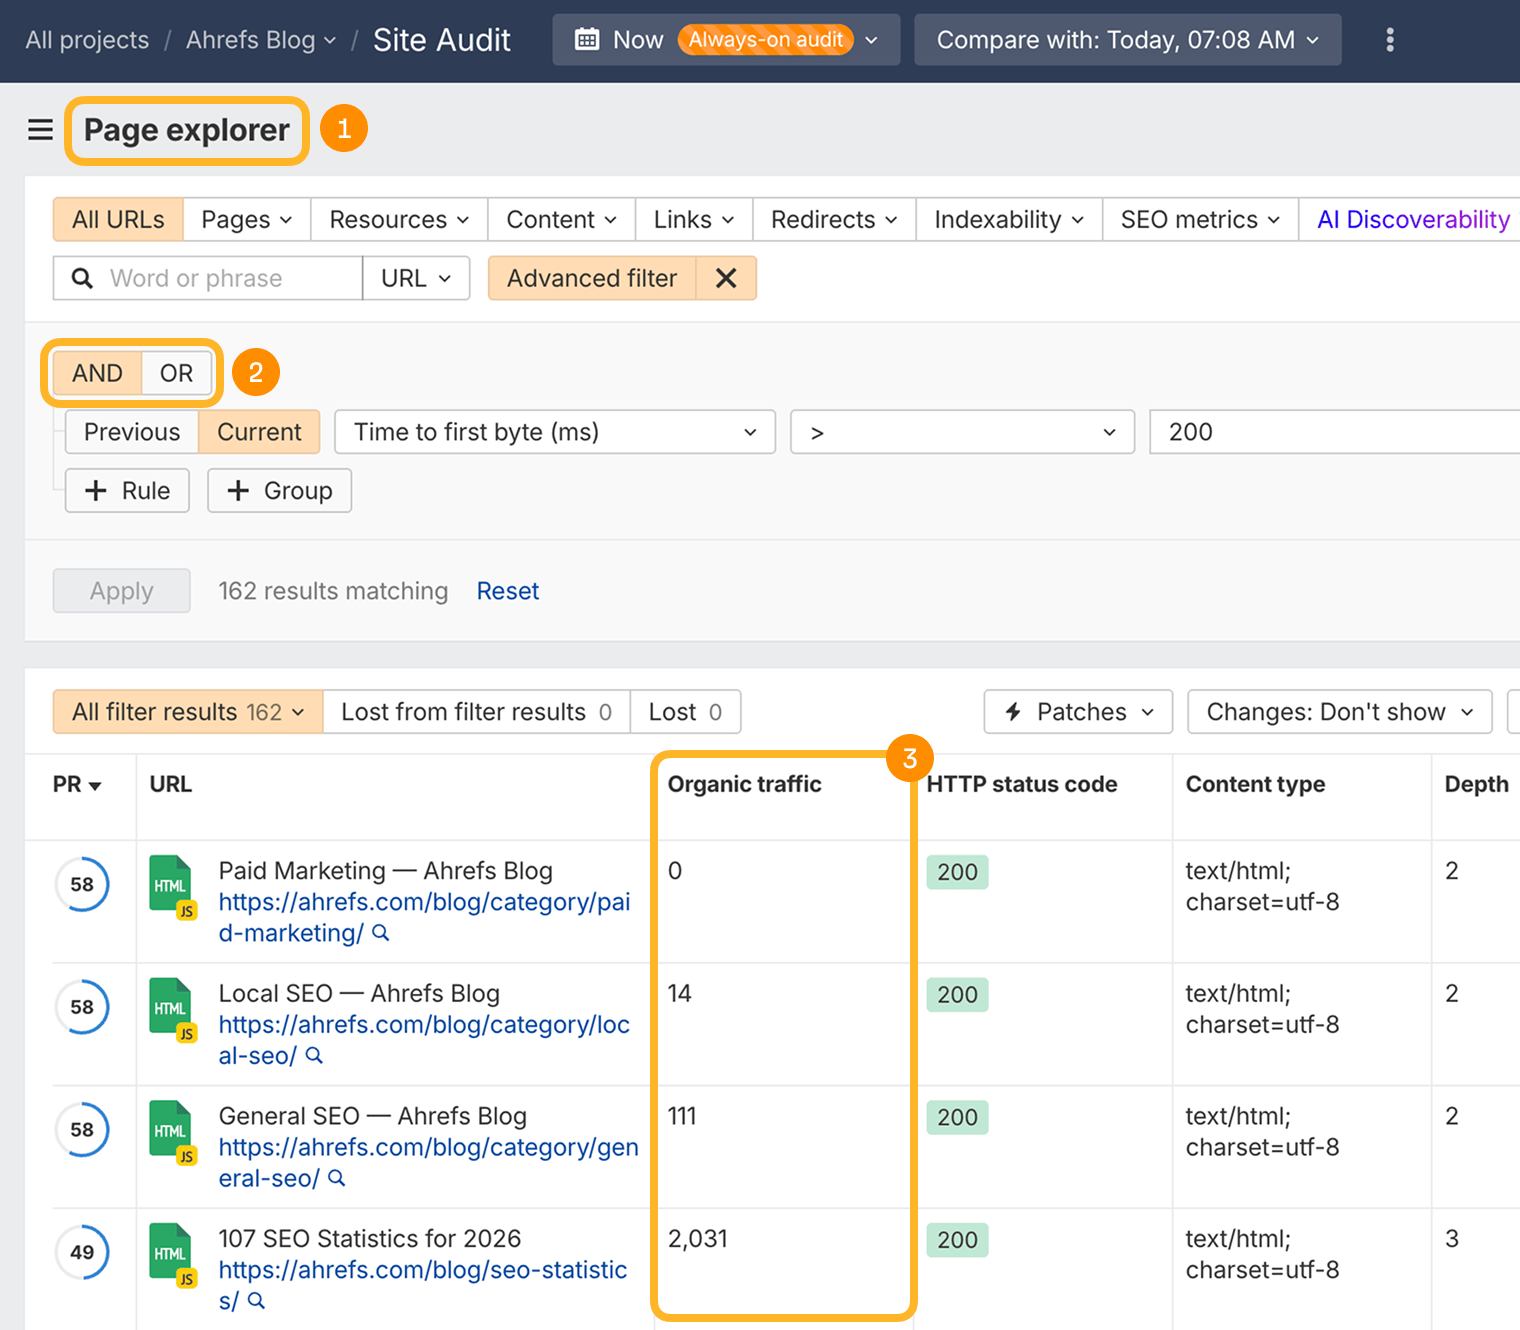
Повільне завантаження сторінок може негативно впливати на ефективність у звичайному пошуку, але в системах відповідей наслідки, здається, ще серйозніші. Від швидкості сторінки може залежати, чи потрапить вона до контекстного вікна моделі взагалі.1
Перевірте швидкість сторінки (час до першого байт) у Site Audit:
Не витрачайте час на llms.txt
llms.txt — це запропонований стандарт Markdown-файлу в кореневому домені вебсайту (наприклад, website.com/llms.txt), який указує LLM, де розміщено ваш найважливіший контент: документацію, політики та класифікації продуктів. По суті, це аналог robots.txt для мовних моделей.
Але на практиці жоден великий постачальник LLM — ані OpenAI, ані Anthropic, ані Google — не заявив, що його системи зчитуватимуть цей файл.
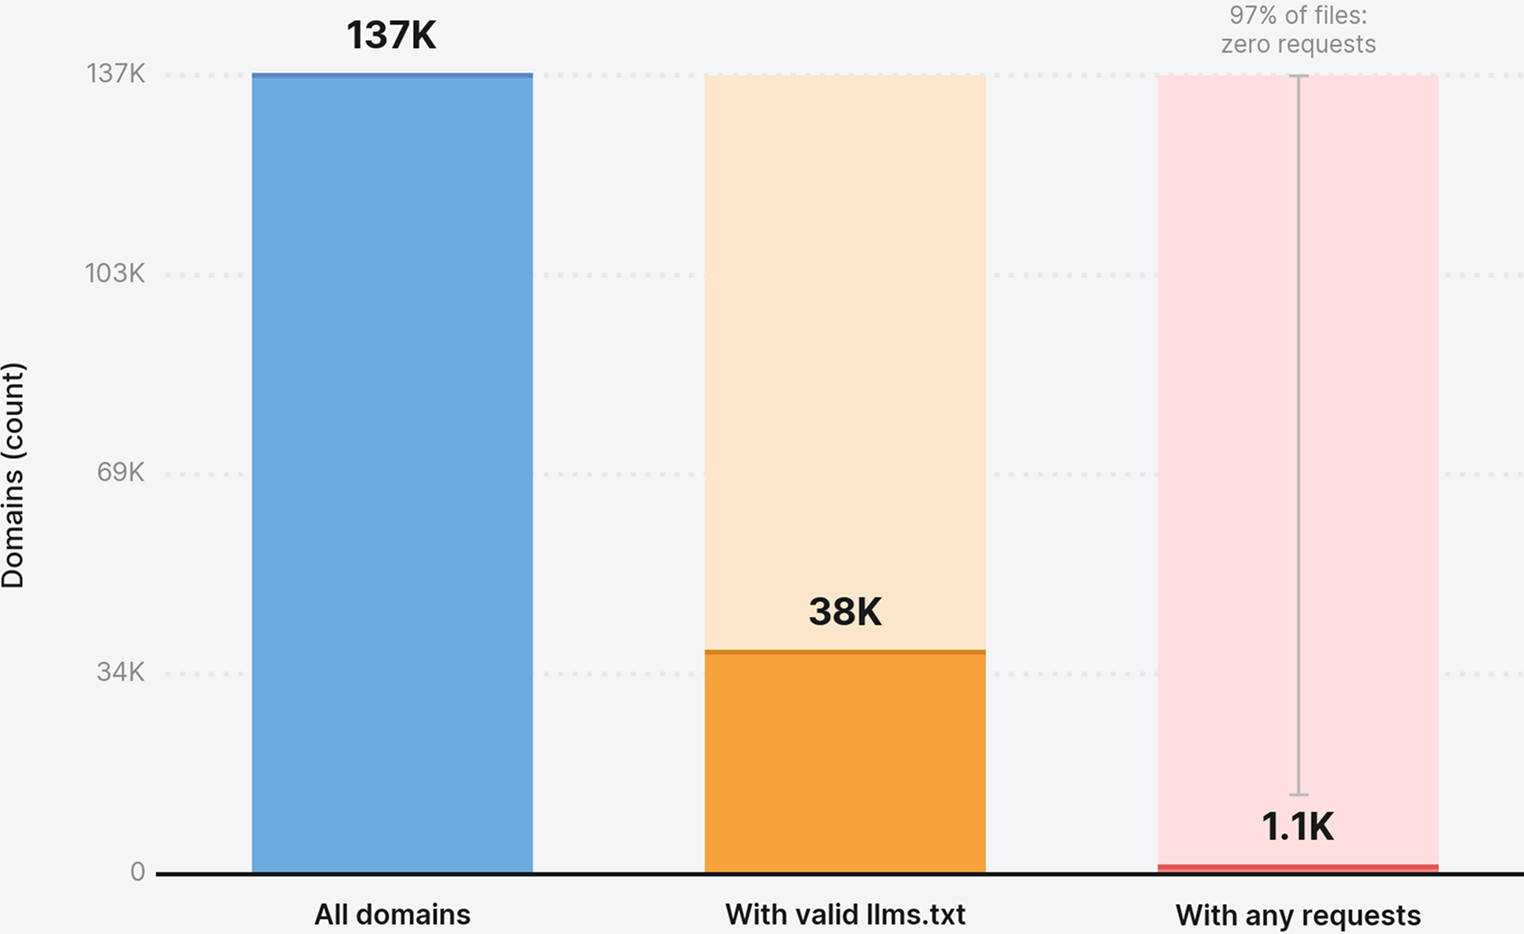
Ми перевірили, що насправді відбувається після додавання на вебсайт файлу llms.txt. Серед 137 000 доменів, які використовують Ahrefs Web Analytics, 28 % публікують файл llms.txt. З приблизно 38 000 доменів із дійсним файлом 97 % не отримали жодного запиту до нього протягом місяця, за який проводилися вимірювання.
97 % файлів llms.txt не отримують жодного запиту
Дослідження Ahrefs на основі 137 000 доменів, які використовують Ahrefs Web Analytics.
Серед невеликої частки файлів, які все ж було завантажено, 96 % запитів надійшли від ботів. Slackbot, бот для попереднього перегляду посилань, завантажував llms.txt частіше, ніж PerplexityBot. Простіше кажучи, здається, що найважливіші пошукові системи ШІ його не використовують.
Щодо цього Google висловлюється однозначно. У його посібнику з оптимізації для функцій генеративного ШІ є цілий розділ із назвою «Розвінчання міфів», де власникам вебсайтів пояснюють, що для появи в результатах пошуку з генеративним ШІ машиночитні файли на кшталт llms.txt не потрібні. Джон Мюллер пішов ще далі й порівняв llms.txt зі старим метатегом keywords:

Наскільки мені відомо, жоден із ШІ-сервісів не заявляв, що використовує файл LLMs.TXT (а з журналів сервера видно, що вони навіть не перевіряють його наявність). На мою думку, це можна порівняти з метатегом keywords: власник вебсайту вказує в ньому його тематику… (Але чи справді це так? Можна перевірити. А якщо вже перевіряти, то чому б не перевірити сам вебсайт?)
Джон Мюллер, представник Google із питань пошуку
То чи варто створювати такий файл? Якщо ви публікуєте документацію для розробників, це забере близько десяти хвилин і може мати практичну користь. Мюллер назвав його «тимчасовою милицею, яка, можливо, допоможе заощадити трохи токенів» для ШІ-інструментів програмування, що аналізують документацію. Для всіх інших це додаткова робота без вимірюваної користі, яка до того ж дещо полегшує конкурентам масове збирання вашого контенту.
Виправте URL-адреси вашого вебсайту, які вигадує ШІ
Асистенти ШІ вигадують посилання на ваш вебсайт, і роблять це часто. Ми перевірили HTTP-статус 16 мільйонів URL-адрес, які цитувалися в ChatGPT, Perplexity, Copilot, Gemini, Claude та Mistral, і з’ясували, що асистенти ШІ спрямовують користувачів на сторінки з помилкою 404 у 2,87 раза частіше, ніж Google Search.
У ChatGPT ситуація значно гірша: 1,01 % URL-адрес, за якими переходять користувачі, повертають помилку 404, тоді як базовий показник Google становить 0,15 %.
Частка помилок 404 за каналами переходів
Дані Вебаналітики — проаналізовано 16 000 000 URL-адрес.
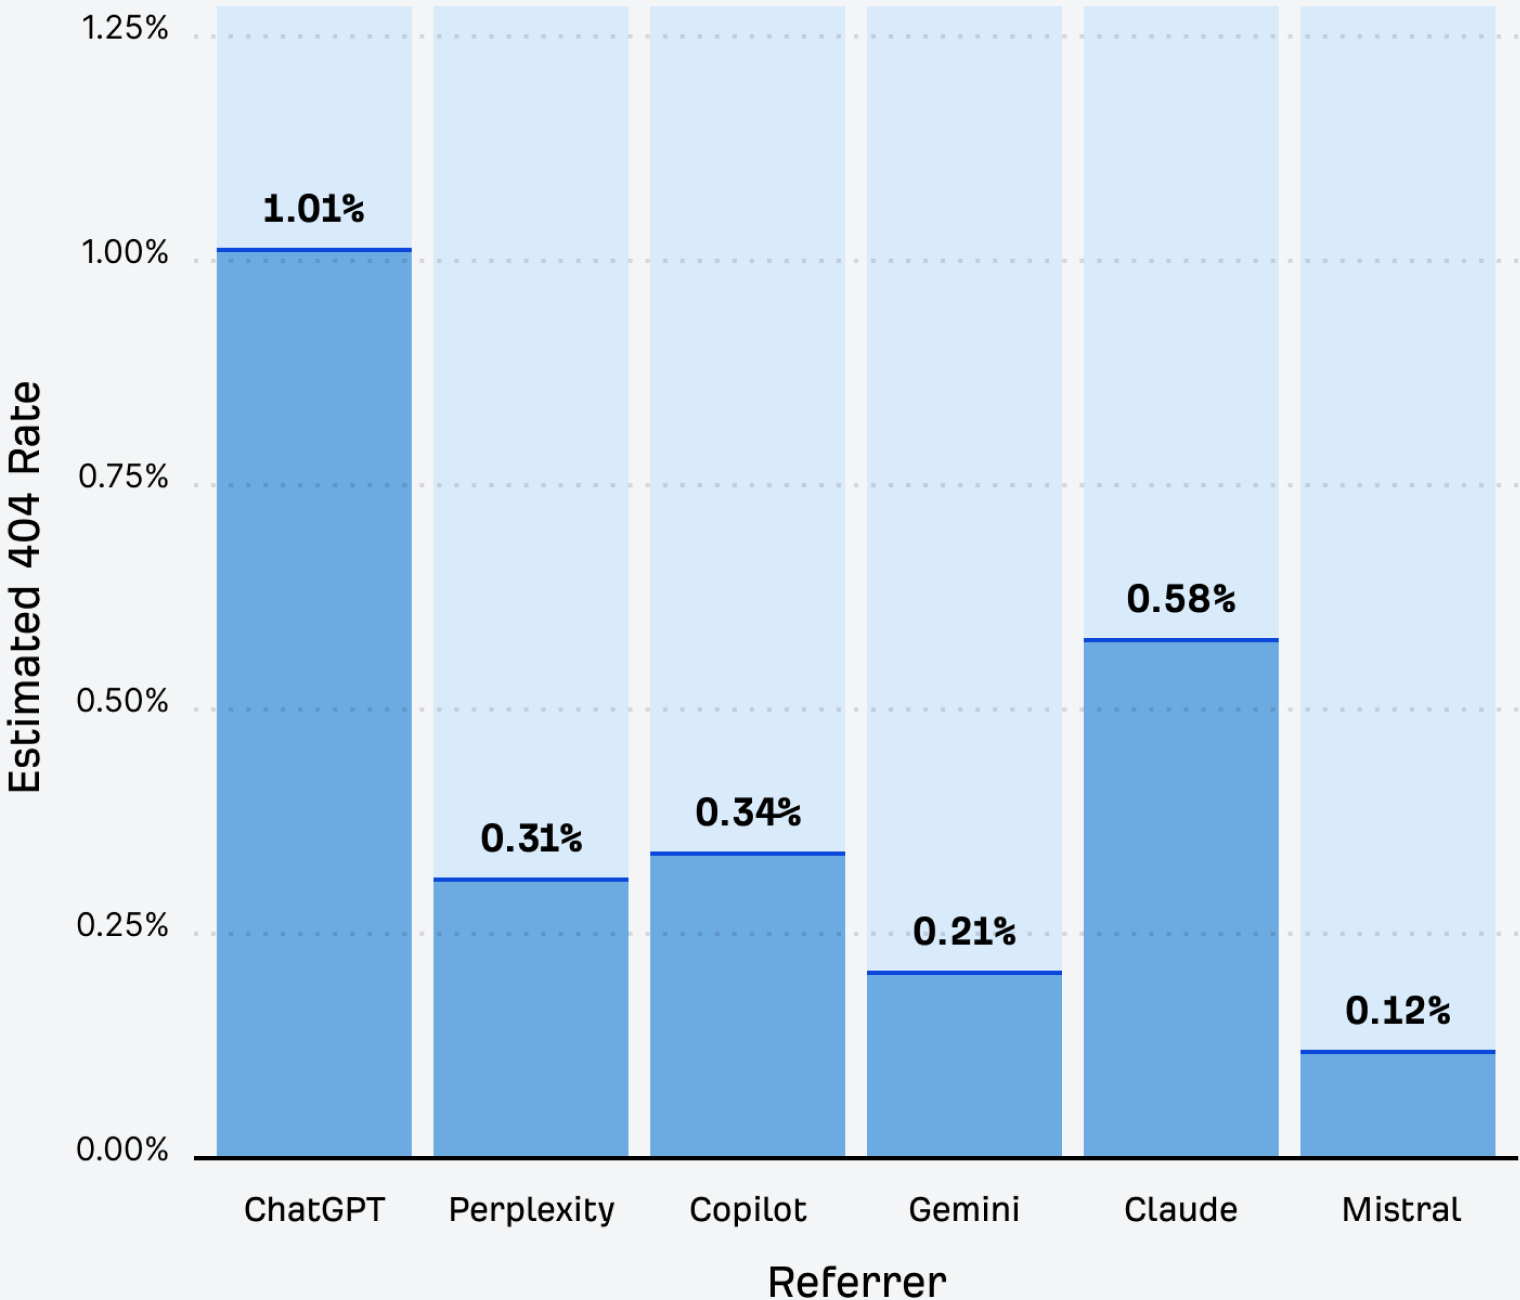
Показники Perplexity (0,87 %) і Gemini (0,86 %) майже збігаються з показником Google — 0,84 % — для цитованих URL-адрес. Це цілком логічно, адже обидві системи отримують дані з індексу Google, а отже, успадковують звідти пошкоджені посилання, а не вигадують власні.
Вигадані URL-адреси формуються на основі наявних закономірностей на вашому вебсайті. Наприклад, моделі часто вигадували для нашого вебсайту адресу ahrefs.com/keywords, бо ми постійно пишемо про ключові слова, тому модель припускала, що така сторінка має існувати. Але її немає.
Це одна з небагатьох можливостей покращити AEO без додаткових витрат. Користувач із чітким наміром запитав про ваш продукт, перейшов на ваш вебсайт і не знайшов того, що шукав. Тут можна виділити три типи ситуацій:
- Вигадані URL-адреси. Сторінки, які модель вигадала на основі структури ваших URL-адрес.
- Застарілі URL-адреси. Сторінки, які колись існували й збереглися в навчальних даних або інших застарілих джерелах даних.
- URL-адреси з помилками або в іншому варіанті. Адреси, які майже збігаються з URL-адресами реальних сторінок.
Саме тому ми додали до Вебаналітики фільтр, за допомогою якого вигадані URL-адреси можна знайти лише за два кліки. Якщо вам потрібна проста альтернатива Google Analytics для безплатного опрацювання до 1 мільйона подій на місяць, спробуйте це:
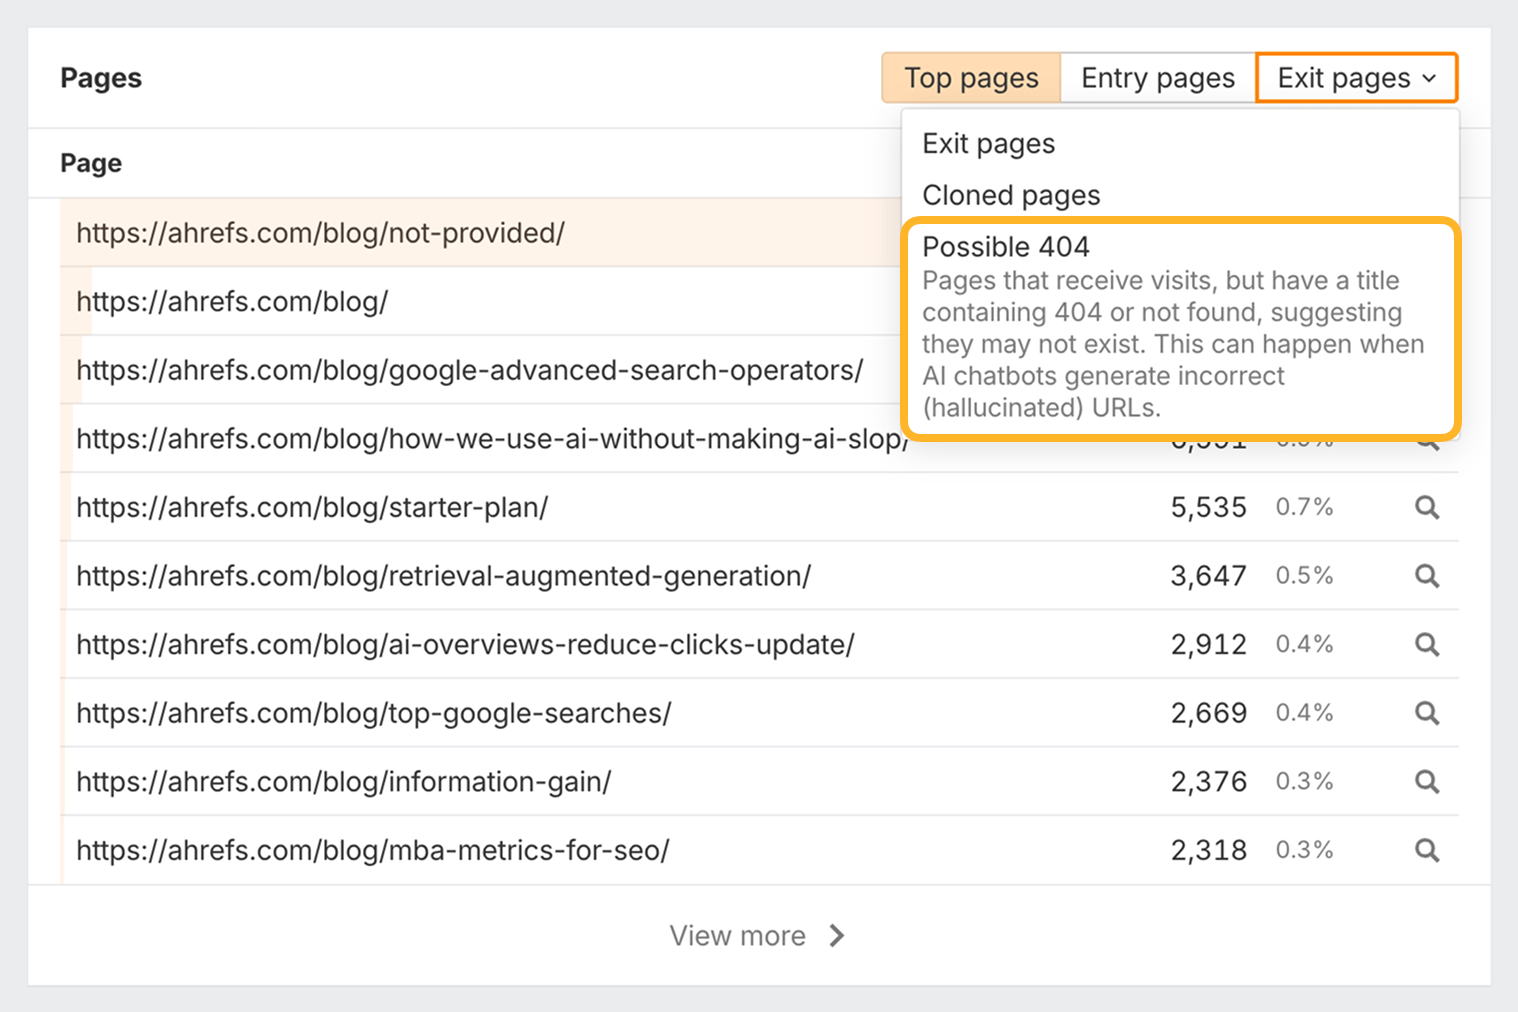
Якщо запити до вигаданої URL-адреси надходять знову й знову, модель підказує, яку сторінку очікують знайти ваші відвідувачі.
Допоможіть ШІ розпізнавати ваш бренд
Зрештою, ефективність усіх тактик, викладених у цьому посібнику, залежить від одного: чи розпізнають ШІ-системи ваш бренд як окрему сутність.
Чи знали ви?
Сутність — це будь-який окремий об’єкт реального світу, який пошукова система або ШІ може розпізнати й відрізнити від інших: конкретна людина, місце, компанія, продукт або поняття (наприклад, «Дмитро Герасименко», «Ahrefs» чи «Сінгапур»), а не просто слова, якими цей об’єкт описують.
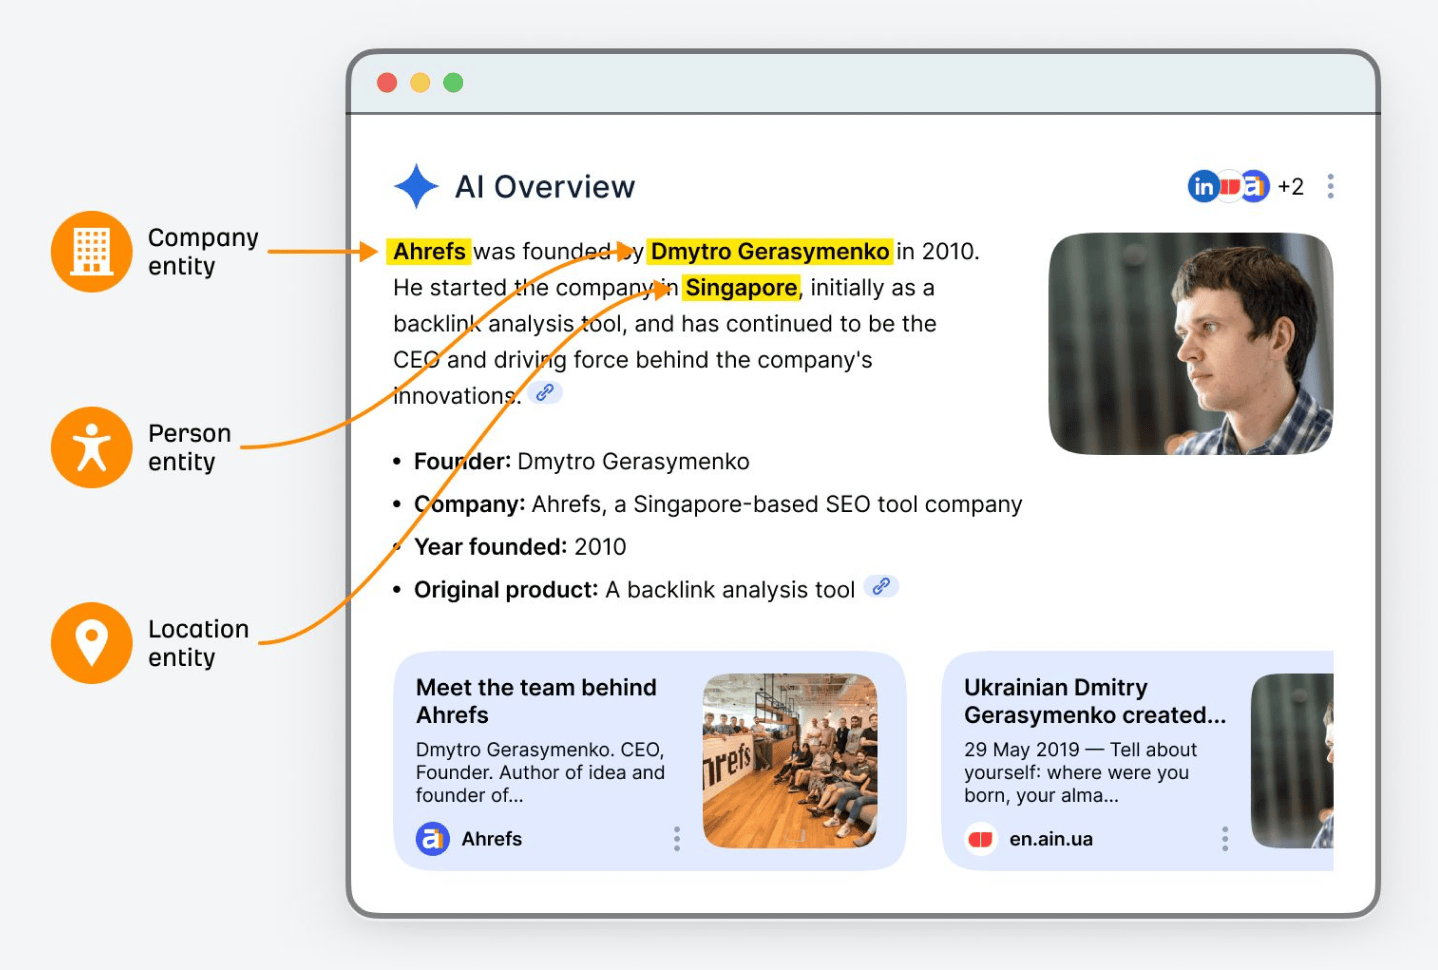
Knowledge Graph від Google — база даних, що містить 54 млрд сутностей і понад 1,6 трлн фактів про зв’язки між ними — тепер лежить в основі не лише панелей знань.
Тепер це основна інфраструктура для Оглядів від ШІ, AI Mode і Gemini.
Якщо ваш бренд не закріпився як окрема сутність, а на вашому вебсайті, у структурованих даних та на авторитетних сторонніх джерелах немає узгоджених сигналів про нього, ви ризикуєте втратити видимість не лише у звичайному пошуку, а й у відповідях ШІ.
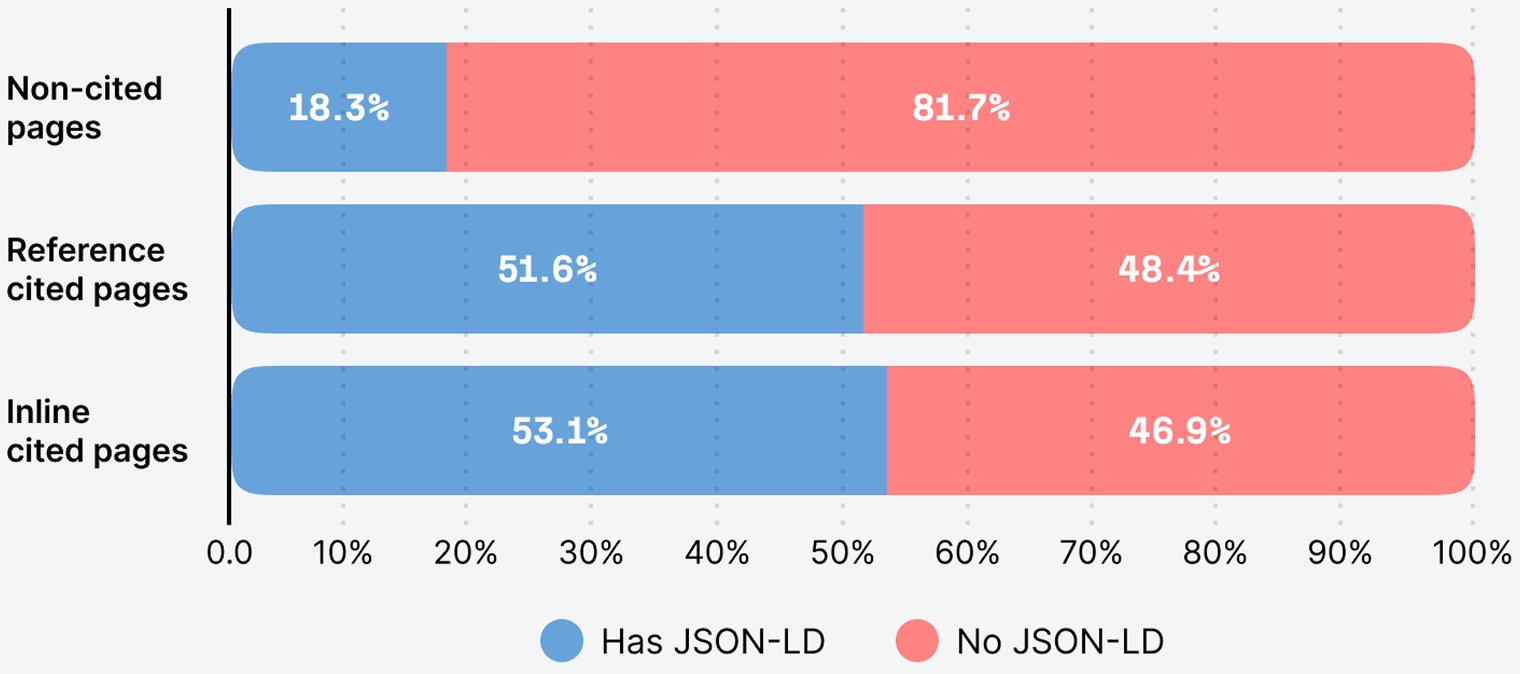
Розмітку Schema часто представляють як швидкий спосіб підвищити видимість у ШІ, і, на перший погляд, кореляція здається переконливою: на сторінках, які цитує ШІ, JSON-LD трапляється майже втричі частіше.
Розмітка Schema значно частіше трапляється на сторінках, які цитує ШІ
Дослідження Ahrefs на основі 6 млн сторінок (по 2 млн сторінок у кожній групі).
Але кореляція ще не є причиною. Ми відстежили 1885 сторінок, на яких додали JSON-LD, і порівняли їх із 4000 контрольних сторінок. Ми не виявили помітного збільшення показників в AI Mode або ChatGPT, а невелике зменшення в Оглядах від ШІ не вдалося пов’язати саме з розміткою.
То чи означає це, що розмітка Schema марна? Ні, але її вплив проявляється повільно й опосередковано, тож це не спосіб для швидкого отримання результату.
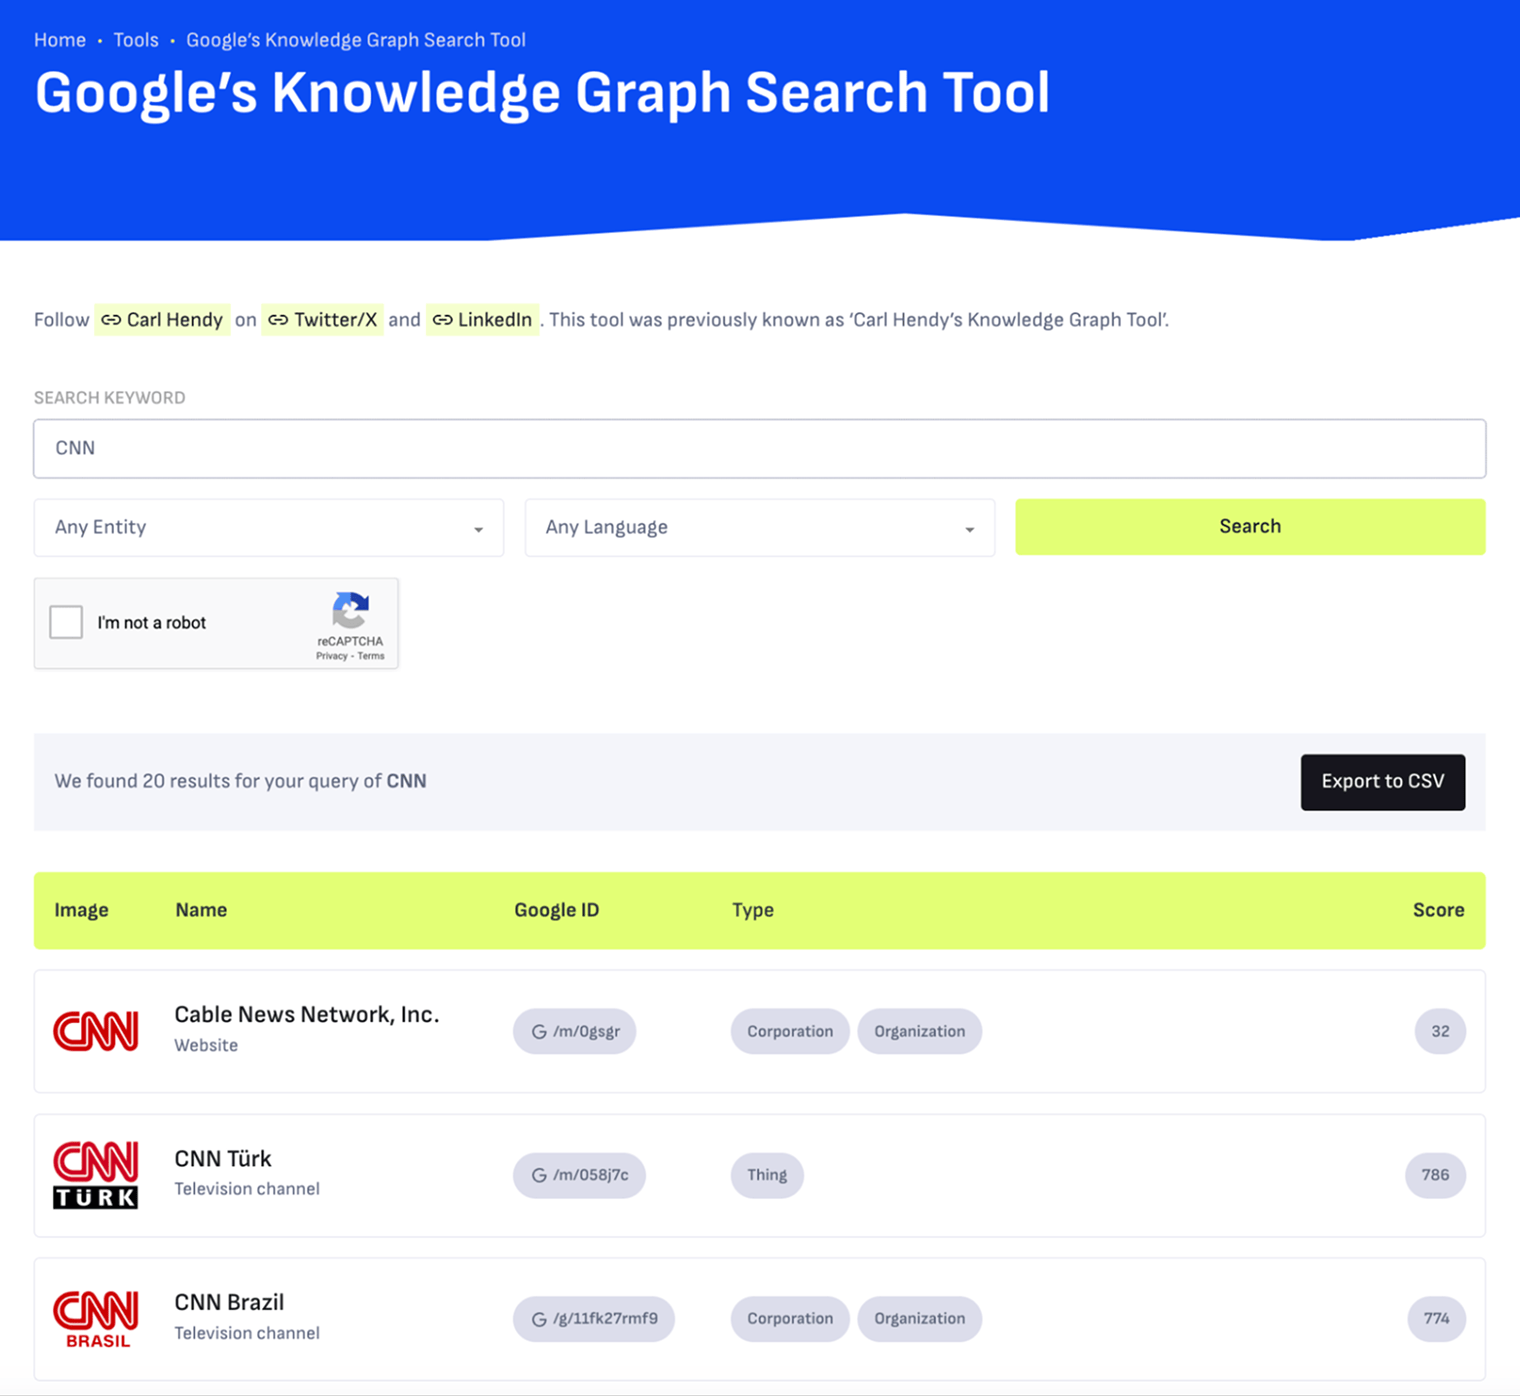
Перевірити, чи Google уже розпізнає вас як сутність, можна за допомогою Knowledge Graph API від Google або безплатного інструмента перевірки. Так ви побачите, який тип сутності вам призначено й чи правильно вказано її атрибути.
Наприклад, інструмент Knowledge Graph Карла Генді показує результати для людей, компаній, продуктів, місць та інших сутностей.
Далі намагайтеся отримувати згадки в авторитетних виданнях і стежте за узгодженістю фактів про бренд: назва, опис і категорія мають бути однаковими як на вашому вебсайті, так і в профілях і сторонніх каталогах.
Потім додайте розмітку Schema там, де це доречно, насамперед ті її типи, які описують вашу сутність і зв’язки з іншими сутностями:
Розмітка Organization і sameAs із посиланнями на ваші профілі у Wikipedia, Wikidata та соціальних мережах
Розмітка Person для авторів вашого вебсайту
Розмітка Product для ваших продуктів
Порада
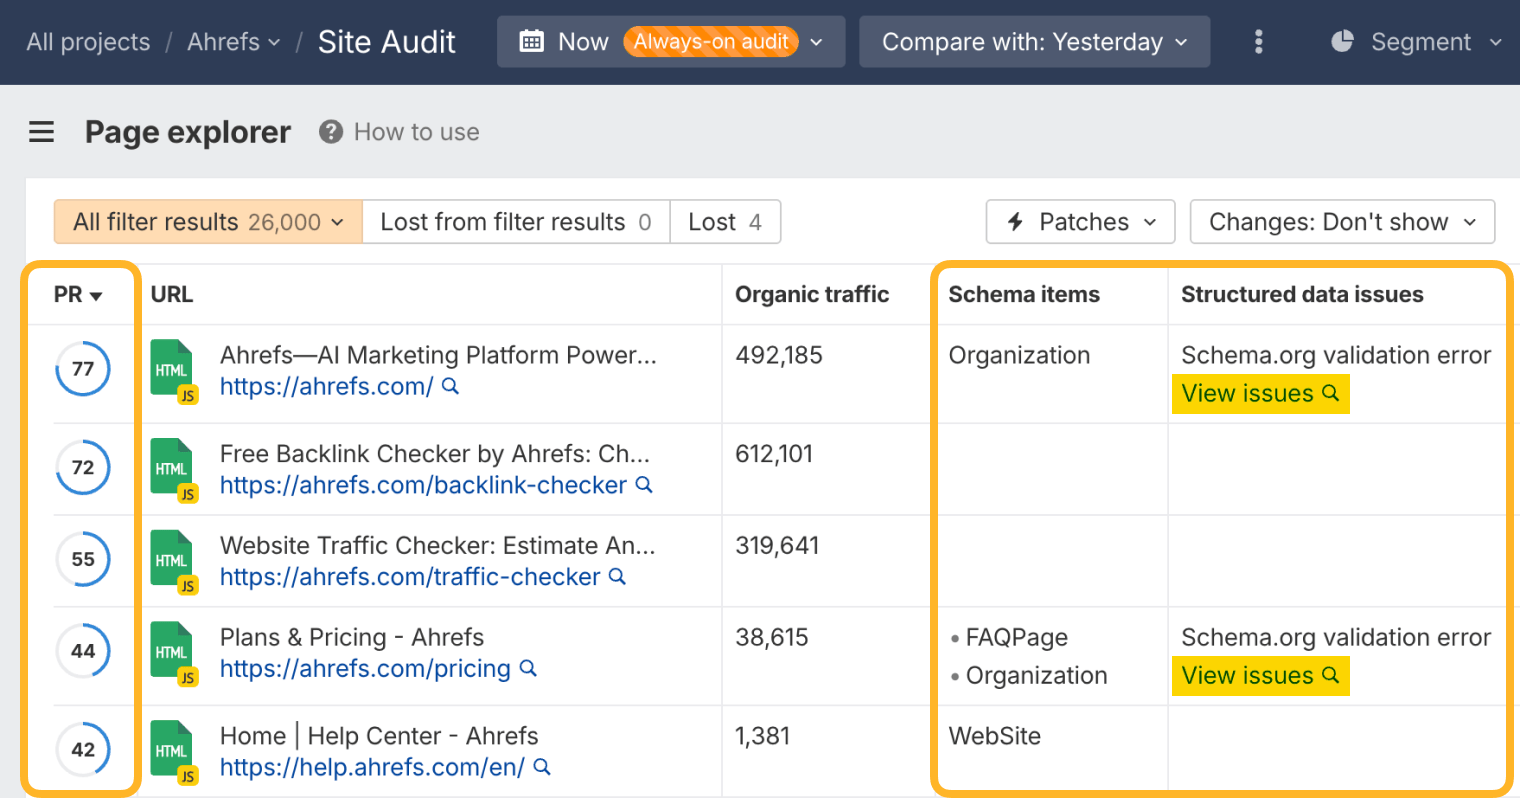
Знайдіть свої найавторитетніші сторінки та переконайтеся, що на них правильно налаштовано розмітку Schema.
Для цього перейдіть до звіту Page Explorer у Site Audit і відсортуйте сторінки за рейтингом сторінки.
Рейтинг сторінки (PR) показує, наскільки сильний профіль внутрішніх і зовнішніх беклінків URL-адреси, як порівняти з іншими URL-адресами, включеними до сканування.
Потім у стовпці «Елементи Schema» перевірте наявну розмітку, а в стовпці «Проблеми зі структурованими даними» — чи немає відсутніх або недійсних структурованих даних.
Підготуйтеся до маркетингу між агентами
І наостанок варто пам’ятати: дедалі частіше вашими «читачами» стають ШІ-агенти, які шукають інформацію та купують товари від імені вашої аудиторії.
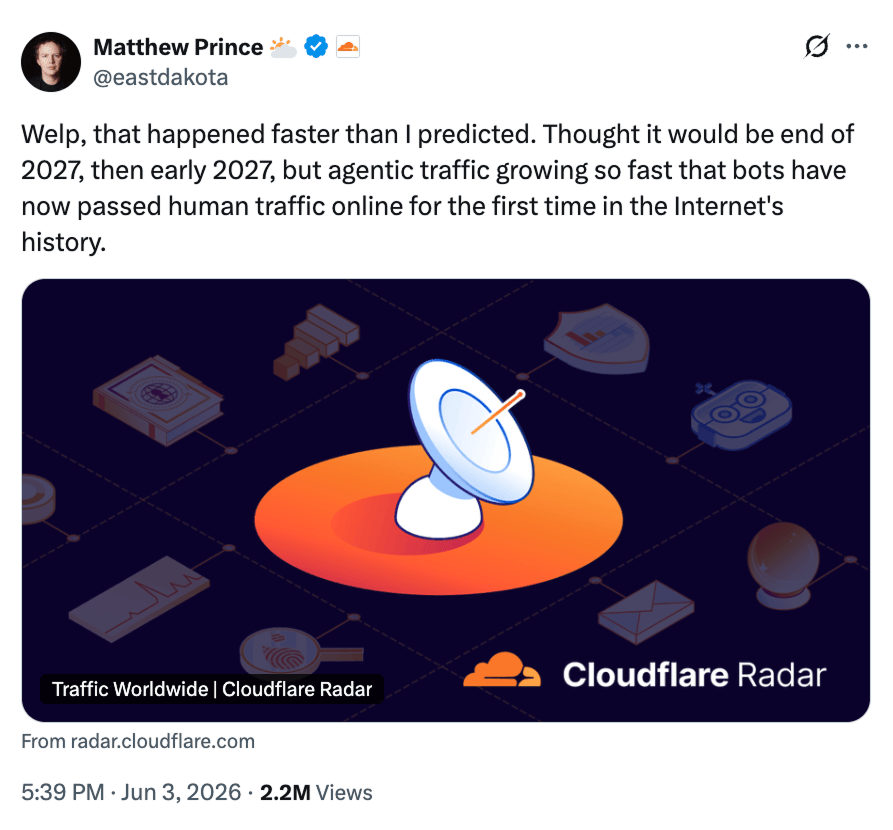
Ба більше, у червні 2026 року CEO Cloudflare Метью Прінс повідомив, що агентний трафік (трафік ботів, сканерів та агентів) уперше в історії інтернету перевищив позначку 50 %.2, 3
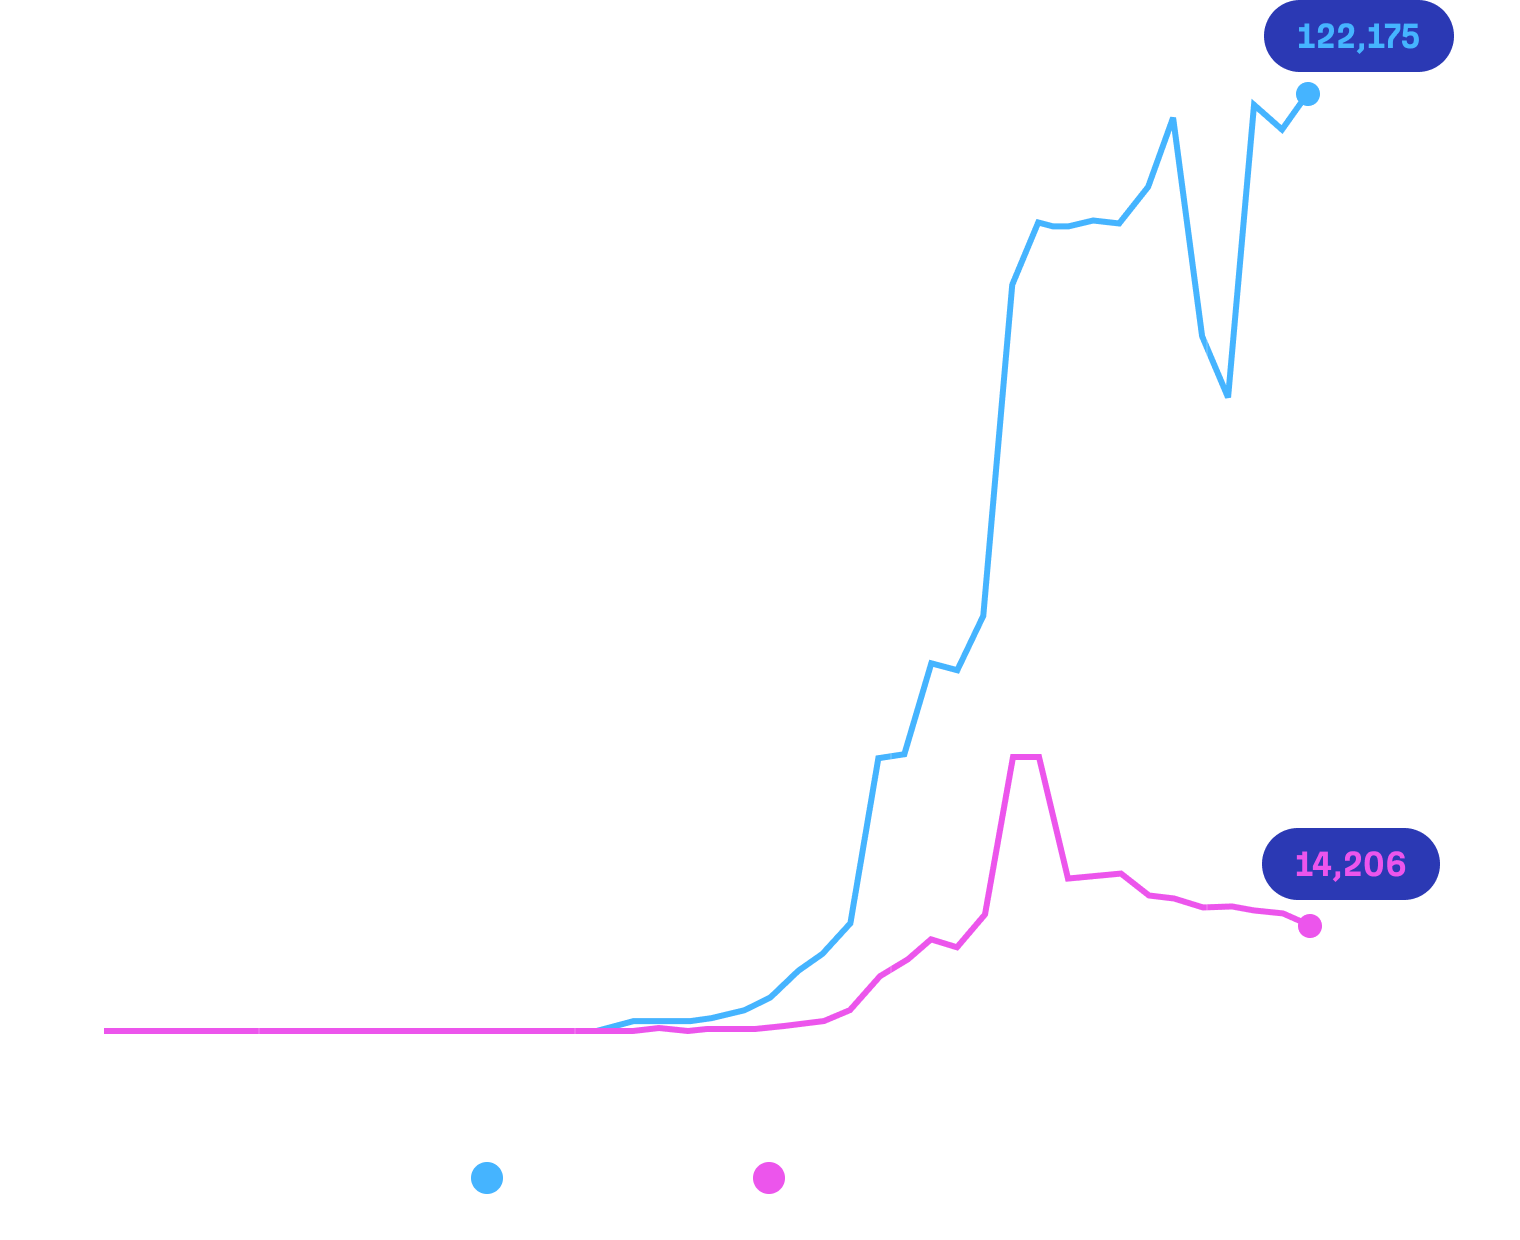
Агентний ШІ вже не можна назвати ані рідкісним явищем, ані новинкою: за три роки кількість пошукових запитів «агентний ШІ» збільшилася у 84 рази, а вартість роботи агента зменшилася з доларів до центів.
Додаткові статті
Поки що не потрібно перебудовувати вебсайт спеціально для ШІ-агентів. Але стара порада створювати контент лише для людей і не перейматися роботами, здається, втратила свою актуальність.
У цьому розділі йдеться про те, як впливати на ШІ, якому довіряє людина. Маркетинг між агентами розвиває цю ідею на крок далі.
Згадування
- «ChatGPT — це пошукова система. Ось як вона працює». Девід Максвіні, QueryBurst.
- Метью Прінс (@eastdakota) у X. 3 червня 2026.
Луїза працює контент-маркетологом в Ahrefs. За останні десять років вона обіймала керівні посади у сфері контенту в SaaS-компаніях Pi Datametrics, BuzzSumo та Cision. За цей час вона опублікувала сотні публікацій у блогах, очолювала провідні галузеві дослідження й розробляла програми вебінарів за участю експертів.
Опановувати SEO Луїза почала під час роботи в Pi, компанії, що спеціалізується на корпоративному SEO. Уже за кілька тижнів після приєднання до команди вона опублікувала матеріал про канібалізацію, який привернув увагу одного з найвідоміших на той час фахівців у сфері SEO — Ренда Фішкіна. Відтоді вона писала на різні теми: від маніпулятивного лінкбілдингу й синдикації контенту до прогнозування пошукового попиту. У вільний час Луїза поглиблювала практичні знання SEO, створюючи вебсайти для двох місцевих компаній.
З матеріалами Луїзи можна ознайомитися в таких галузевих виданнях, як Search Engine Watch, The Drum, The Telegraph і Spin Sucks.
Ознайомтеся з усіма посібниками з AEO
Що таке оптимізація для пошукових систем відповідей (AEO)?
Почніть звідси. Що таке AEO, у чому відмінність від SEO, а також сім кроків для початку роботи.
Як працюють пошукові системи відповідей
Що насправді відбувається між запитом і відповіддю та на якому етапі в цьому процесі може з'явитися ваш бренд.
Як відстежувати видимість у ШІ-пошуку
Неможливо оптимізувати те, чого не видно. Сім способів оцінити присутність вашого бренду у відповідях ШІ.
Як вибрати найкращі запити для відстеження
Відстежуйте кластери запитів, а не окремі відповіді. Одинадцять джерел, де можна знайти запити, варті відстеження.
Як оптимізувати контент для пошукових систем відповідей
Високі позиції допомагають потрапити в поле зору. А ось що допомагає отримувати цитування: теми, формати й зміни на сторінках, які справді працюють.
Як відстежувати згадки бренду у відповідях ШІ й отримувати від них максимум користі
ШІ рекомендує бренди, які згадують на інших ресурсах. Ось як відстежувати ці згадки та збільшувати їх кількість.
Як оптимізувати вебсайт для пошукових систем відповідей
Технічні виправлення, які допомагають ШІ знаходити й читати ваші сторінки та розуміти, хто ви.