


回答エンジン向けにウェブサイトを最適化する方法
Ahrefs のコンテンツマーケター
コンテンツがどれだけ良くても、AI の回答に一度も載らないことがあります。
AI 最適化の施策はどれも、AI システムがページに到達して読み取り、あなたが何者なのかを理解できることが前提です。しかし、それは当たり前ではありません。約 5.89% のウェブサイトは GPTBot を完全にブロックしており、ChatGPT は応答に約2秒以上かかるページを放棄するように見えます。また、多くの AI クローラーは JavaScript をまったく実行しません。
朗報なのは、ここがAEOで最も修正しやすい部分だということです。これだけで引用を獲得できるわけではありませんが、これらの問題のどれか1つでも、本来得られたはずの引用を静かに失う原因になり得ます。
YouTube で学び続ける
robots.txt で AI クローラーをブロックしない
AI クローラーがページを読めないなら、このガイドのどのヒントも意味がありません。ブロックされたページは引用されませんし、多くの場合それは偶然に起きます。
約1億4,000万のウェブサイトを分析したところ、GPTBot は現在、最もブロックされている AI ボット(サイトの 5.89%)で、ClaudeBot がそれに続きました。
Cloudflare はデフォルトで AI プラットフォームをブロックするため、CDN が知らないうちにオプトアウトしていないか確認しましょう。
「AI クローラーを許可する」は 1 つの判断で済む話ではありません。というのも、各プラットフォームは異なる役割を担う複数のボットを動かしているからです。
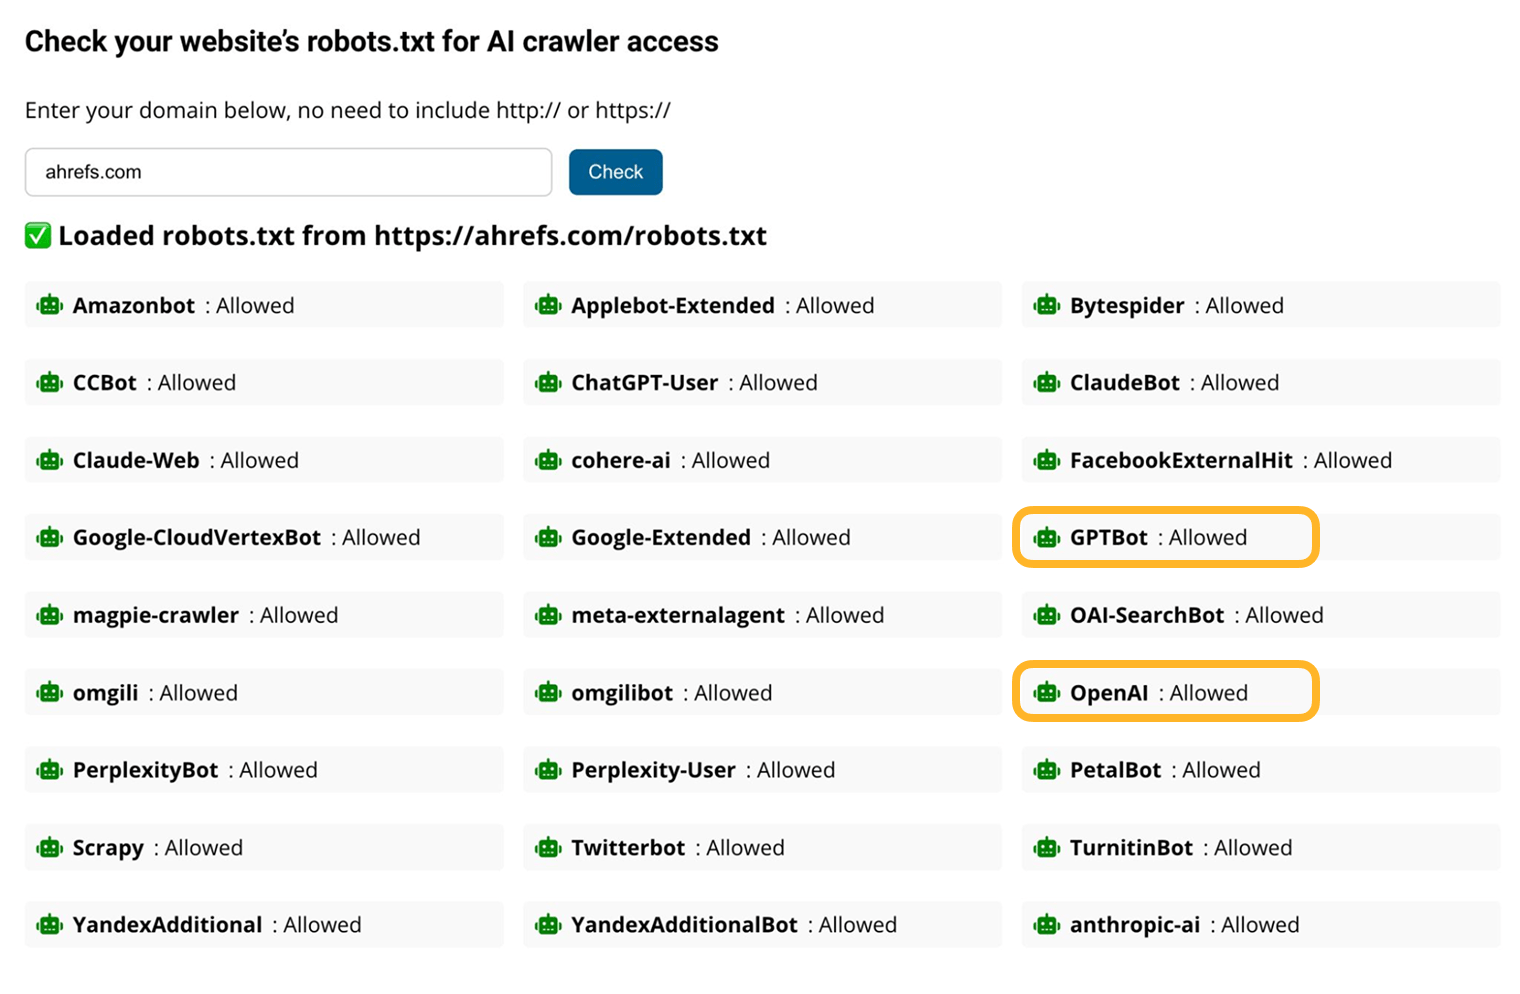
OpenAIだけでも3つ運用しています:
- GPTBot は学習用にコンテンツを収集します
- OAI-SearchBot は、ChatGPT が参照する検索インデックスを構築します
- ChatGPT-User は、会話の途中で誰かがページについて質問すると、そのページをライブで取得します
両者にはそれぞれ異なるトレードオフがあります。GPTBot をブロックすると、コンテンツが次のモデルの学習データから除外されます。これは通常、出版社が検討している判断です。一方、OAI-SearchBot をブロックすると、ChatGPT が検索するインデックスから外れるため、現在の引用や参照トラフィックを失う原因になります。実際には、1つ目だけを意図しているのに、誤って2つ目をブロックしているサイトも少なくありません。
自分の状況を最速で把握するなら、AI Crawler Access Checker のようなツールが便利です。robots.txt を読み取り、どのクローラーが許可されているかを教えてくれます。
許可されているボットではなく、実際にやって来ているボットを確認するには、Ahrefs のボット解析をチェックしてください。Cloudflare 経由のサーバーサイドデータを使って、専用の AI フィルターを含む 12 種類のボットカテゴリ全体の訪問を追跡するため、サイトに JavaScript を追加しなくても機能します。
過度な JavaScript でコンテンツを埋もれさせない
AI クローラーは生の HTML を読む傾向があり、ブラウザのように JavaScript をレンダリングすることはほとんどありません。
つまり、クライアントサイド JS の実行後にしか表示されないものは、それらからは見えない場合があります。
確実性を重視するならサーバーサイドレンダリングに徹して、AI に見つけてもらえる可能性を最大化しましょう。
ページ速度を改善する
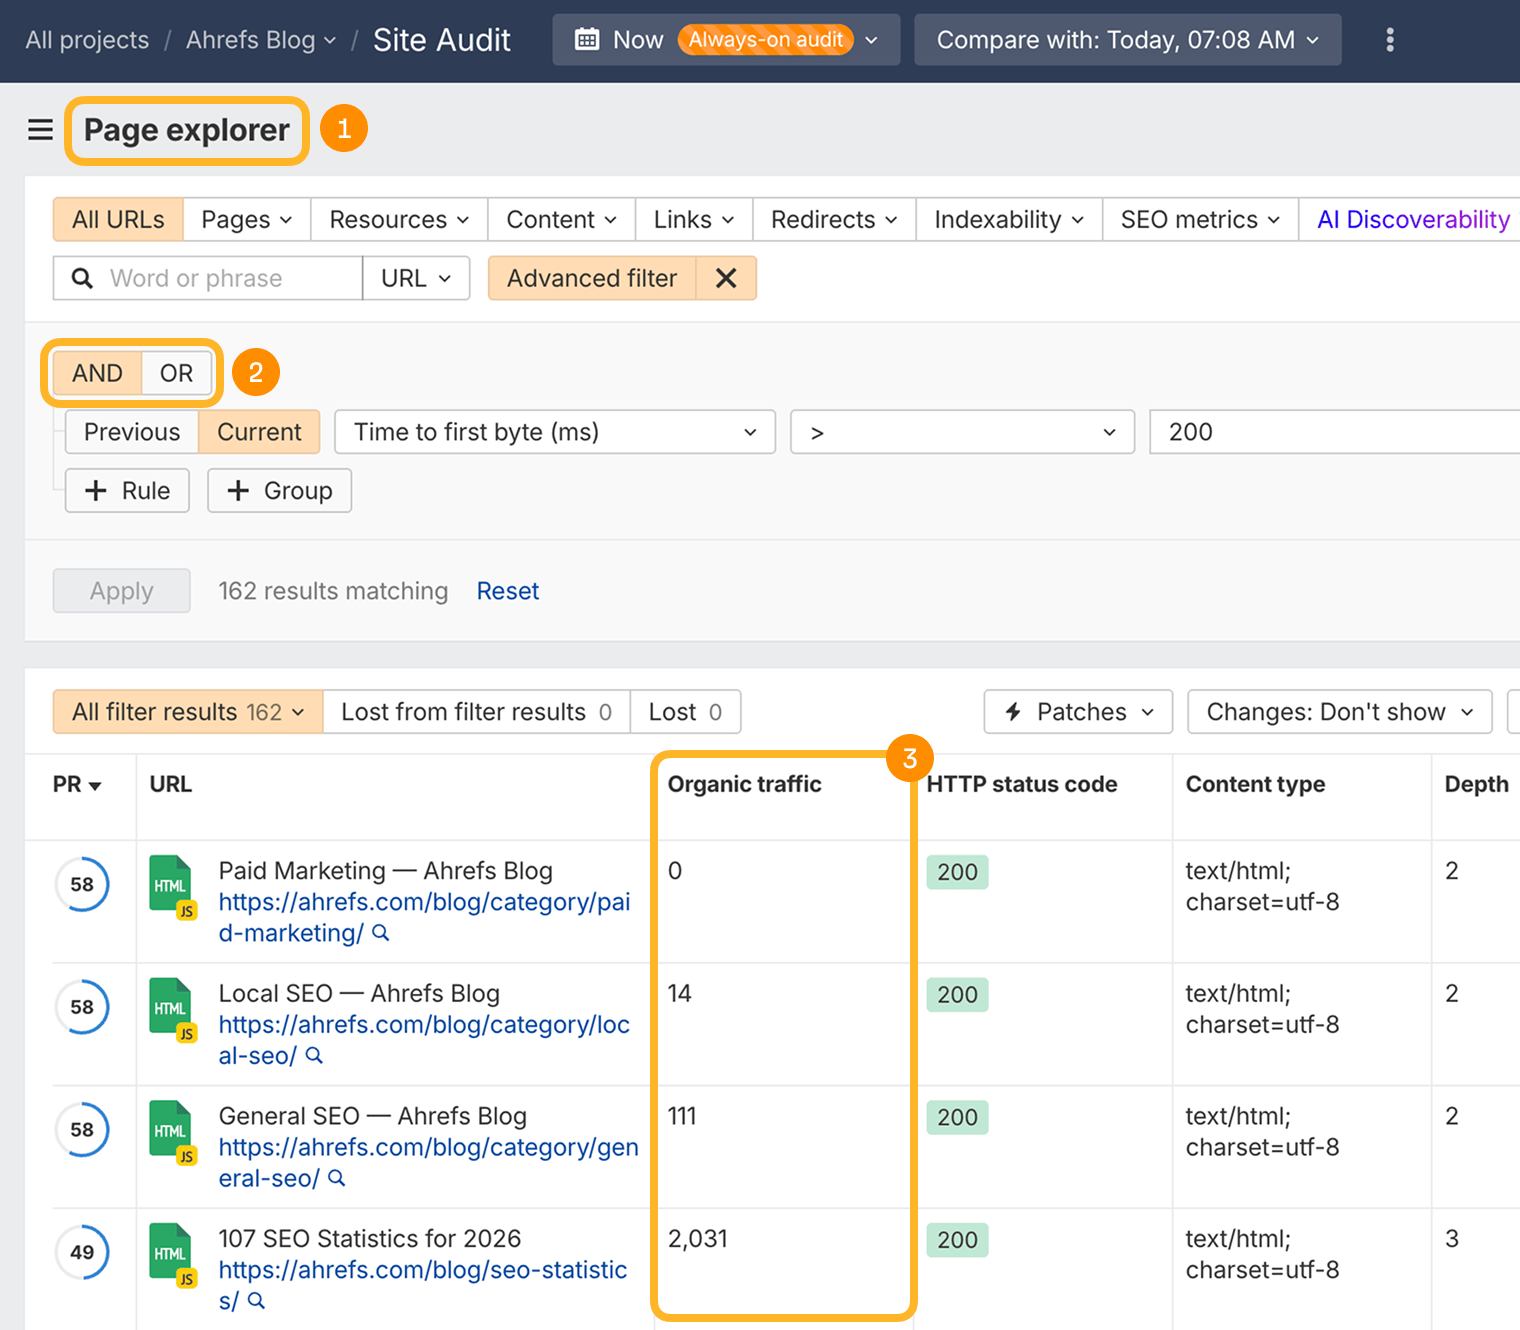
読み込みの遅いページは従来の検索でのパフォーマンスに悪影響を与えますが、むしろ回答エンジンではさらに大きなペナルティがあるようです。ページ速度は、そもそもモデルのコンテキストウィンドウに入れるかどうかの判断にも影響しているように見えます。1
サイト監査でページ速度(time-to-first-byte と呼ばれる指標)を確認しましょう:
llms.txt は気にしなくて OK
llms.txt は、ルートドメイン(例:website.com/llms.txt)に置く Markdown ファイルとして提案されているスタンダードで、ドキュメント、ポリシー、製品タクソノミーなど、最良のコンテンツの場所を LLM に伝えるものです。原理的には、言語モデル向けの robots.txt のようなものです。
しかし実際には、主要なLLMプロバイダーのどこも、それを読むと約束していません。OpenAIも、Anthropicも、Googleもです。
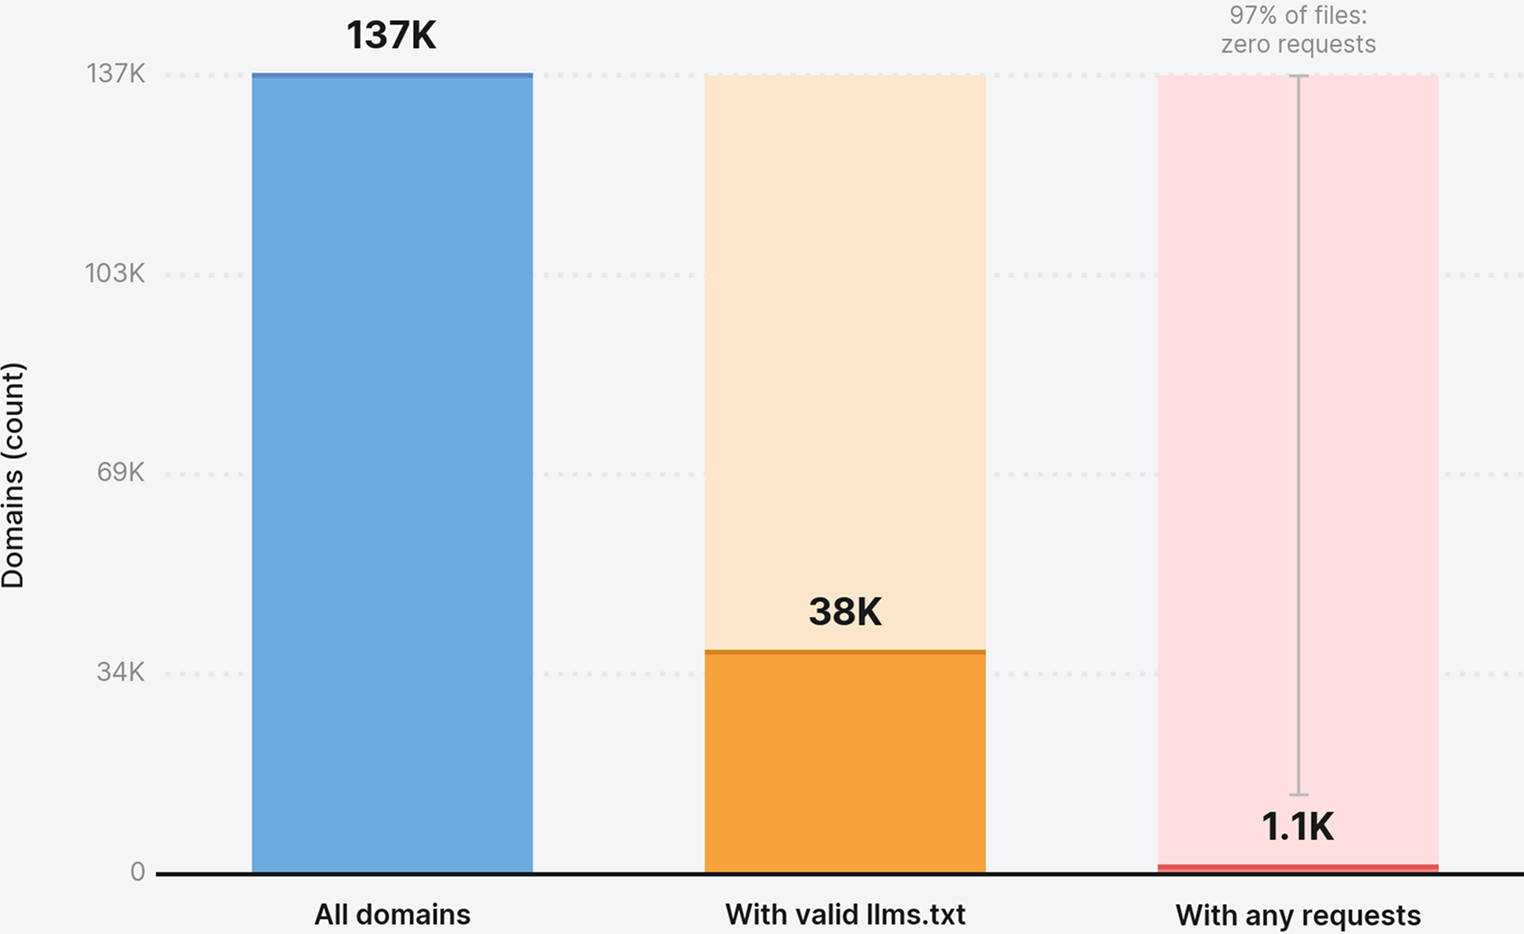
サイトに llms.txt を追加すると実際に何が起きるのかを調べました。Ahrefs ウェブアナリティクスを利用している137,000 ドメインのうち、28% が llms.txt ファイルを公開しています。有効なファイルがある約 38,000 のうち、計測した 1 か月間にそれへのリクエストがゼロだったものは 97% でした。
llms.txtファイルの97%は一度もリクエストされない
Ahrefs ウェブアナリティクスを使用した、137,000 ドメインに関する Ahrefs の調査。
実際に取得されたごく一部のファイルでは、リクエストの 96% はボットからでした。Link プレビュー用ボットである Slackbot は、PerplexityBot よりも頻繁に llms.txt を取得していました。端的に言えば、最も重要な AI 検索エンジンはこれを使っていないようです。
Google はこの点を明確にしています。生成 AI 機能の最適化に関するガイドには、「誤解を解く(mythbusting)」という見出しのセクションがあり、llms.txt のような機械可読ファイルは生成 AI 検索に表示されるために必要ではない、とサイト運営者に伝えています。John Mueller はさらに踏み込み、古い keywords メタタグになぞらえました。

私の知る限り、どのAIサービスもLLMs.TXTを使っているとは言っていません(サーバーログを見れば、そもそも確認すらしていないことがわかります)。私には、keywordsのmetaタグに近いものに思えます。つまり、サイトオーナーが「自分のサイトはこういうサイトです」と主張するだけ……(本当にそうなのか? それは確認できます。そこまでやるなら、最初から直接サイトを確認すればいいのでは?)
John Mueller(検索アドボケイト、Google)
では作るべきでしょうか? 開発者向けドキュメントを公開しているなら、作業は10分程度で、妥当なユースケースもあります。Mueller は、ドキュメントを解析する AI コーディングツール向けに「トークンを節約するための一時的な松葉杖のようなもの」と表現しました。それ以外の人にとっては、効果が測定できないのに労力がかかるうえ、競合にコンテンツを丸ごとスクレイピングされやすくなるという小さなデメリットもあります。
AI が幻覚で生成した、誤った自社 URL を修正する
AIアシスタントは、あなたのWebサイトへのリンクを作り上げてしまうことがあり、それは頻繁に起こります。ChatGPT、Perplexity、Copilot、Gemini、Claude、Mistralが引用した1,600万件のURLのHTTPステータスを確認したところ、AIアシスタントが訪問者を404ページに誘導する頻度は、Google検索の2.87倍でした。
ChatGPTは群を抜いて問題が大きいです。クリックされたURLのうち1.01%が404を返しており、Googleの基準値0.15%を大きく上回ります。
流入チャネル別の 404 率
ウェブアナリティクスのデータ:1,600万 URL を分析。
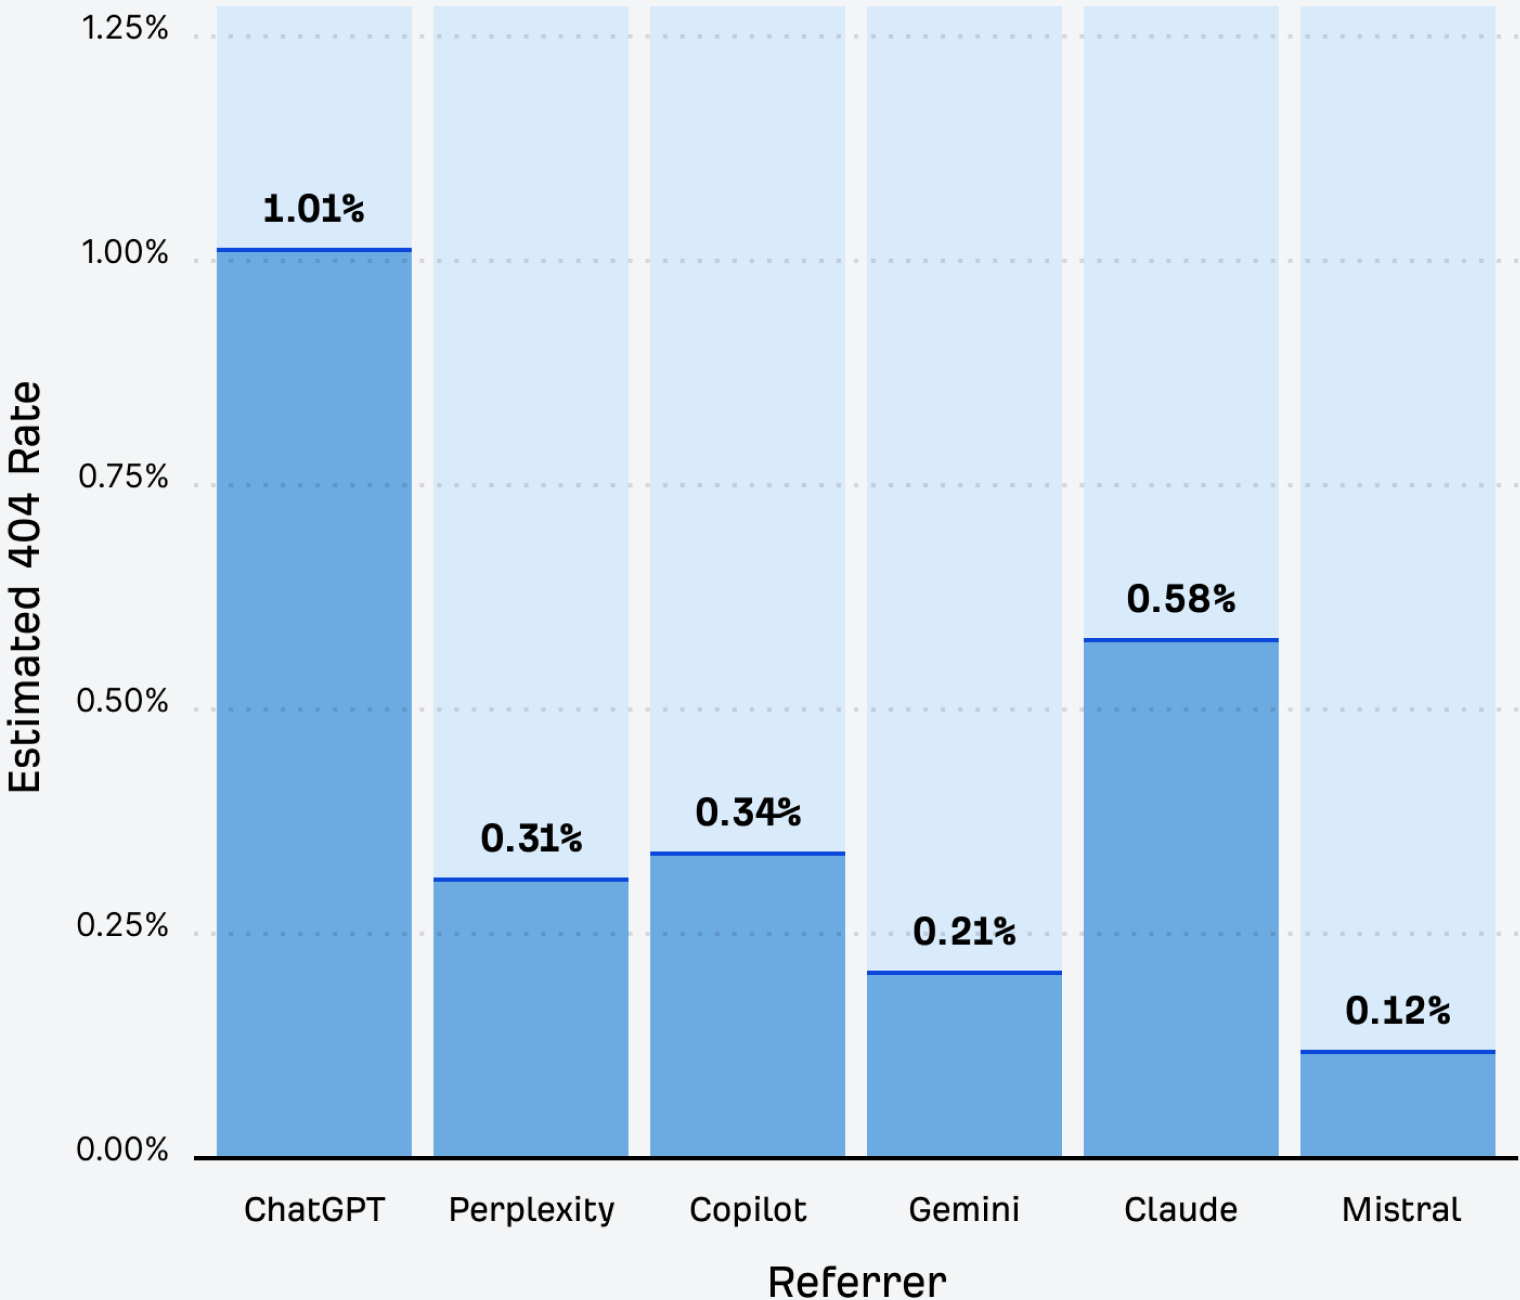
Perplexity(0.87%)と Gemini(0.86%)は、引用される URL における Google 自身の 0.84% という率とほぼ一致しています。どちらも Google のインデックスから取得するため、独自に作り出すのではなく、Google のリンク切れを引き継ぐのは自然なことです。
でっち上げられた URL は、既存のパターンから推測されます。私たちのサイトでよくある幻覚 URL は ahrefs.com/keywords でした。キーワードについて常に書いているため、そのようなページが存在するはずだとモデルが想定したのです。しかし、実際には存在しません。
これは AEO における、数少ない本当に「無料で得られる成果」の 1 つです。明確な意図を持つ人があなたの製品について質問し、サイトに誘導されたのに、そこで行き止まりになってしまっているのです。遭遇するタイプは 3 つあります:
- URLのハルシネーション。 URL構造からモデルが作り上げたページ。
- 古いURL。 かつて存在していたページで、学習データやその他の古いデータソースに残っているもの。
- URLの誤字・表記ゆれ。 実在するページに「あと少しで一致」するURL。
そのため、ウェブアナリティクスに、わずか2クリックで幻覚 URL を見つけられるフィルターを追加しました。月間100万イベントまで無料で使える、Google アナリティクスのシンプルな代替を探しているなら、ぜひチェックしてみてください:
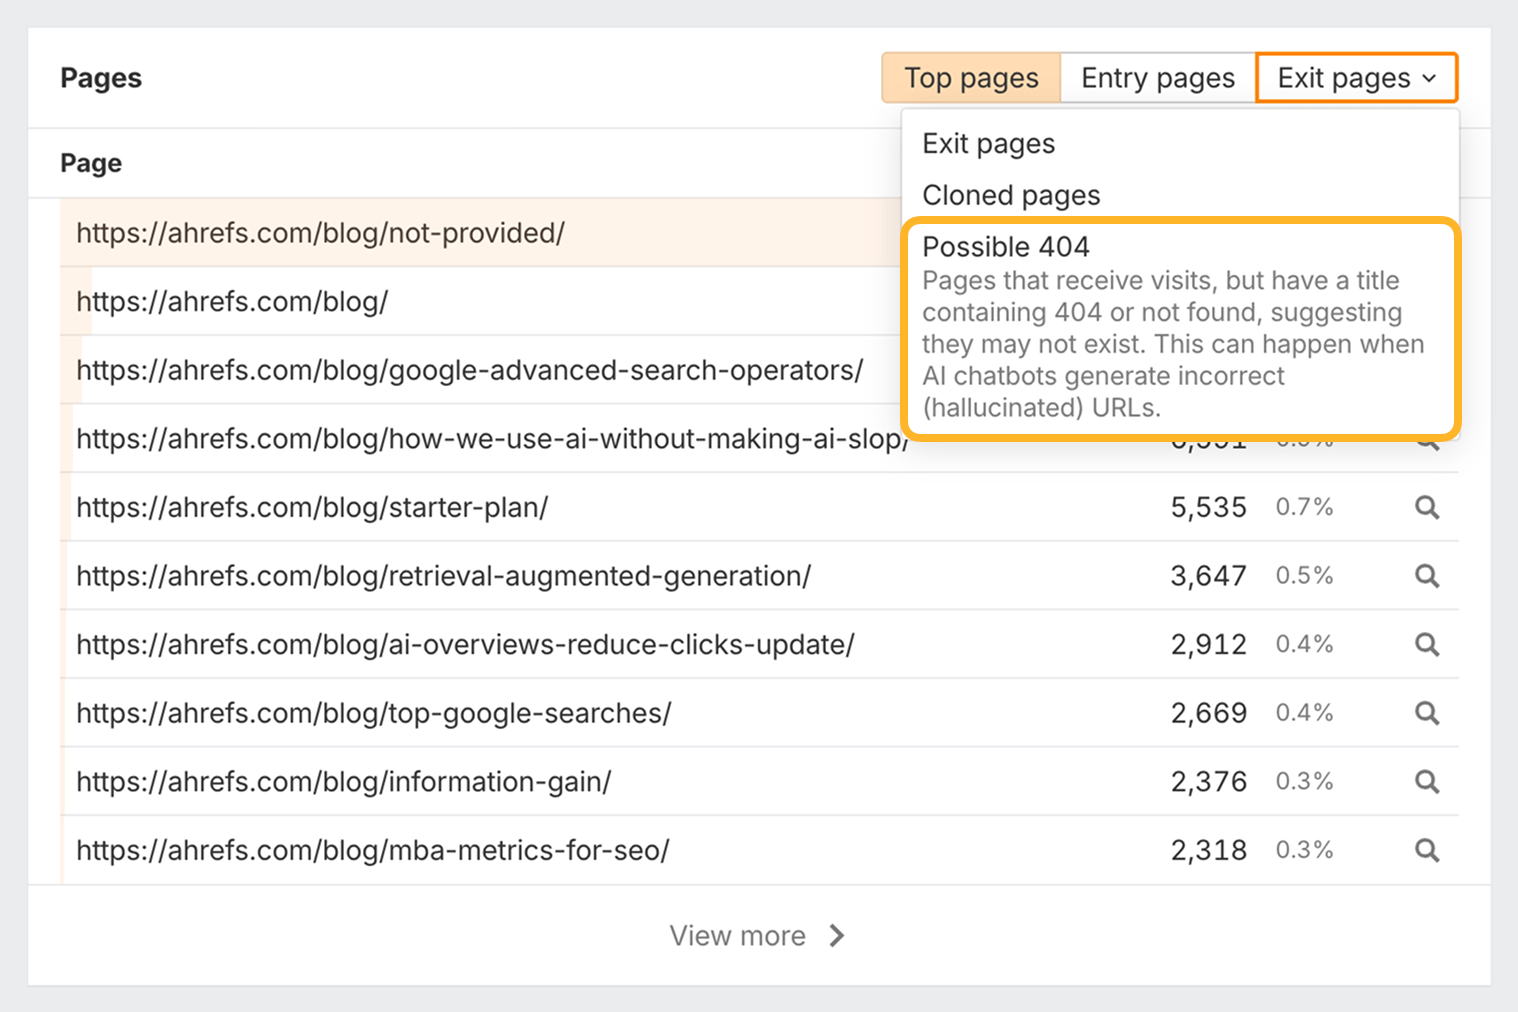
ハルシネーションのURLが繰り返しリクエストされるなら、モデルは「訪問者が欲しいと期待しているページ」を教えてくれています。
認知された存在になる
このガイドのあらゆる戦術は、突き詰めれば 1 つのことにかかっています。それは、AI システムがあなたのブランドを明確に区別できるエンティティとして認識しているかどうかです。
ご存じですか?
エンティティとは、検索エンジンや AI が認識し、ほかのものと区別できる現実世界の明確な対象(特定の人物・場所・企業・製品・概念など)を指します。単にそれを説明する「言葉」ではなく、「Dmytro Gerasymenko」「Ahrefs」「Singapore」のような具体的なものです。
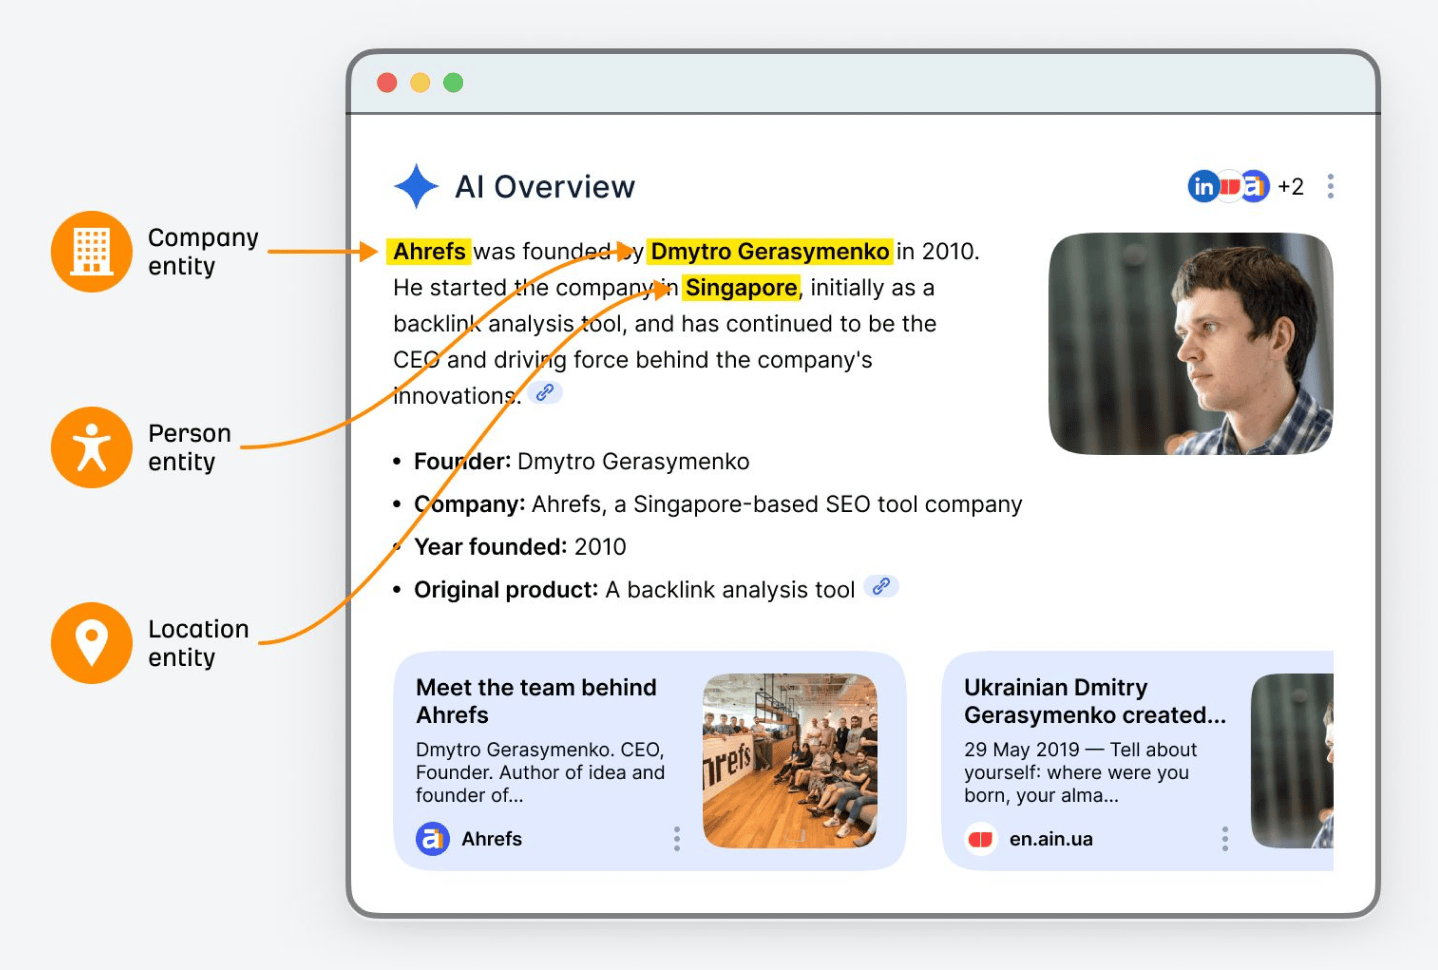
Google のナレッジグラフ(540億のエンティティと、それらの関係性に関する 1.6兆以上の事実を収録したデータベース)は、もはやナレッジパネルを支えるエンジンにとどまりません。
現在では、AIによる概要、AI Mode、Gemini の中核インフラになっています。
ブランドが、サイト全体、構造化データ、権威ある第三者ソースにわたる一貫したシグナルによって「エンティティ」として明確に確立されていない場合、青いリンクだけでなく、AI の回答でも表示されないリスクがあります。
スキーマは、AI 可視性を手早く伸ばす手段として語られがちです。表面的な相関も説得力があります。AI に引用されるページは、JSON-LD を持っている可能性がほぼ 3 倍高いのです。
AIに引用されるページでは、スキーマの使用がはるかに一般的
Ahrefs による 600万ページの調査(グループごとに 200万ページ)。
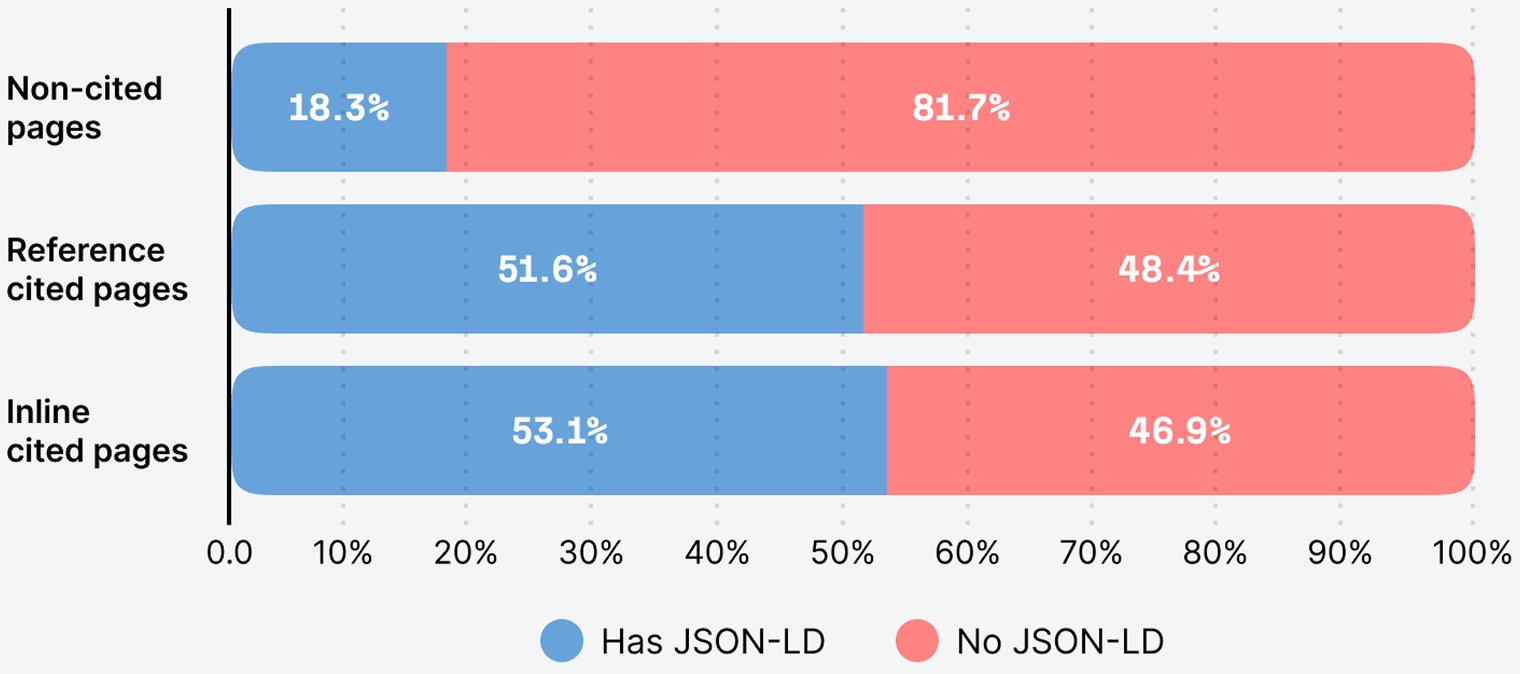
ただし、相関は因果ではありません。JSON-LD を追加した 1,885 ページを 4,000 の対照群と比較して追跡したところ、AI Mode や ChatGPT で有意な改善は見られず、AIによる概要では小さな低下がありましたが、その原因をスキーマだと特定できませんでした。
では、スキーマは無意味なのでしょうか? いいえ。ただし、その効果は遅く間接的で、すぐに成果が出る施策ではありません。
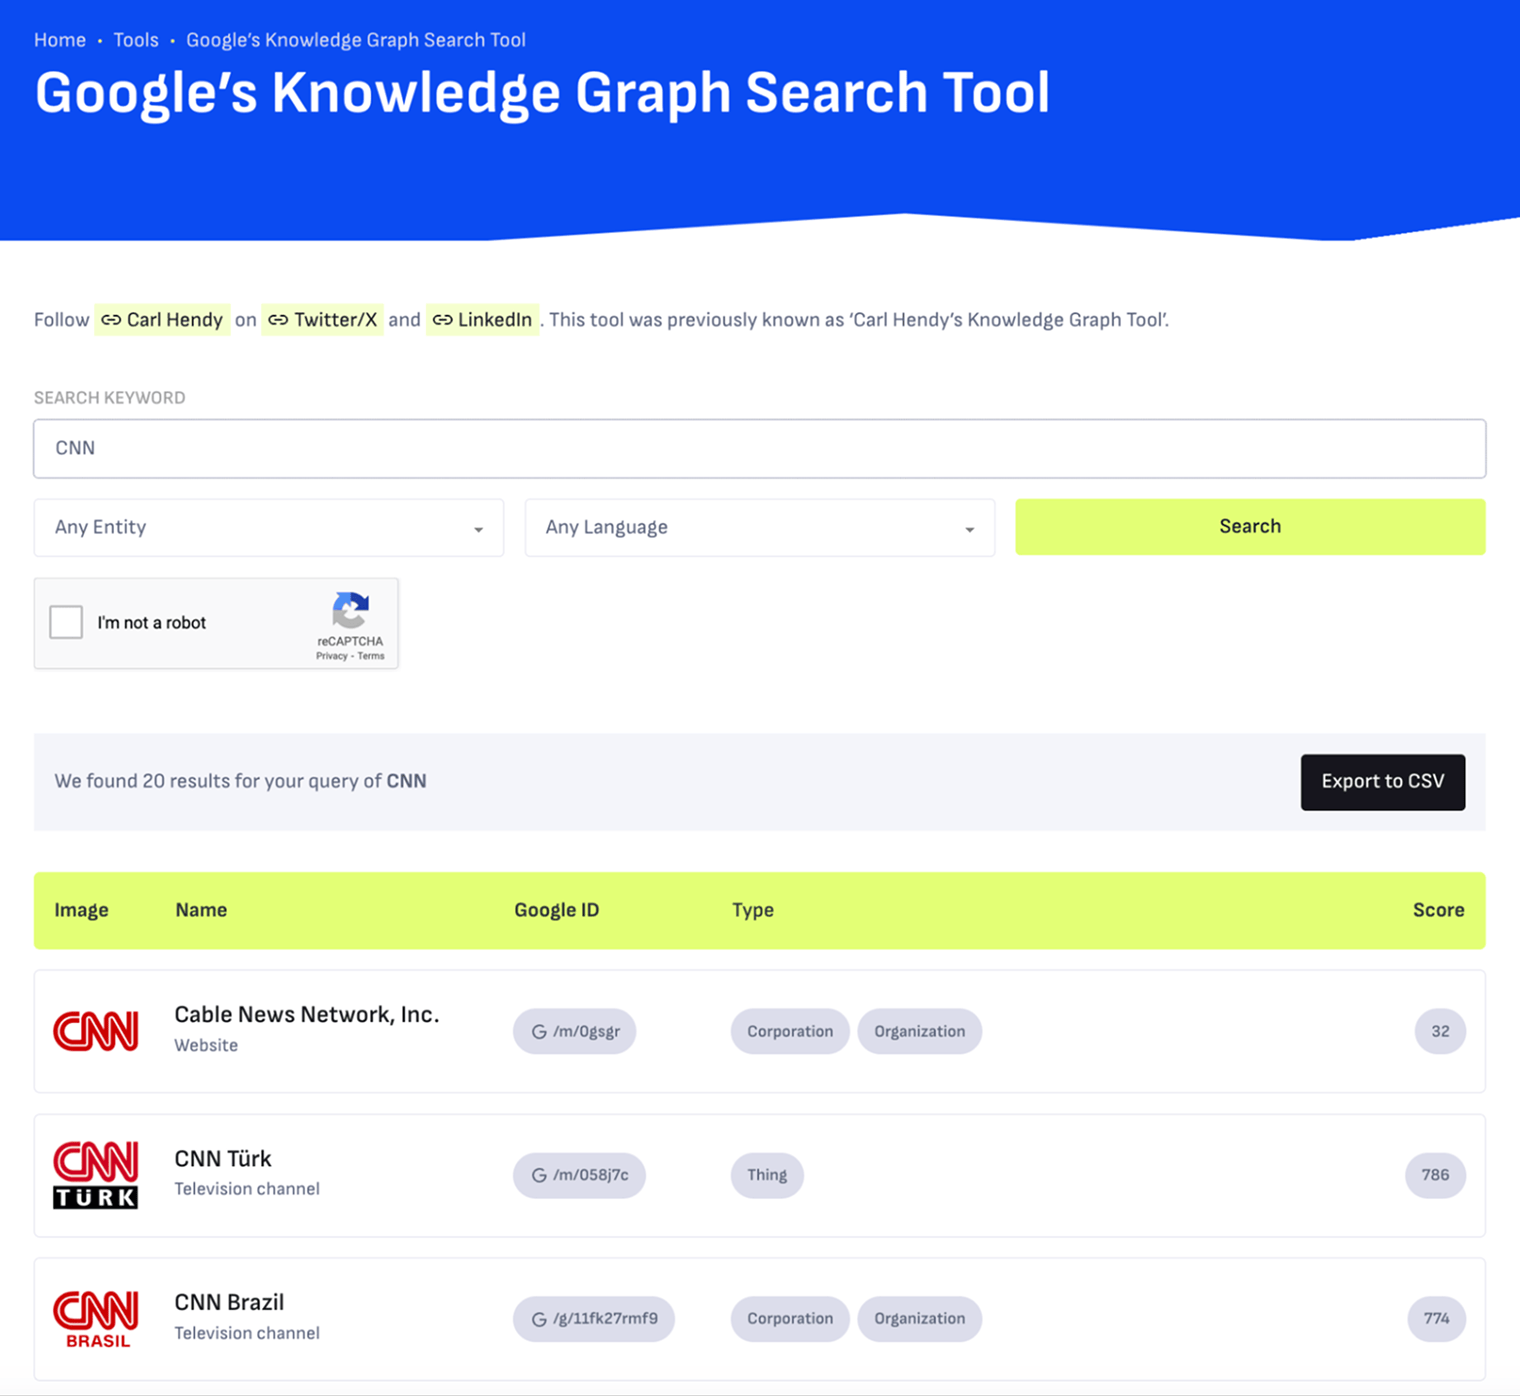
Google の Knowledge Graph API や無料のチェッカーを使えば、Google がすでにあなたを認識しているか、割り当てられたエンティティの種類は何か、属性が正しいかを確認できます。
たとえば、Carl Hendy’s Knowledge Graph Toolでは、人、企業、製品、場所など、さまざまなエンティティの結果を確認できます。
そこから、権威ある媒体からの言及獲得を狙い、どこでも事実情報の一貫性を保ちましょう。サイト、プロフィール、サードパーティのリスティングのすべてで、名称・説明・カテゴリを同じにします。
次に、自然な箇所にスキーマを追加します。自社のエンティティとその関係性を定義するタイプを優先しましょう:
Wikipedia、Wikidata、ソーシャルプロフィールへ Link する Organization と sameAs スキーマ
サイトの著者向けのPersonスキーマ
提供サービス向けのProductスキーマ
ヒント
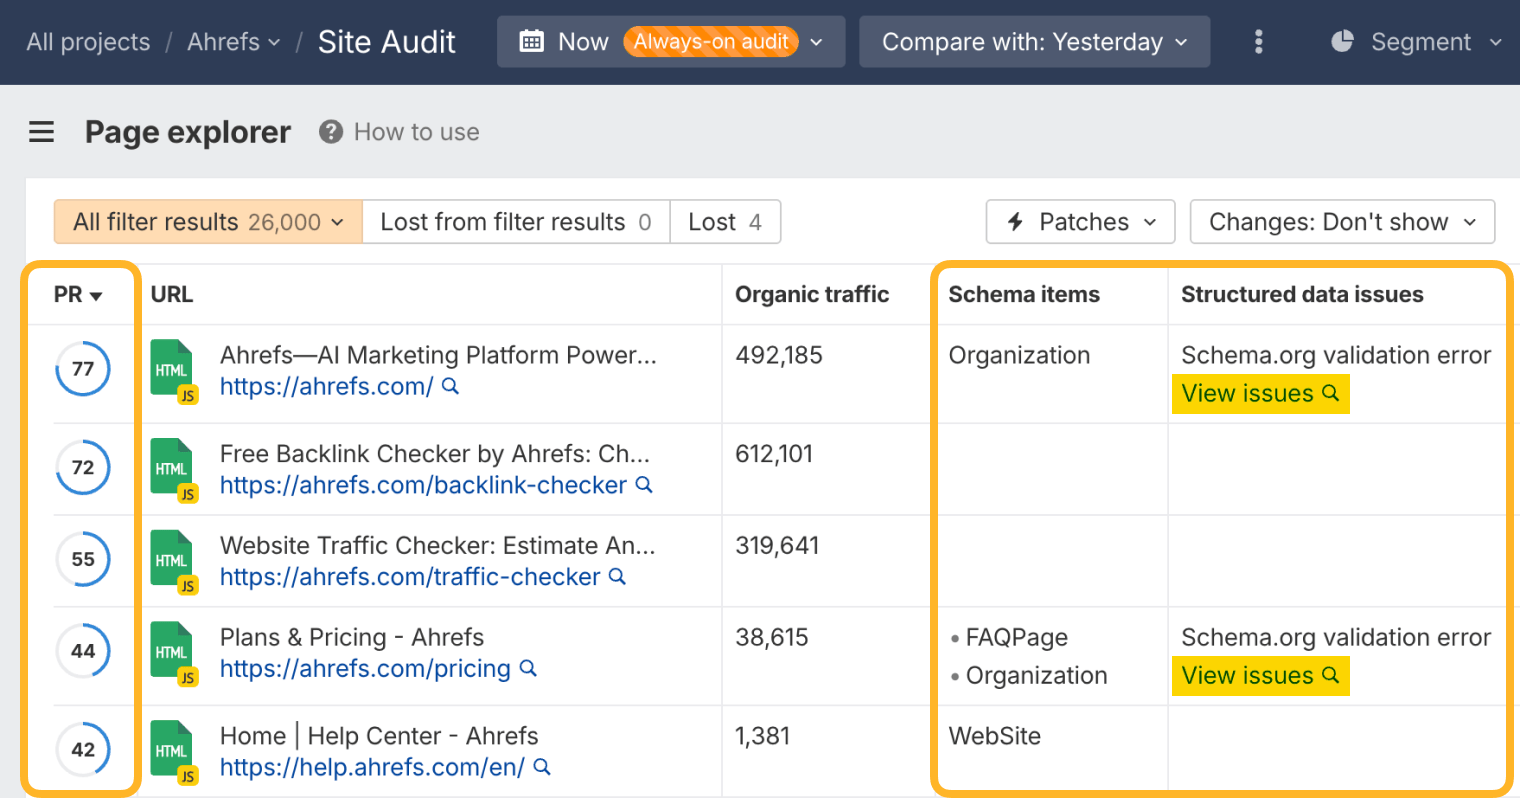
最も権威性の高いページを見つけ、それらにクリーンなスキーママークアップが載っていることを確認しましょう。
サイト監査のページエクスプローラーレポートに移動し、「ページ評価」で並べ替えることで実行できます。
ページ評価(PR)は、クロール対象に含まれる他の URL と比較した、その URL の内部および外部被リンクプロファイルの強さを示します。
次に、「スキーマ項目」列で既存のスキーマを監査し、「構造化データの問題」列で不足や無効な構造化データを見つけます。
A2A(Agent-to-Agent)マーケティングに備える
最後にひとつ考えてみてください。あなたが影響を与えようとしている「読者」の中には、実はオーディエンスの代わりに閲覧し、購入まで行うAI エージェントが増えつつあります。
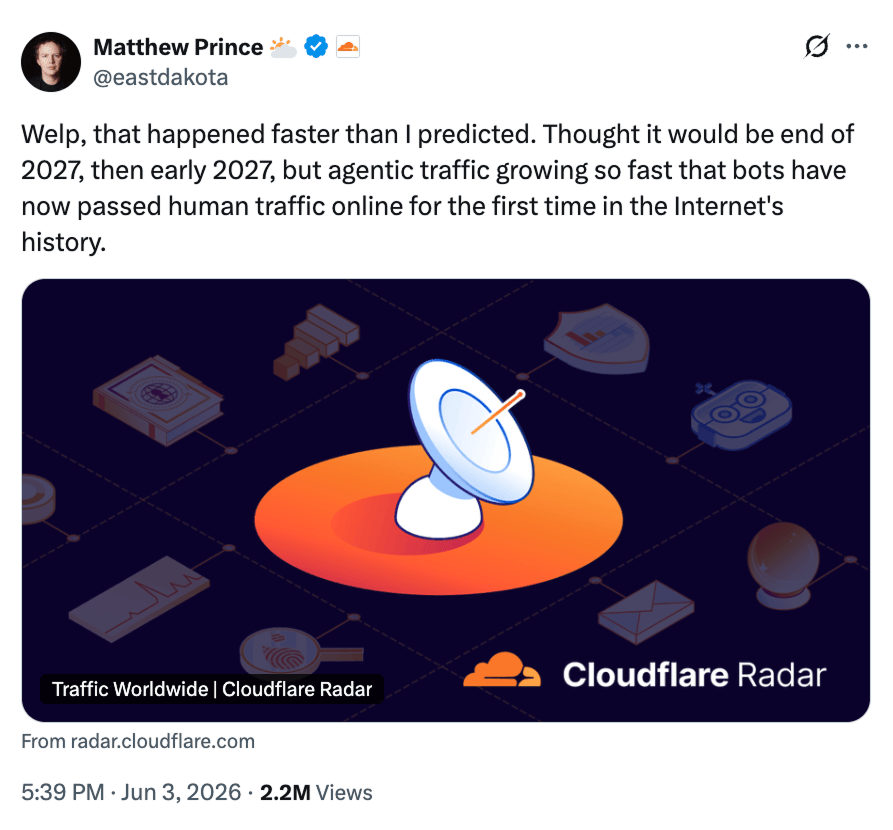
実際、2026 年 6 月に Cloudflare の CEO である Matthew Prince は、エージェント型(ボット/クローラー/エージェント)トラフィックが、インターネット史上初めて 50% を超えたことを明らかにしました。2, 3
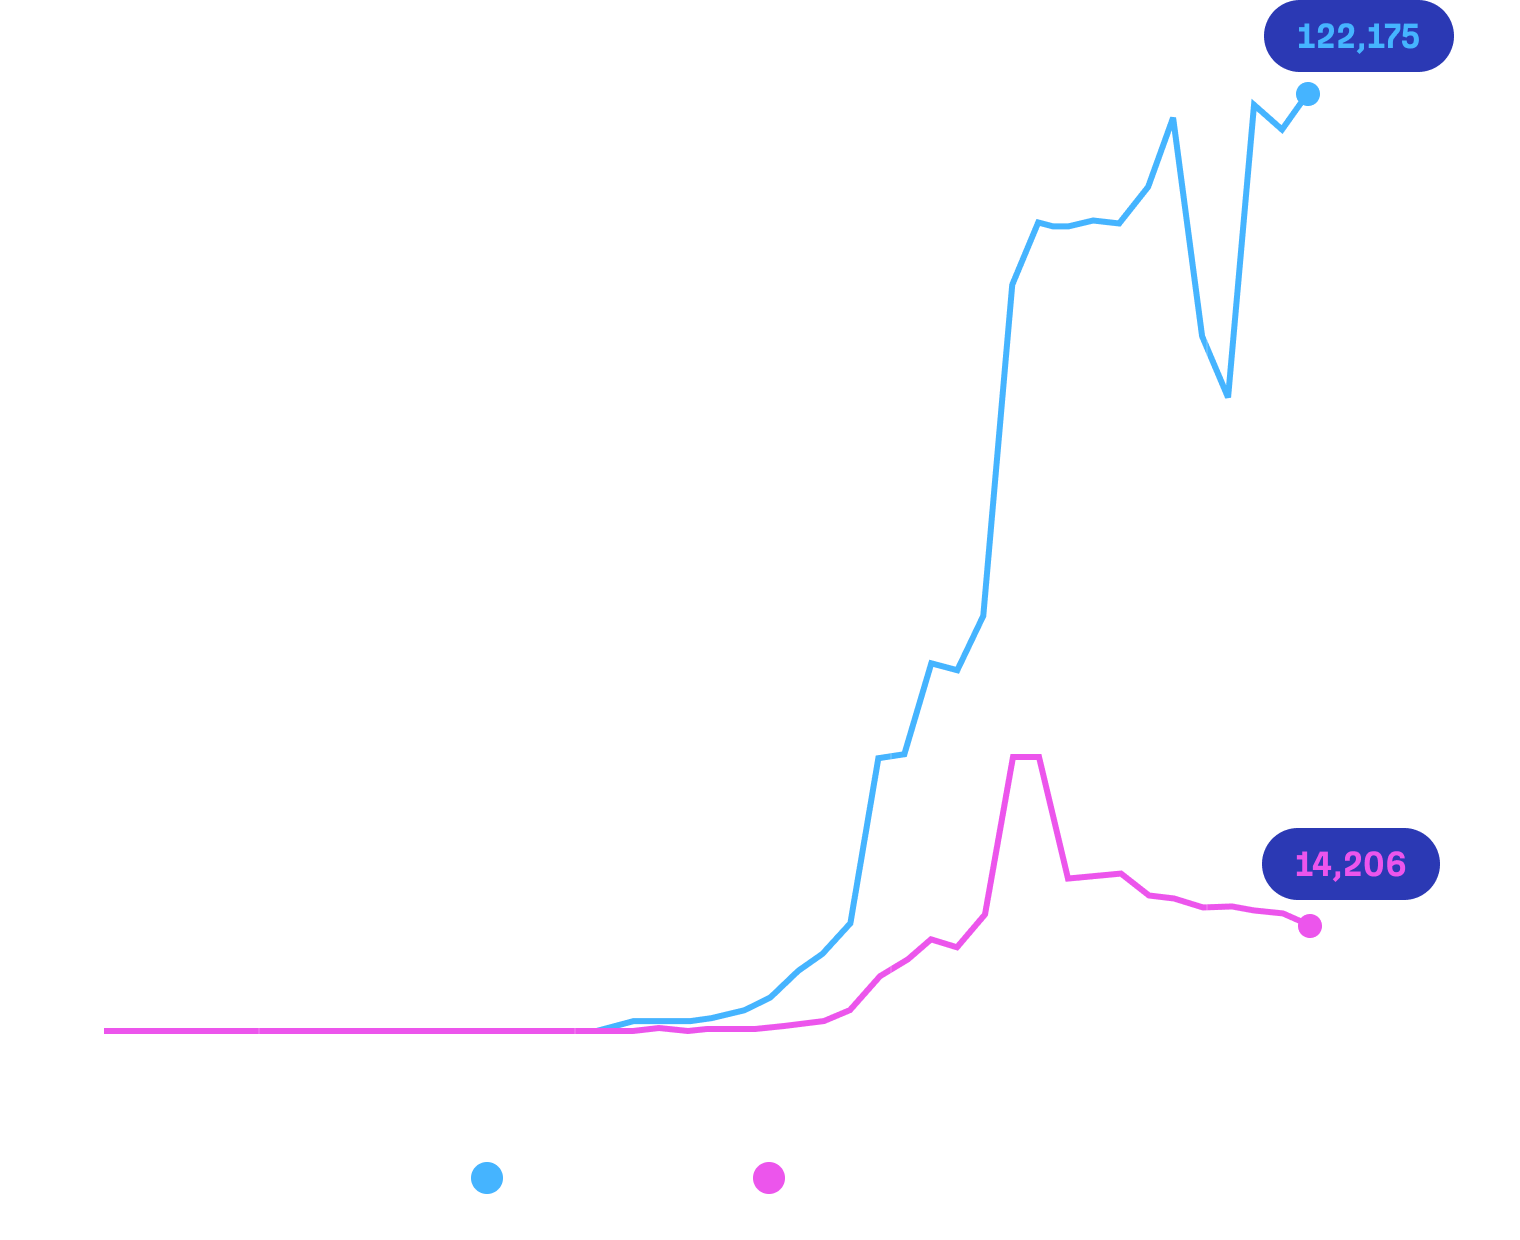
「agentic AI」の検索は、エージェントを動かすコストが数ドルから数セントへと下がったことを背景に、この3年間で84倍に跳ね上がりました。これはニッチな例や目新しさなどではありません。
AI エージェントのためだけに今すぐサイトを作り直す必要はありません。ただ、「人間のためだけにコンテンツを作って、ロボットのことは気にしなくてよい」という昔ながらの助言は、以前ほどは通用しなくなってきています。
この章は、人間が信頼するAIに影響を与えることについてです。エージェント同士のマーケティングはその一形態ですが、さらに一歩踏み込んだものです。
参照
- 「ChatGPT は検索エンジンだ。仕組みはこうだ」 David McSweeney(QueryBurst)。
- X の Matthew Prince(@eastdakota)。2026年6月3日。
Louise は Ahrefs のコンテンツマーケターです。過去 10 年間で、Pi Datametrics、BuzzSumo、Cision といった SaaS ブランドでコンテンツ職のシニアポジションを歴任してきました。その間、数百本のブログ記事を公開し、業界をリードする調査を主導し、専門家主導のウェビナープログラムを開発してきました。
LouiseはエンタープライズSEO企業のPiに在籍していた頃にSEOの基礎を学びました。入社から数週間で、カニバリゼーションに関する記事を公開し、当時SEO界で最大級の著名人だったRand Fishkinの注目を集めました。それ以来、操作的なリンク構築からコンテンツシンジケーション、検索需要予測まで幅広いテーマで執筆しています。余暇には、地域の2つの事業者向けにウェブサイトを構築し、SEOへの実践的な理解を深めてきました。
Louise の文章は、Search Engine Watch、The Drum、The Telegraph、Spin Sucks などの業界メディアで読むことができます。
AEO ガイドをすべて見る
回答エンジン最適化(AEO)とは?
まずはこちら。AEO とは何か、SEO との違い、対策を始めるための 7 つのステップを解説します。
回答エンジンの仕組み
プロンプト入力から回答生成までの間に実際に何が起こっているのか、そして、そのプロセスにあなたのブランドの情報が入り込む方法。
AI 可視性を追跡する方法
見えないものは最適化できません。あなたのブランドがどんな AI 回答に表示されているかを調査する 7 つの方法。
追跡すべき最適なプロンプトの選び方
回答を 1 件ずつ追跡するのではなく、関連プロンプトをまとめて調査しましょう。モニタリングすべきクエリが見つかる場所 11 選。
回答エンジン向けにコンテンツを最適化する方法
上位表示されれば候補に入ることができます。効果的なトピックやフォーマットを押さえ、ページ上の改善を行うことが、引用されるための近道です。
AI 回答内のブランド言及をモニタリングし、新たな言及を獲得する方法
AI は、他の場所で話題になっているブランドを回答内でおすすめします。そのようなブランド言及をモニタリングし、さらに増やす方法をご紹介します。
回答エンジン向けにウェブサイトを最適化する方法
AI があなたのページに到達して内容を読み取り、どんなサイトなのか理解することが可能かどうかを左右する、技術的な修正。