
Come ottimizzare il tuo sito web per i motori di risposta
Content marketer in Ahrefs
- Non bloccare i crawler di IA in robots.txt
- Non usare codice JavaScript complesso che offusca i contenuti
- Migliora la velocità della pagina
- Non perdere tempo con llms.txt
- Correggi gli URL che sono frutto di allucinazioni dell'IA sul tuo sito
- Diventa un'entità riconosciuta
- Preparati al marketing agent-to-agent
I tuoi contenuti possono essere ottimi e comunque non finire mai in una risposta dell'IA.
Ogni tattica di ottimizzazione per l'IA dà per scontato che i sistemi di IA possano raggiungere le tue pagine, leggerle e capire chi sei. Ma nulla di tutto ciò è garantito. Circa il 5,89% dei siti web blocca GPTBot direttamente, ChatGPT sembra abbandonare le pagine che impiegano più di circa due secondi a rispondere e la maggior parte dei crawler di IA non esegue affatto JavaScript.
La buona notizia è che questa è la parte dell'AEO su cui è più facile intervenire. Nessuno di questi aspetti da solo fa ottenere una citazione, ma ognuno può far perdere silenziosamente citazioni che altrimenti avresti guadagnato.
Continua a imparare su YouTube
Non bloccare i crawler di IA in robots.txt
Nessuno dei consigli in questa guida conta se i crawler dell'IA non riescono a leggere le tue pagine. Le pagine bloccate non possono essere citate e spesso ciò succede per errore.
Abbiamo analizzato circa 140 milioni di siti web e abbiamo scoperto che GPTBot è ora il bot di IA più bloccato (5,89% dei siti), con ClaudeBot subito dietro.
Cloudflare blocca per impostazione predefinita le piattaforme di IA, quindi verifica che la tua CDN non ti abbia escluso a tua insaputa.
Consentire i crawler di IA non è una decisione una tantum, perché ogni piattaforma gestisce diversi bot che svolgono compiti differenti.
Solo OpenAI ne gestisce tre:
- GPTBot raccoglie contenuti per l'addestramento
- OAI-SearchBot crea l'indice di ricerca da cui ChatGPT recupera le informazioni
- ChatGPT-User recupera una pagina in tempo reale quando qualcuno ne parla nel mezzo di una conversazione
I compromessi sono diversi per ciascuno. Poiché bloccare GPTBot esclude i contenuti dai dati di addestramento del prossimo modello, è una decisione che di solito gli editori valutano. Bloccare OAI-SearchBot rimuove il sito dall'indice in cui cerca ChatGPT ed è questo che costa citazioni e traffico di referral. Molti siti bloccano per errore il secondo, anche se intendono bloccare solo il primo.
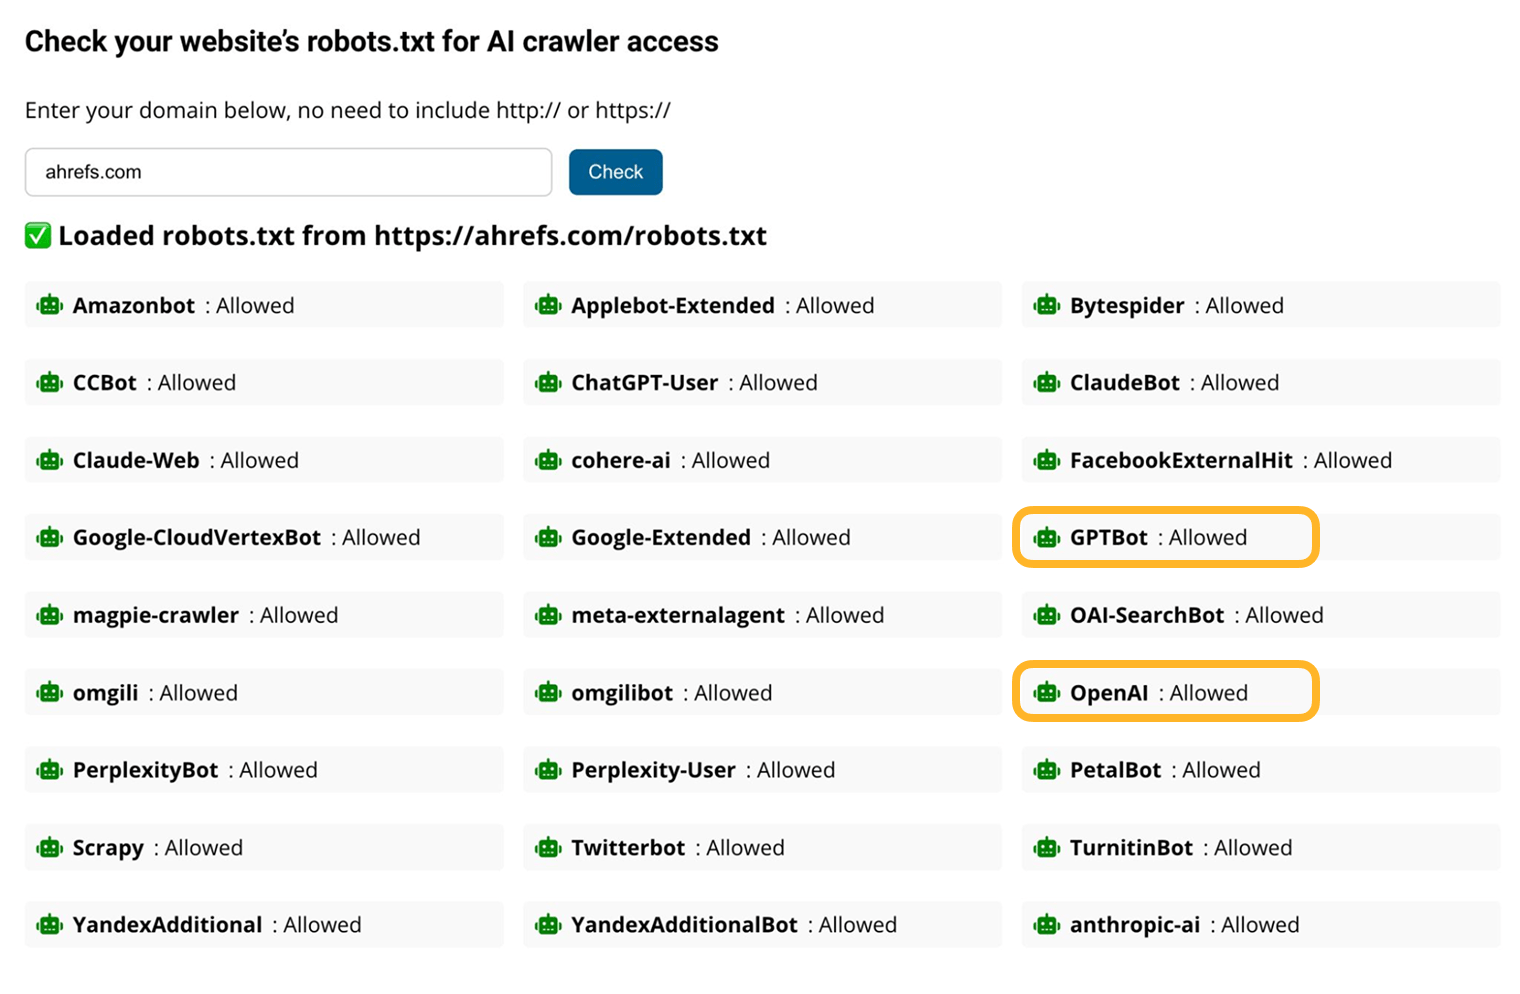
Il modo più rapido per controllare la situazione è usare uno strumento come AI Crawler Access Checker, che legge il file robots.txt e indica quali crawler sono autorizzati a passare.
Per vedere quali bot stanno arrivando davvero, e non solo quali sono consentiti, consulta Bot Analytics di Ahrefs. Traccia le visite in 12 categorie di bot, incluso un filtro di IA dedicato, usando dati lato server tramite Cloudflare, quindi funziona senza aggiungere JavaScript al sito.
Non usare codice JavaScript complesso che offusca i contenuti
I crawler dell'IA tendono a leggere l'HTML grezzo e per lo più non eseguono il rendering di JavaScript come fa un browser.
Ciò significa che qualsiasi cosa compaia solo dopo l'esecuzione di JS lato client può risultare invisibile per loro.
Vai sul sicuro e attieniti al rendering lato server per dare alla tua pagina le migliori possibilità di visibilità per l'IA.
Migliora la velocità della pagina
Le pagine che si caricano lentamente possono influire negativamente sulle prestazioni nella ricerca tradizionale, ma, se non altro, sembra che la penalizzazione sia ancora più grande nei motori di risposta. La velocità della pagina sembra aiutare a determinare se finisci o meno nella finestra di contesto del modello.1
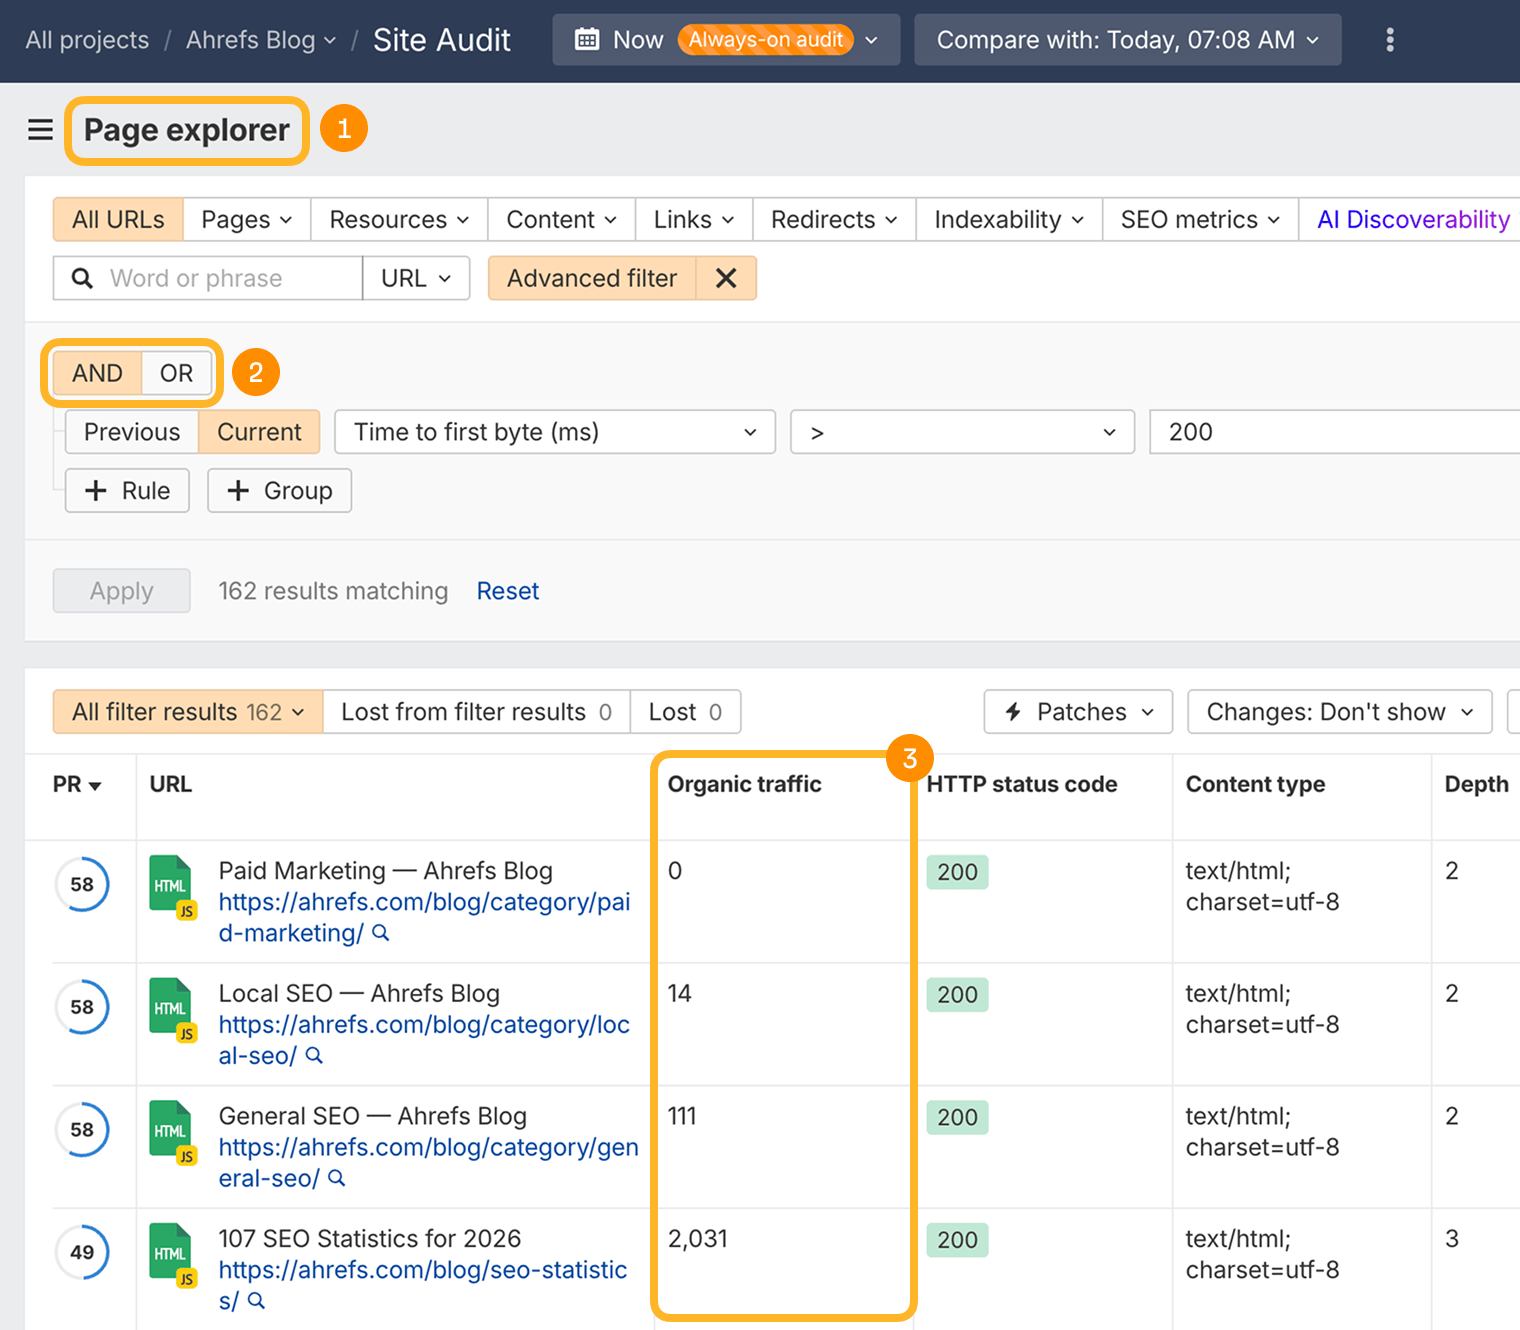
Controlla la velocità della tua pagina (nota come Time-to-First-Byte) in Site Audit:
Non perdere tempo con llms.txt
llms.txt è uno standard proposto per un file Markdown nella root del dominio (ad es. website.com/llms.txt) che indica agli LLM dove si trova il contenuto migliore: documentazione, policy, tassonomie di prodotto. In linea di principio, è come robots.txt per i modelli linguistici.
Ma in pratica nessuno dei principali provider di LLM si è impegnato a leggerlo – né OpenAI, né Anthropic, né Google.
Abbiamo verificato cosa succede davvero quando un sito web aggiunge llms.txt. Su 137.000 domini che usano Web Analytics di Ahrefs, il 28% pubblica un file llms.txt. Dei circa 38.000 con un file valido, il 97% ha ricevuto zero richieste per quel file nel mese che abbiamo monitorato.
Il 97% dei file llms.txt non viene mai richiesto
Studio di Ahrefs su 137.000 domini che utilizzano Web Analytics di Ahrefs.
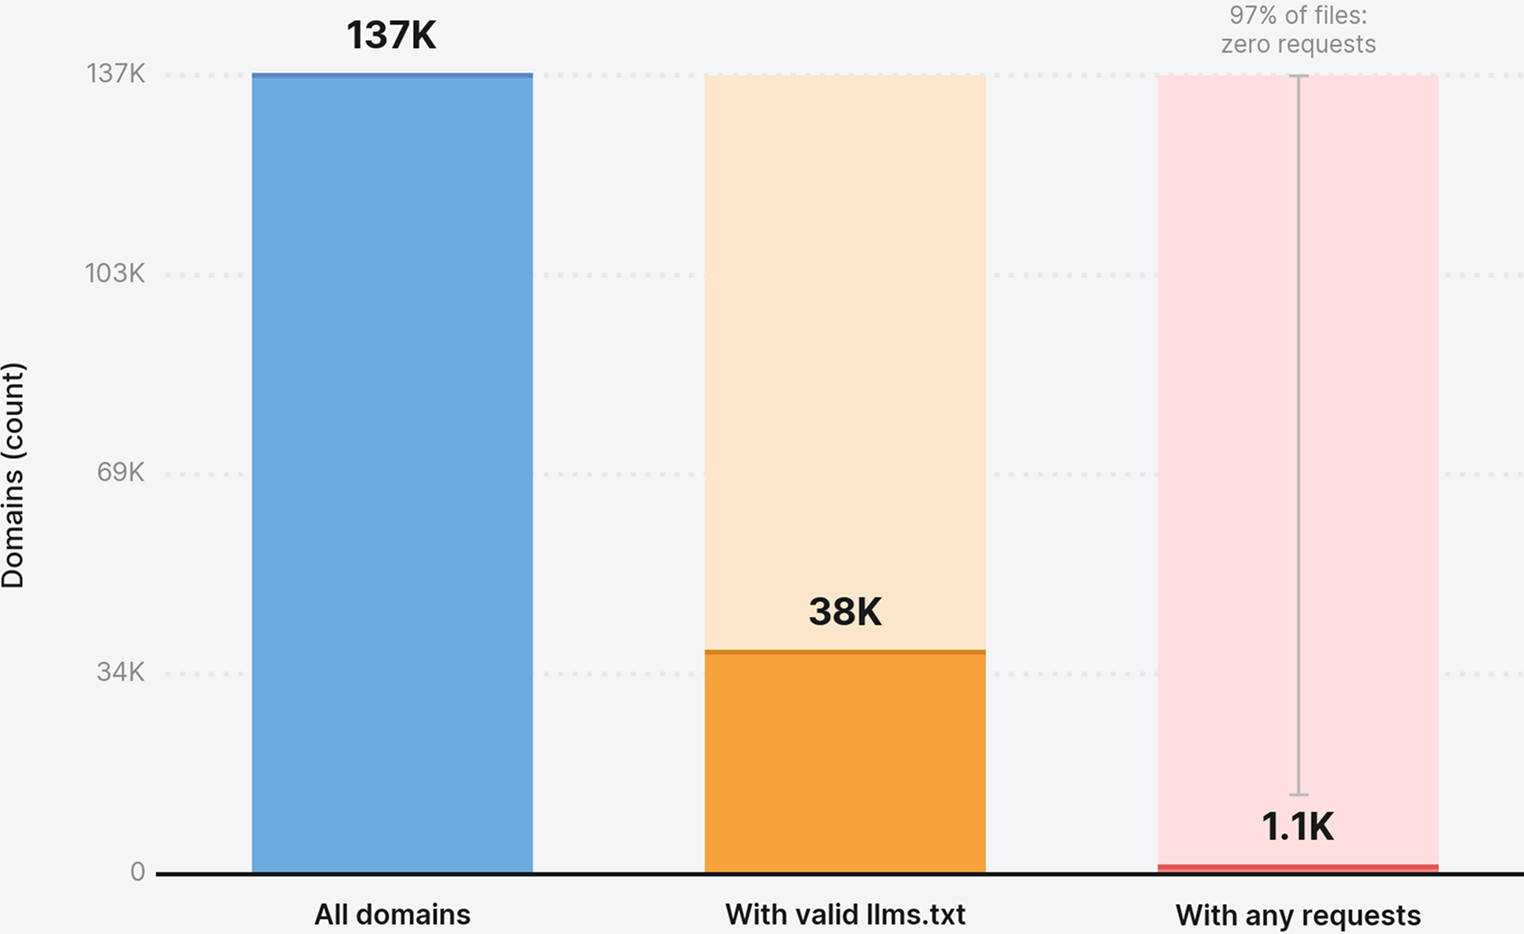
Della piccola quota di file che è stata effettivamente recuperata, il 96% delle richieste proveniva da bot. Slackbot, il bot di anteprima dei link, ha recuperato llms.txt più spesso di quanto abbia fatto PerplexityBot. In poche parole, i motori di ricerca con IA più importanti non sembrano usarlo.
Google è stato esplicito su questo punto. La sua guida su come ottimizzare per le funzionalità di IA generativa ha una sezione intitolata letteralmente "mythbusting" (sfatamento dei miti) che dice ai proprietari dei siti che non servono file leggibili dalle macchine come llms.txt per comparire nella ricerca con IA generativa. John Mueller si è spinto oltre, paragonando llms.txt al vecchio meta tag keywords:

Per quanto ne so, nessuno dei servizi di IA afferma di usare LLMs.TXT (e i log del server confermano che non lo controllano nemmeno). Per me è paragonabile al meta tag keywords: è quanto dichiara il proprietario del sito sul proprio sito, ma il sito è davvero così? Certo, puoi verificarlo, ma a quel punto perché non controllare direttamente il sito?
John Mueller, Search Advocate, Google
Quindi, dovresti crearne uno? Se pubblichi documentazione per sviluppatori, richiede circa dieci minuti e c'è un caso d'uso plausibile. Mueller lo ha descritto come un "supporto temporaneo, forse per risparmiare alcuni token" per gli strumenti di coding basati su IA che analizzano la documentazione. Per tutti gli altri, è uno sforzo senza un ritorno misurato, con in più un piccolo svantaggio: rendere più facile per i competitor fare scraping in blocco dei tuoi contenuti.
Correggi gli URL che sono frutto di allucinazioni dell'IA sul tuo sito
Gli assistenti di IA inventano link, e lo fanno spesso. Abbiamo verificato lo stato HTTP di 16 milioni di URL citati da ChatGPT, Perplexity, Copilot, Gemini, Claude e Mistral e abbiamo scoperto che gli assistenti di IA inviano i visitatori a pagine 404 con una frequenza 2,87 volte maggiore rispetto a Google Search.
ChatGPT è di gran lunga il peggiore. L'1,01% degli URL cliccati restituisce un 404, contro lo 0,15% di base su Google.
Tassi di 404 per canale di referral
Dati di Web Analytics – 16.000.000 URL analizzati.
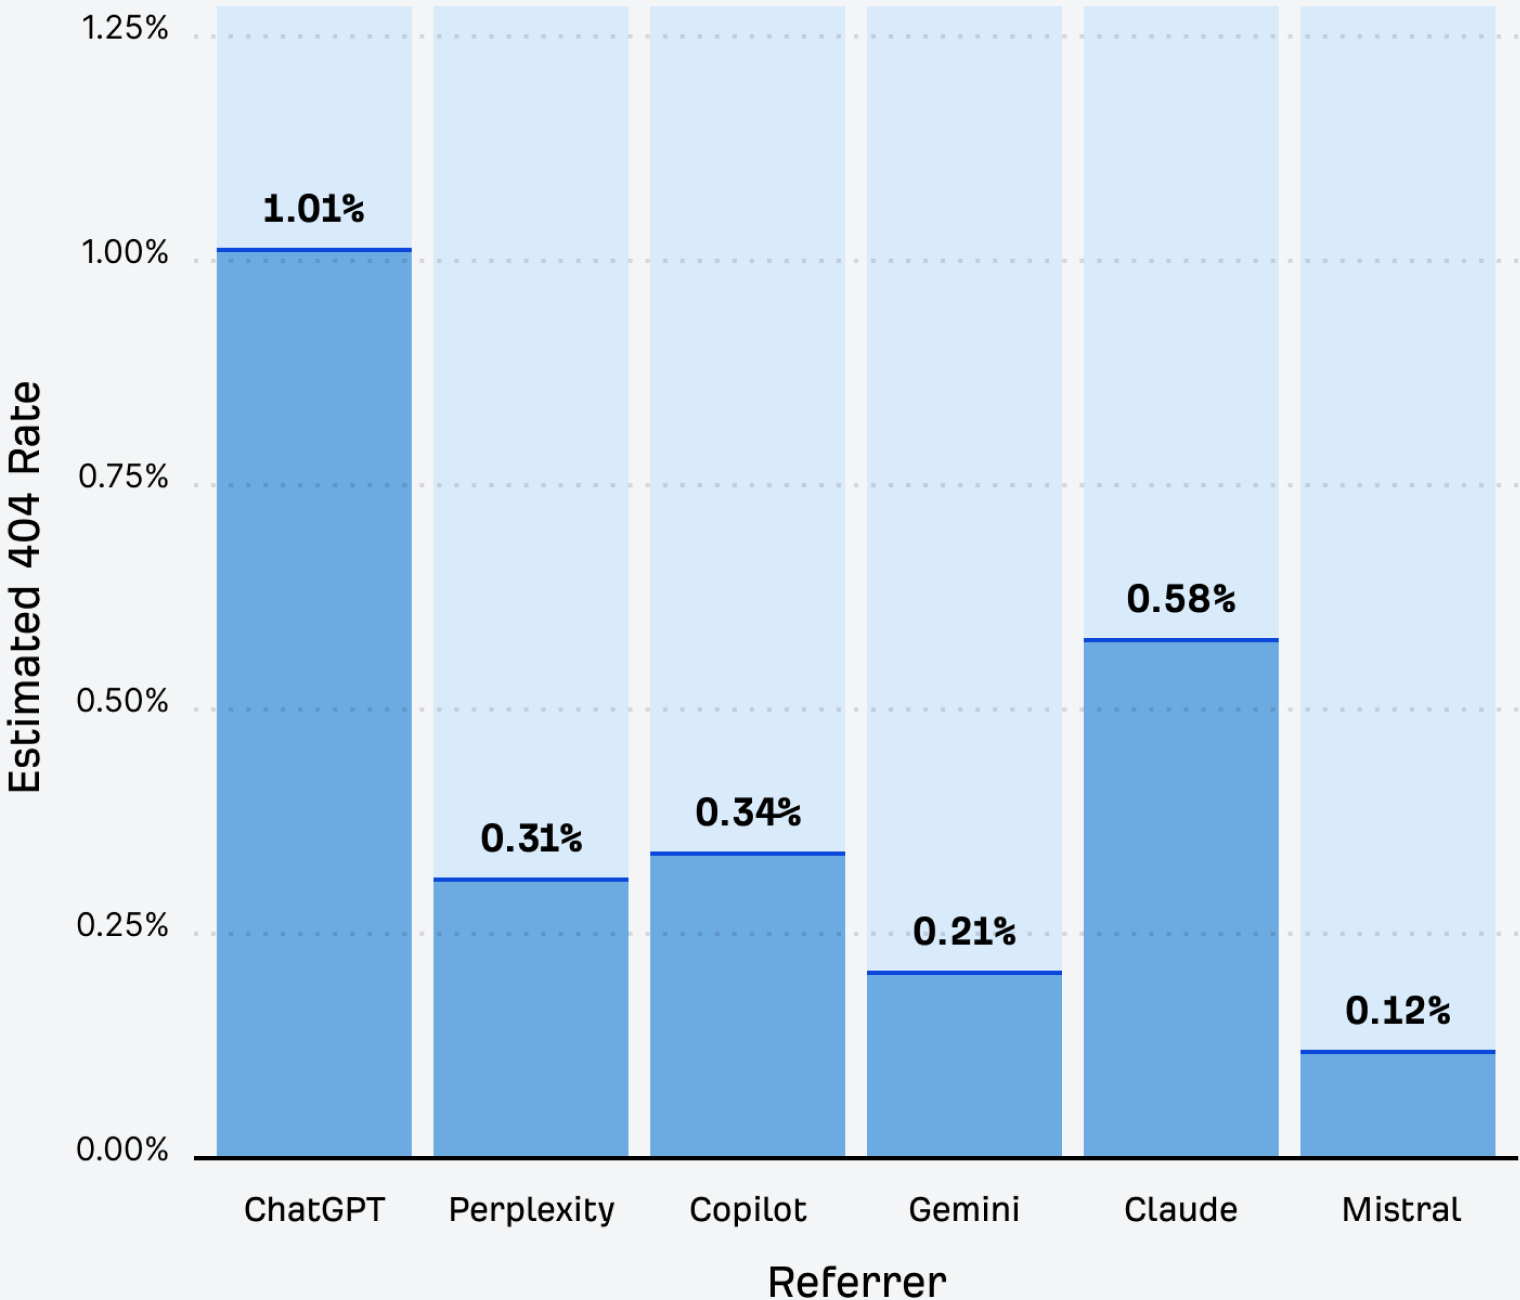
Perplexity (0,87%) e Gemini (0,86%) sono quasi perfettamente allineati al tasso di Google, pari allo 0,84%, per gli URL citati. È logico, visto che entrambi recuperano dall'indice di Google, quindi ereditano i suoi link non funzionanti invece di inventarsene di propri.
Gli URL inventati vengono dedotti dai pattern esistenti. Un URL allucinato comune per il nostro sito era ahrefs.com/keywords, perché scriviamo continuamente di parole chiave e il modello ha dato per scontato che una pagina del genere dovesse esistere. Non esiste.
Questa è una delle poche vere opportunità gratuite nell'AEO. Una persona con un'intenzione reale ha chiesto del tuo prodotto, è arrivata sul tuo sito e si è trovata in un vicolo cieco. Ce ne sono di tre tipi:
- URL allucinati. Pagine che un modello inventa a partire dalla struttura dei tuoi URL.
- URL obsoleti. Pagine esistite in passato, ricordate dai dati di addestramento o da altre fonti di dati non aggiornate.
- URL con errori di digitazione o varianti. Quasi corrispondenze su pagine reali.
Per questo motivo, abbiamo aggiunto un filtro a Web Analytics che aiuta a trovare URL allucinati in soli due clic. Se cerchi un'alternativa semplice a Google Analytics, gratuita fino a 1 milione di eventi al mese, dagli un'occhiata:
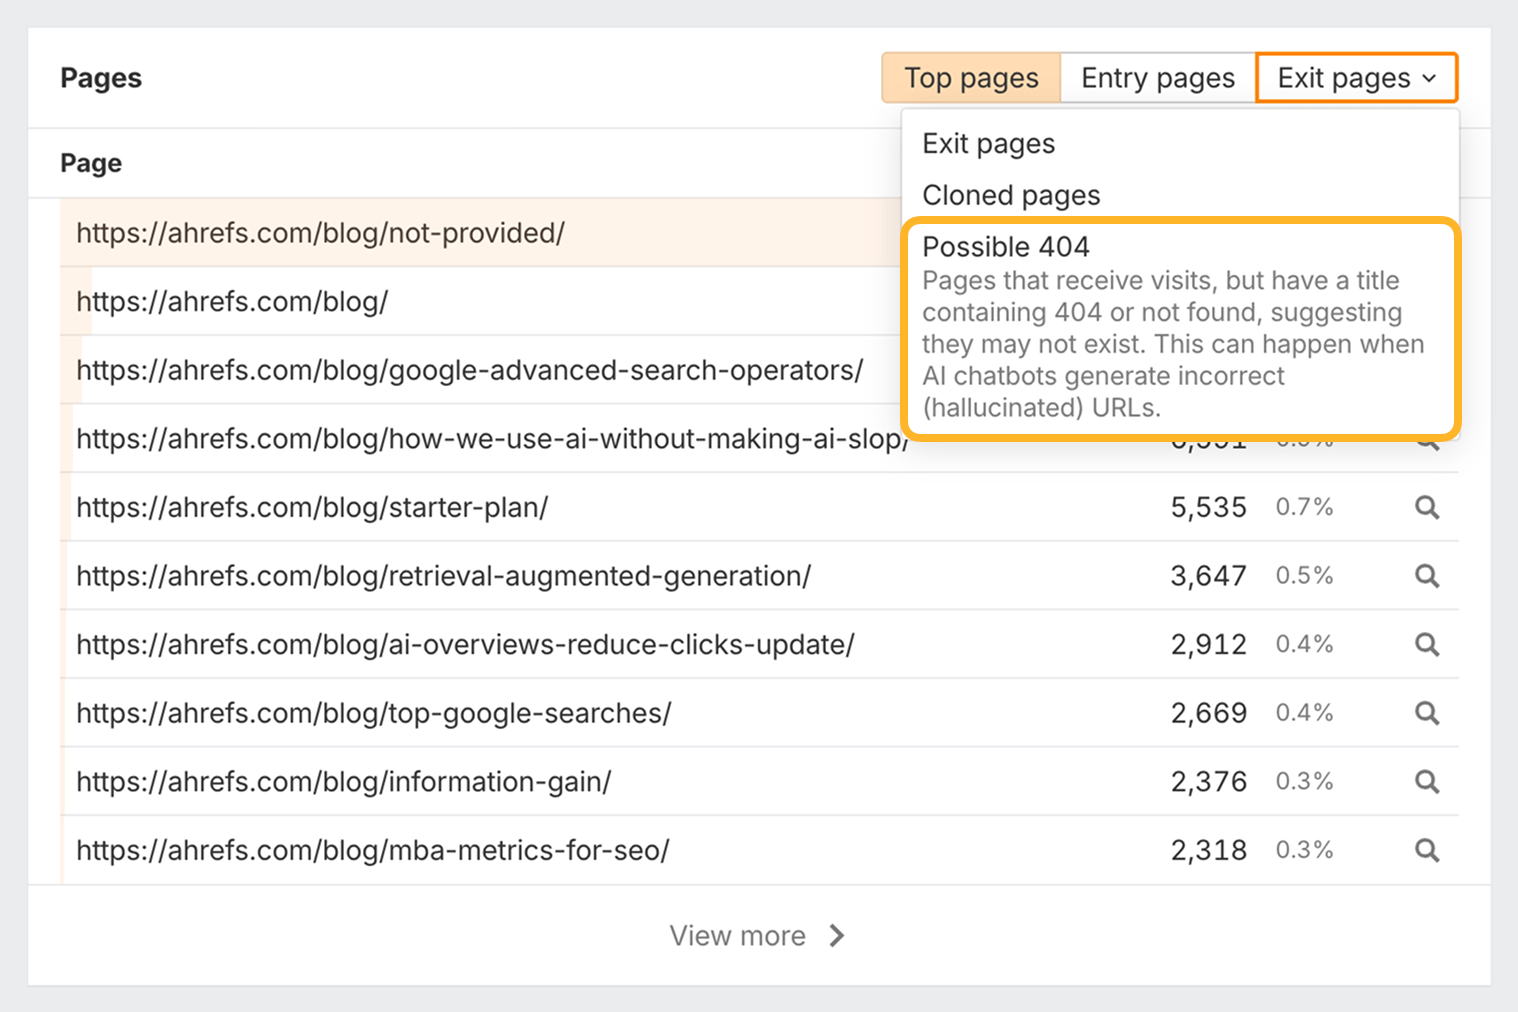
Se un URL allucinato continua a essere richiesto, il modello suggerisce quale pagina i tuoi visitatori si aspettano che tu abbia.
Diventa un'entità riconosciuta
Ogni tattica di questa guida, in ultima analisi, dipende da una cosa: se i sistemi di IA riconoscono il tuo brand come un'entità distinta.
Lo sapevi?
Un'entità è qualsiasi cosa distinta del mondo reale che un motore di ricerca o un'IA può riconoscere e distinguere da tutto il resto: una persona, un luogo, un'azienda, un prodotto o un concetto specifico (come "Dmytro Gerasymenko", "Ahrefs" o "Singapore"), e non semplicemente le parole usate per descriverla.
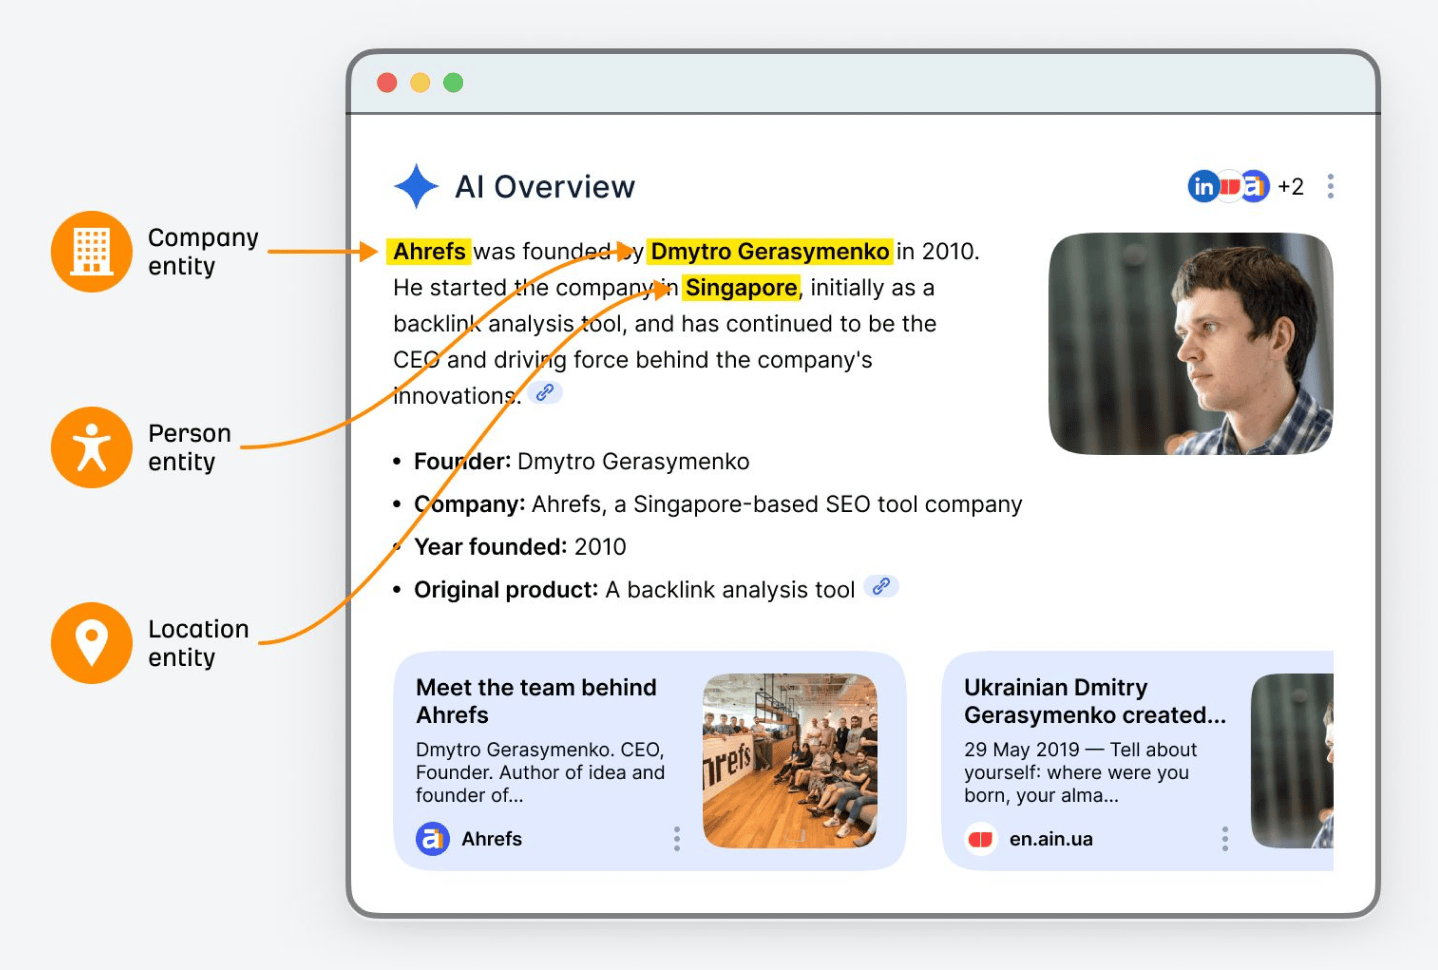
Knowledge Graph di Google — un database di 54 miliardi di entità e oltre 1.600 miliardi di fatti su come sono correlate — non è più solo il motore alla base dei Knowledge Panel.
Ora è l'infrastruttura di base per AI Overview, AI Mode e Gemini.
Se il tuo brand non è chiaramente definito come un'entità, con segnali coerenti su tutto il tuo sito, nei dati strutturati e in fonti autorevoli di terze parti, rischi di essere invisibile nelle risposte dell'IA, non solo nei link blu.
Lo schema viene spesso presentato come un modo rapido per migliorare la visibilità nell'IA e la correlazione superficiale sembra convincente: le pagine citate dall'IA hanno quasi tre volte più probabilità di avere JSON-LD.
Lo schema è molto più comune nelle pagine citate dall'IA
Studio di Ahrefs su 6 milioni di pagine (2 milioni di pagine per gruppo).
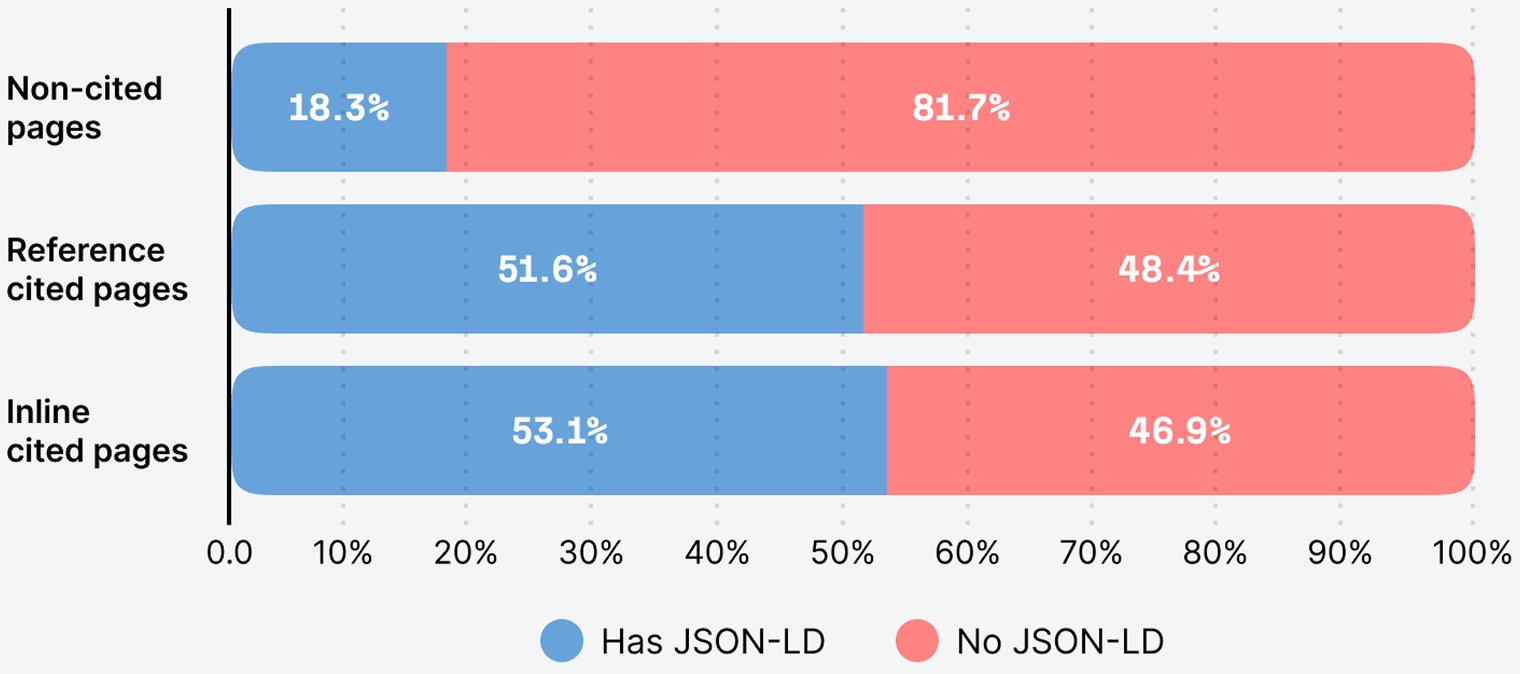
Ma la correlazione non è causalità. Abbiamo monitorato 1.885 pagine che hanno aggiunto JSON-LD rispetto a 4.000 controlli e non abbiamo riscontrato alcun incremento significativo in AI Mode o ChatGPT, e un piccolo calo in AI Overview che non siamo riusciti ad attribuire allo schema.
Quindi lo schema è inutile? No, ma il suo ruolo è lento e indiretto: non è una tattica per ottenere risultati rapidi.
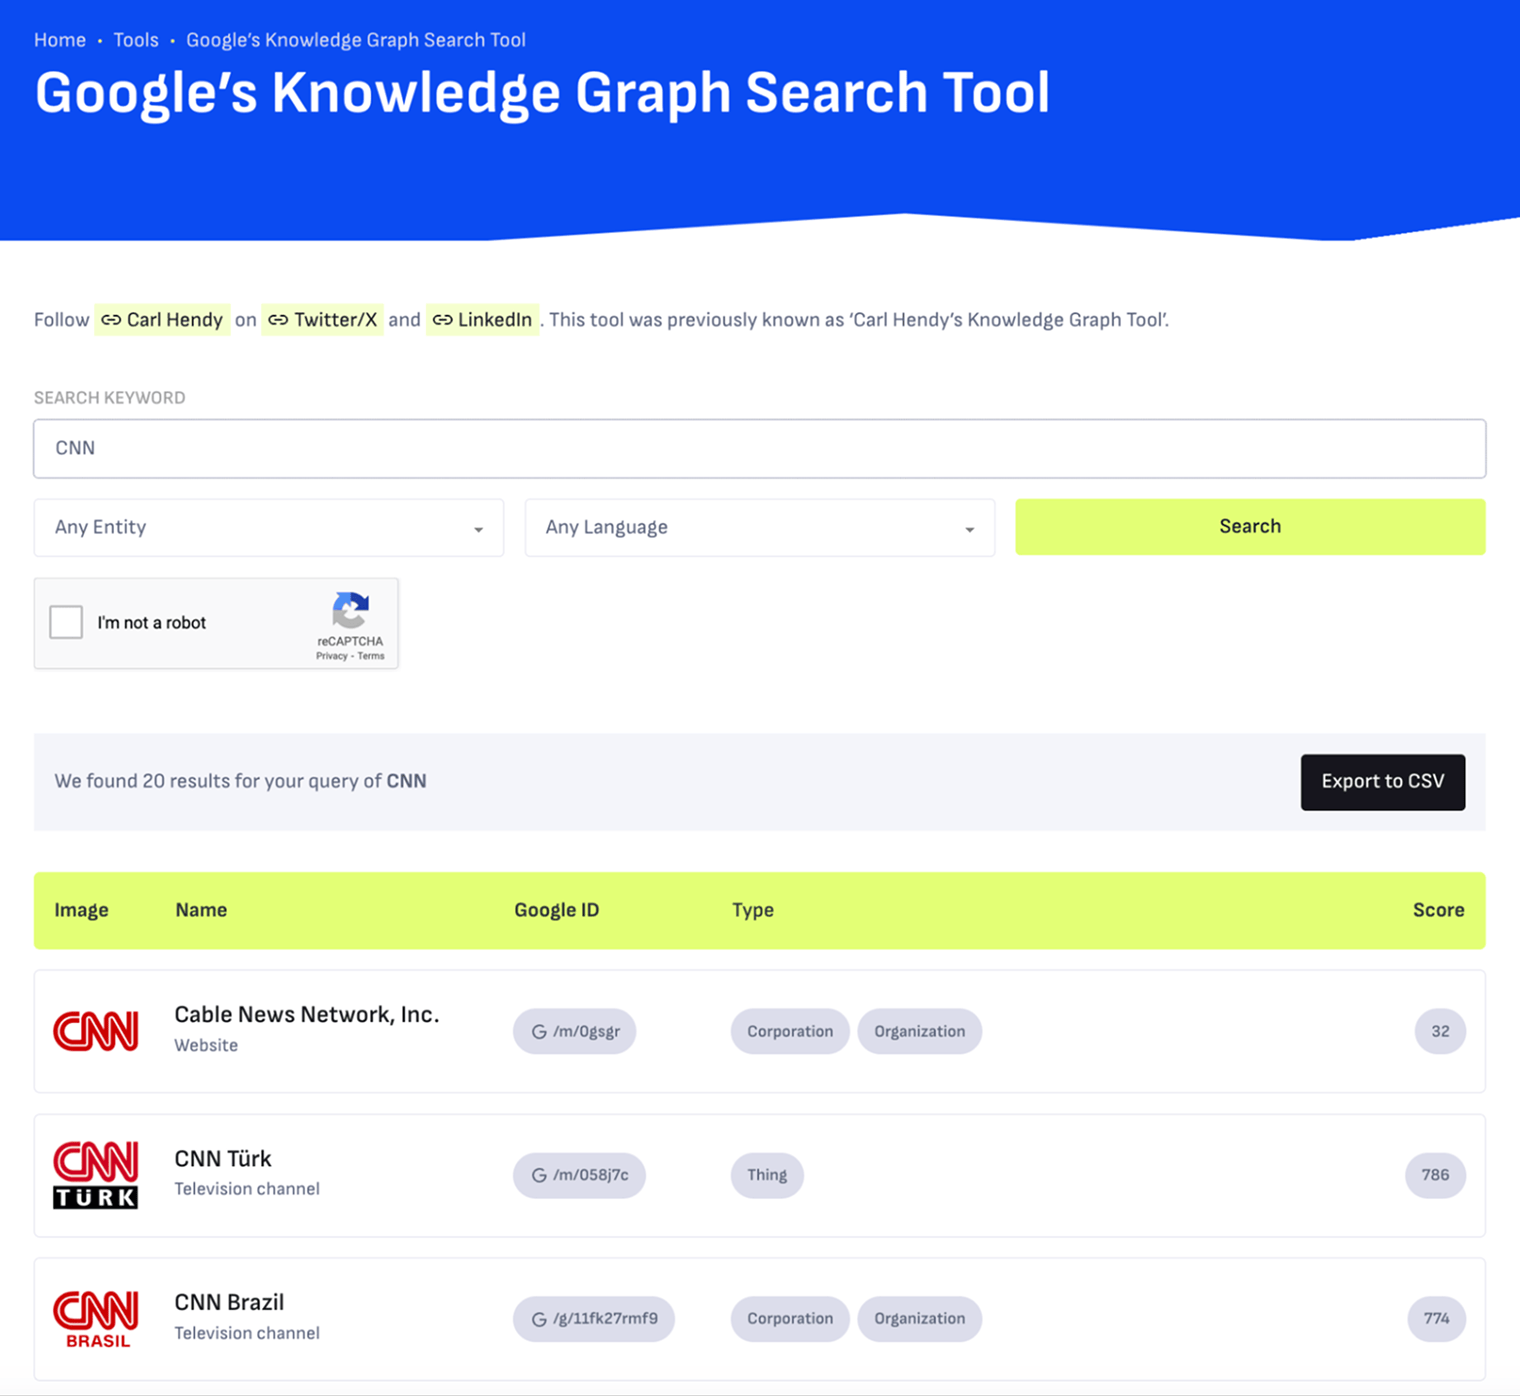
Puoi verificare se Google ti riconosce già usando la sua Knowledge Graph API o uno strumento di verifica gratuito per vedere che tipo di entità ti ha assegnato e se gli attributi sono corretti.
Ad esempio, Knowledge Graph Tool di Carl Hendy ti mostra risultati per persone, aziende, prodotti, luoghi e altre entità.
Da lì, cerca di ottenere menzioni da pubblicazioni autorevoli e mantieni coerenti le tue informazioni ovunque: lo stesso nome, descrizione e categoria su tutto il sito, i profili e gli elenchi di terze parti.
Poi aggiungi lo schema dove è naturale, dando priorità ai tipi che definiscono la tua entità e le sue relazioni:
Schema Organization e proprietà sameAs con collegamenti a Wikipedia, Wikidata e ai tuoi profili social
Schema Person per gli autori del tuo sito
Schema Product per le tue offerte
Suggerimento
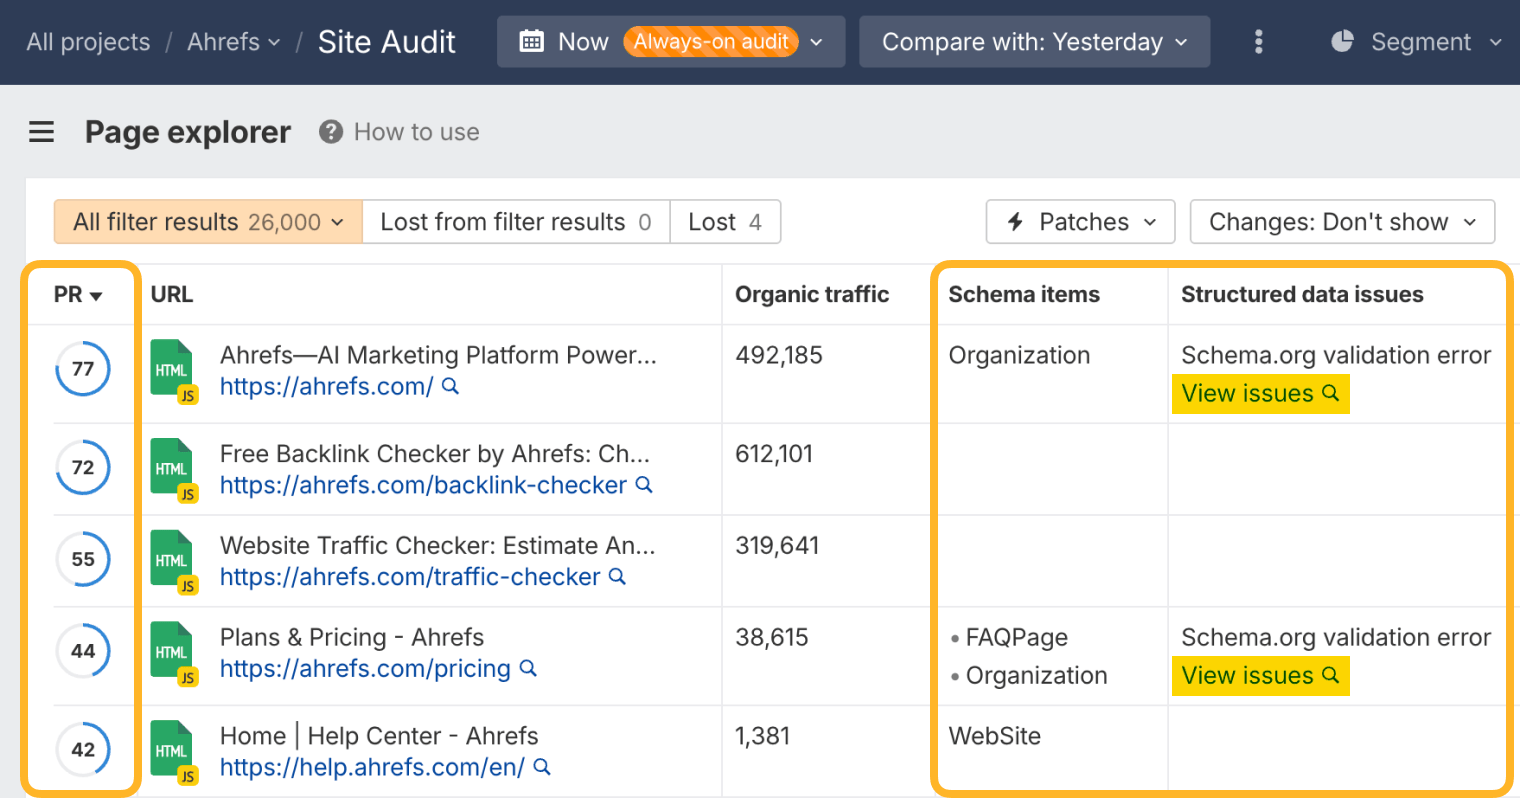
Trova le tue pagine con maggiore autorevolezza e assicurati che abbiano un markup Schema pulito.
Puoi farlo andando al report Page Explorer di Site Audit e ordinando i dati per "Page Rating".
Il Page Rating (PR) mostra la forza del profilo di backlink interni ed esterni del tuo URL rispetto agli altri URL inclusi nella scansione.
Poi controlla la colonna "Elementi Schema" per verificare lo schema esistente e la colonna "Problemi relativi ai dati strutturati" per individuare dati strutturati mancanti o non validi.
Preparati al marketing agent-to-agent
Ti lascio con quest'ultima riflessione: un numero crescente di "lettori" che stai cercando di influenzare sono in realtà agenti di IA che navigano e acquistano per conto del tuo pubblico.
Infatti, a giugno 2026 il CEO di Cloudflare, Matthew Prince, ha rivelato che il traffico agentico (bot/crawler/agente) aveva superato per la prima volta la soglia del 50% nella storia di Internet.2, 3
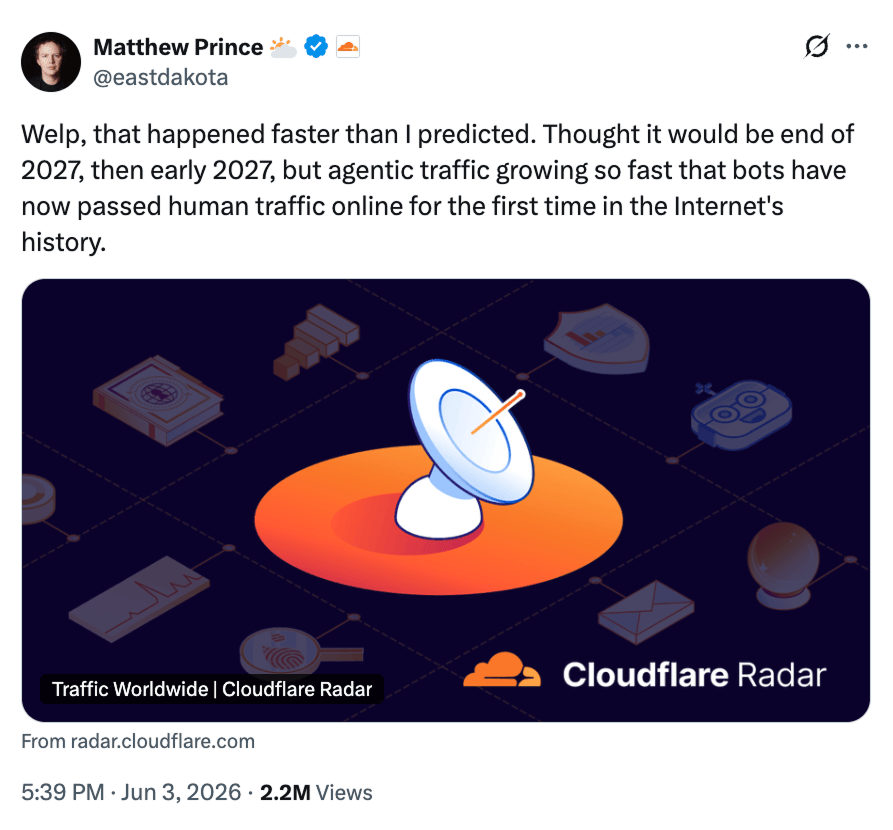
Ben lungi dall'essere un caso limite o una novità, le ricerche di "IA agentica" sono aumentate di 84 volte in tre anni, mentre il costo per far funzionare un agente è sceso da dollari a centesimi.
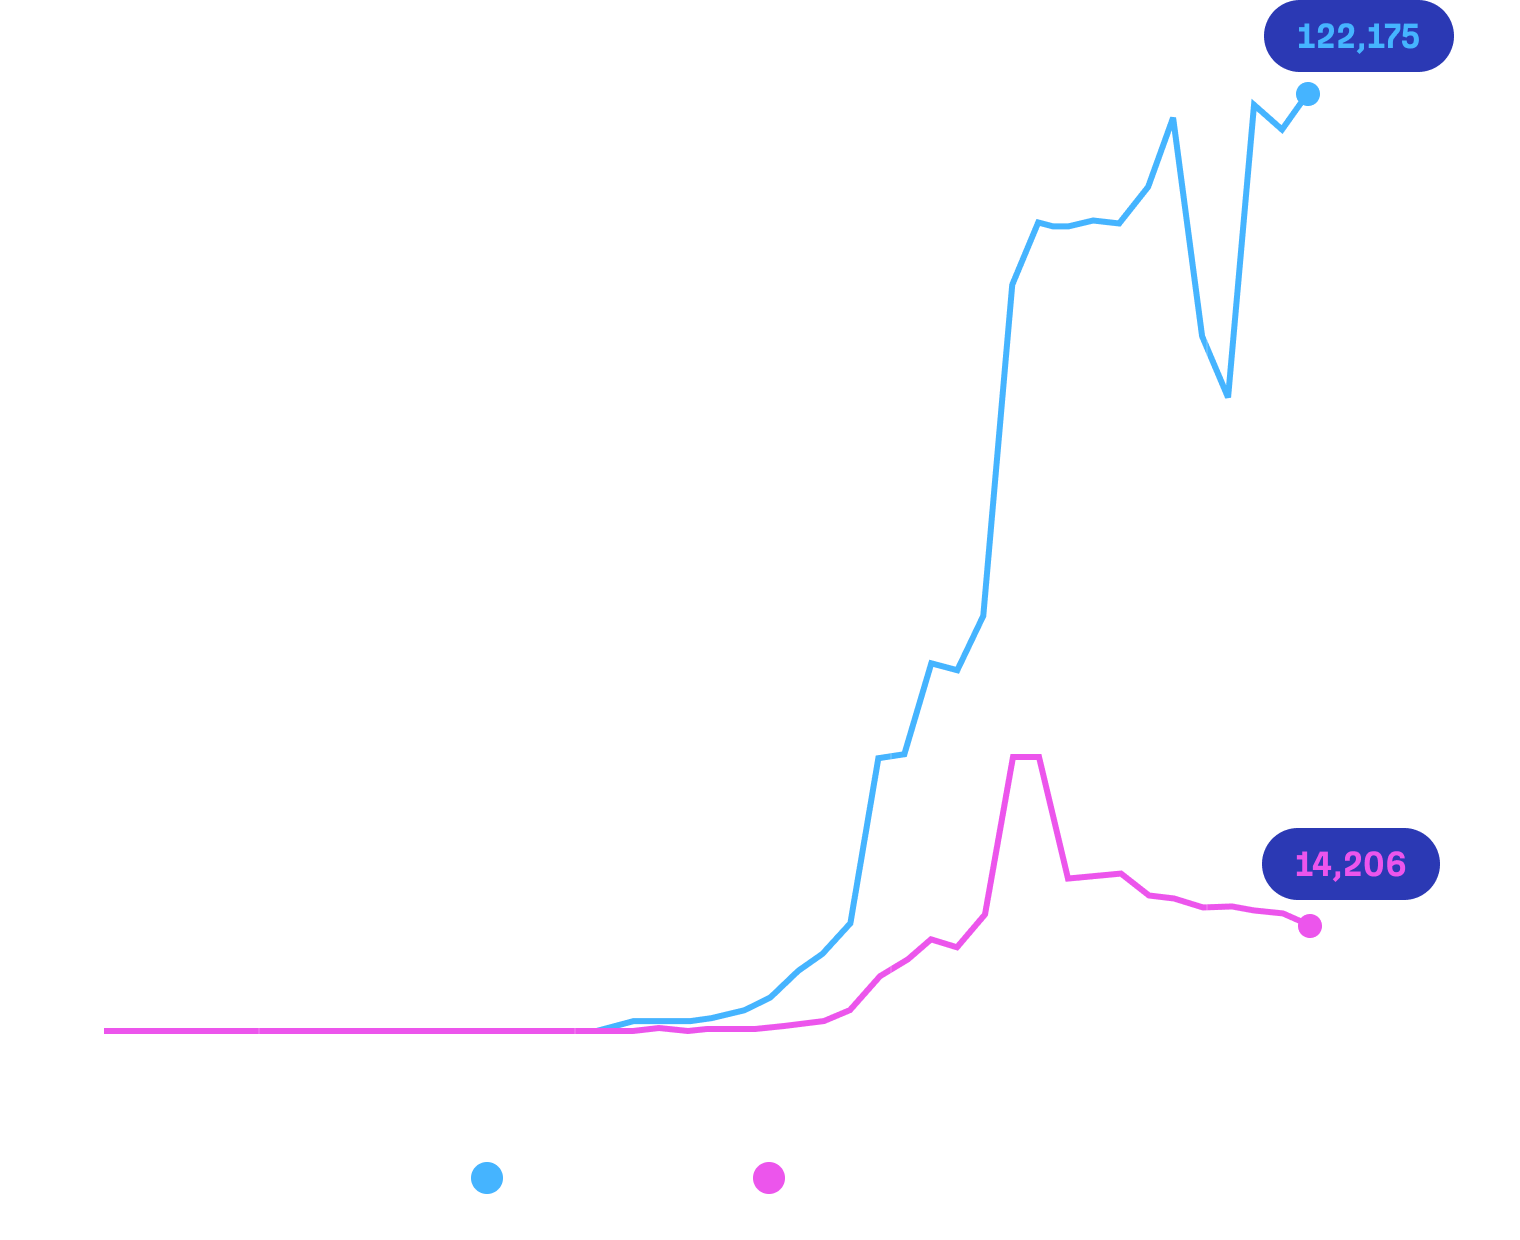
Approfondimenti
Per ora non devi precipitarti a ricostruire il tuo sito web solo per gli agenti di IA. Ma il vecchio consiglio di creare contenuti solo per gli esseri umani e non preoccuparsi dei robot probabilmente non regge più come una volta.
Questo capitolo parla di come influenzare l'IA di cui l'essere umano si fida; il marketing agent-to-agent è proprio questo, ma fa un passo in più.
Riferimenti
- "ChatGPT Is a Search Engine. Here's How It Works." David McSweeney, QueryBurst.
- Matthew Prince (@eastdakota) su X. 3 giugno 2026.
Louise è una Content Marketer di Ahrefs. Negli ultimi dieci anni ha ricoperto ruoli senior nella gestione dei contenuti presso brand SaaS: Pi Datametrics, BuzzSumo e Cision. In questi anni ha pubblicato centinaia di post sul blog, guidato ricerche leader di settore e sviluppato programmi di webinar con esperti.
Louise ha appreso le basi della SEO lavorando presso l'azienda specializzata in SEO per imprese Pi. Nel giro di poche settimane dall'assunzione, aveva pubblicato un pezzo sulla cannibalizzazione che attirò l'attenzione del nome più importante della SEO dell'epoca: Rand Fishkin. Da allora ha scritto su vari temi, dal link building manipolativo alla sindacazione dei contenuti, alla previsione della domanda di ricerca. Nel tempo libero, ha approfondito la sua comprensione pratica della SEO creando siti web per due attività locali.
Puoi leggere gli scritti di Louise su pubblicazioni di settore come Search Engine Watch, The Drum, The Telegraph e Spin Sucks.
Esplora tutte le guide all'AEO
Che cos'è l'AEO (Answer Engine Optimization)?
Inizia da qui: che cos'è l'AEO, in cosa differisce dalla SEO e quali sono le sette attività preliminari per partire con il piede giusto.
Come funzionano i motori di risposta
Cosa succede davvero tra un prompt e una risposta — e come inserirsi nel processo.
Come monitorare la visibilità nell'IA
Non puoi ottimizzare ciò che non conosci. Ecco sette modi per sapere dove compare il tuo brand nelle risposte dell'IA.
Come scegliere i prompt migliori da monitorare
Bisogna monitorare cluster di prompt, non risposte isolate. Ecco undici posti dove trovare le query che vale la pena monitorare.
Come ottimizzare i contenuti per i motori di risposta
Il posizionamento nei risultati di ricerca ti fa prendere in considerazione, ma per farti citare servono argomenti, formati e modifiche on-page che funzionano.
Come ottenere menzioni del brand nelle risposte dell'IA e monitorarle
L'IA consiglia i brand che ha visto citati altrove. Ecco come monitorare quelle menzioni e ottenerne di più.
Come ottimizzare il tuo sito web per i motori di risposta
Le correzioni tecniche che aiutano l'IA a raggiungere le tue pagine, leggerle e capire chi sei.