
ChatGPTのクエリファンアウト分析:1,500万クエリの調査結果
ルイーズ・ リネハン 作成
Ahrefs の Content Marketer
SEO 業界ではここ数か月、ChatGPT がどのように検索し、情報源を見つけるのかを解明する動きが活発化しています。
Ahrefs チームも、ChatGPT がどのように情報を取得しているのか調査に取り組みました。AI における可視性にどう影響するのかを独自に検証するため、2026 年 8 月と 9 月に記録された 6,660 万件の無料・ログアウト状態での GPT-5.6 Luna のレスポンスと、そこから生じた 1,500 万件のファンアウトクエリを分析しました。
補足
無料セッションは、大多数のユーザーが実際に ChatGPT を使う環境に近いものです。RESONEO 共同創業者のオリヴィエ・ド・セゴンザック氏が Search Engine Land で述べているように、ChatGPT の週間アクティブユーザーの 90% 以上が無料プランを利用しています。さらにログアウトすることで、チャット履歴やメモリの影響を排除できるため、特定ユーザーの過去の会話に左右されない ChatGPT のデフォルト動作を観察できます。
主な調査結果
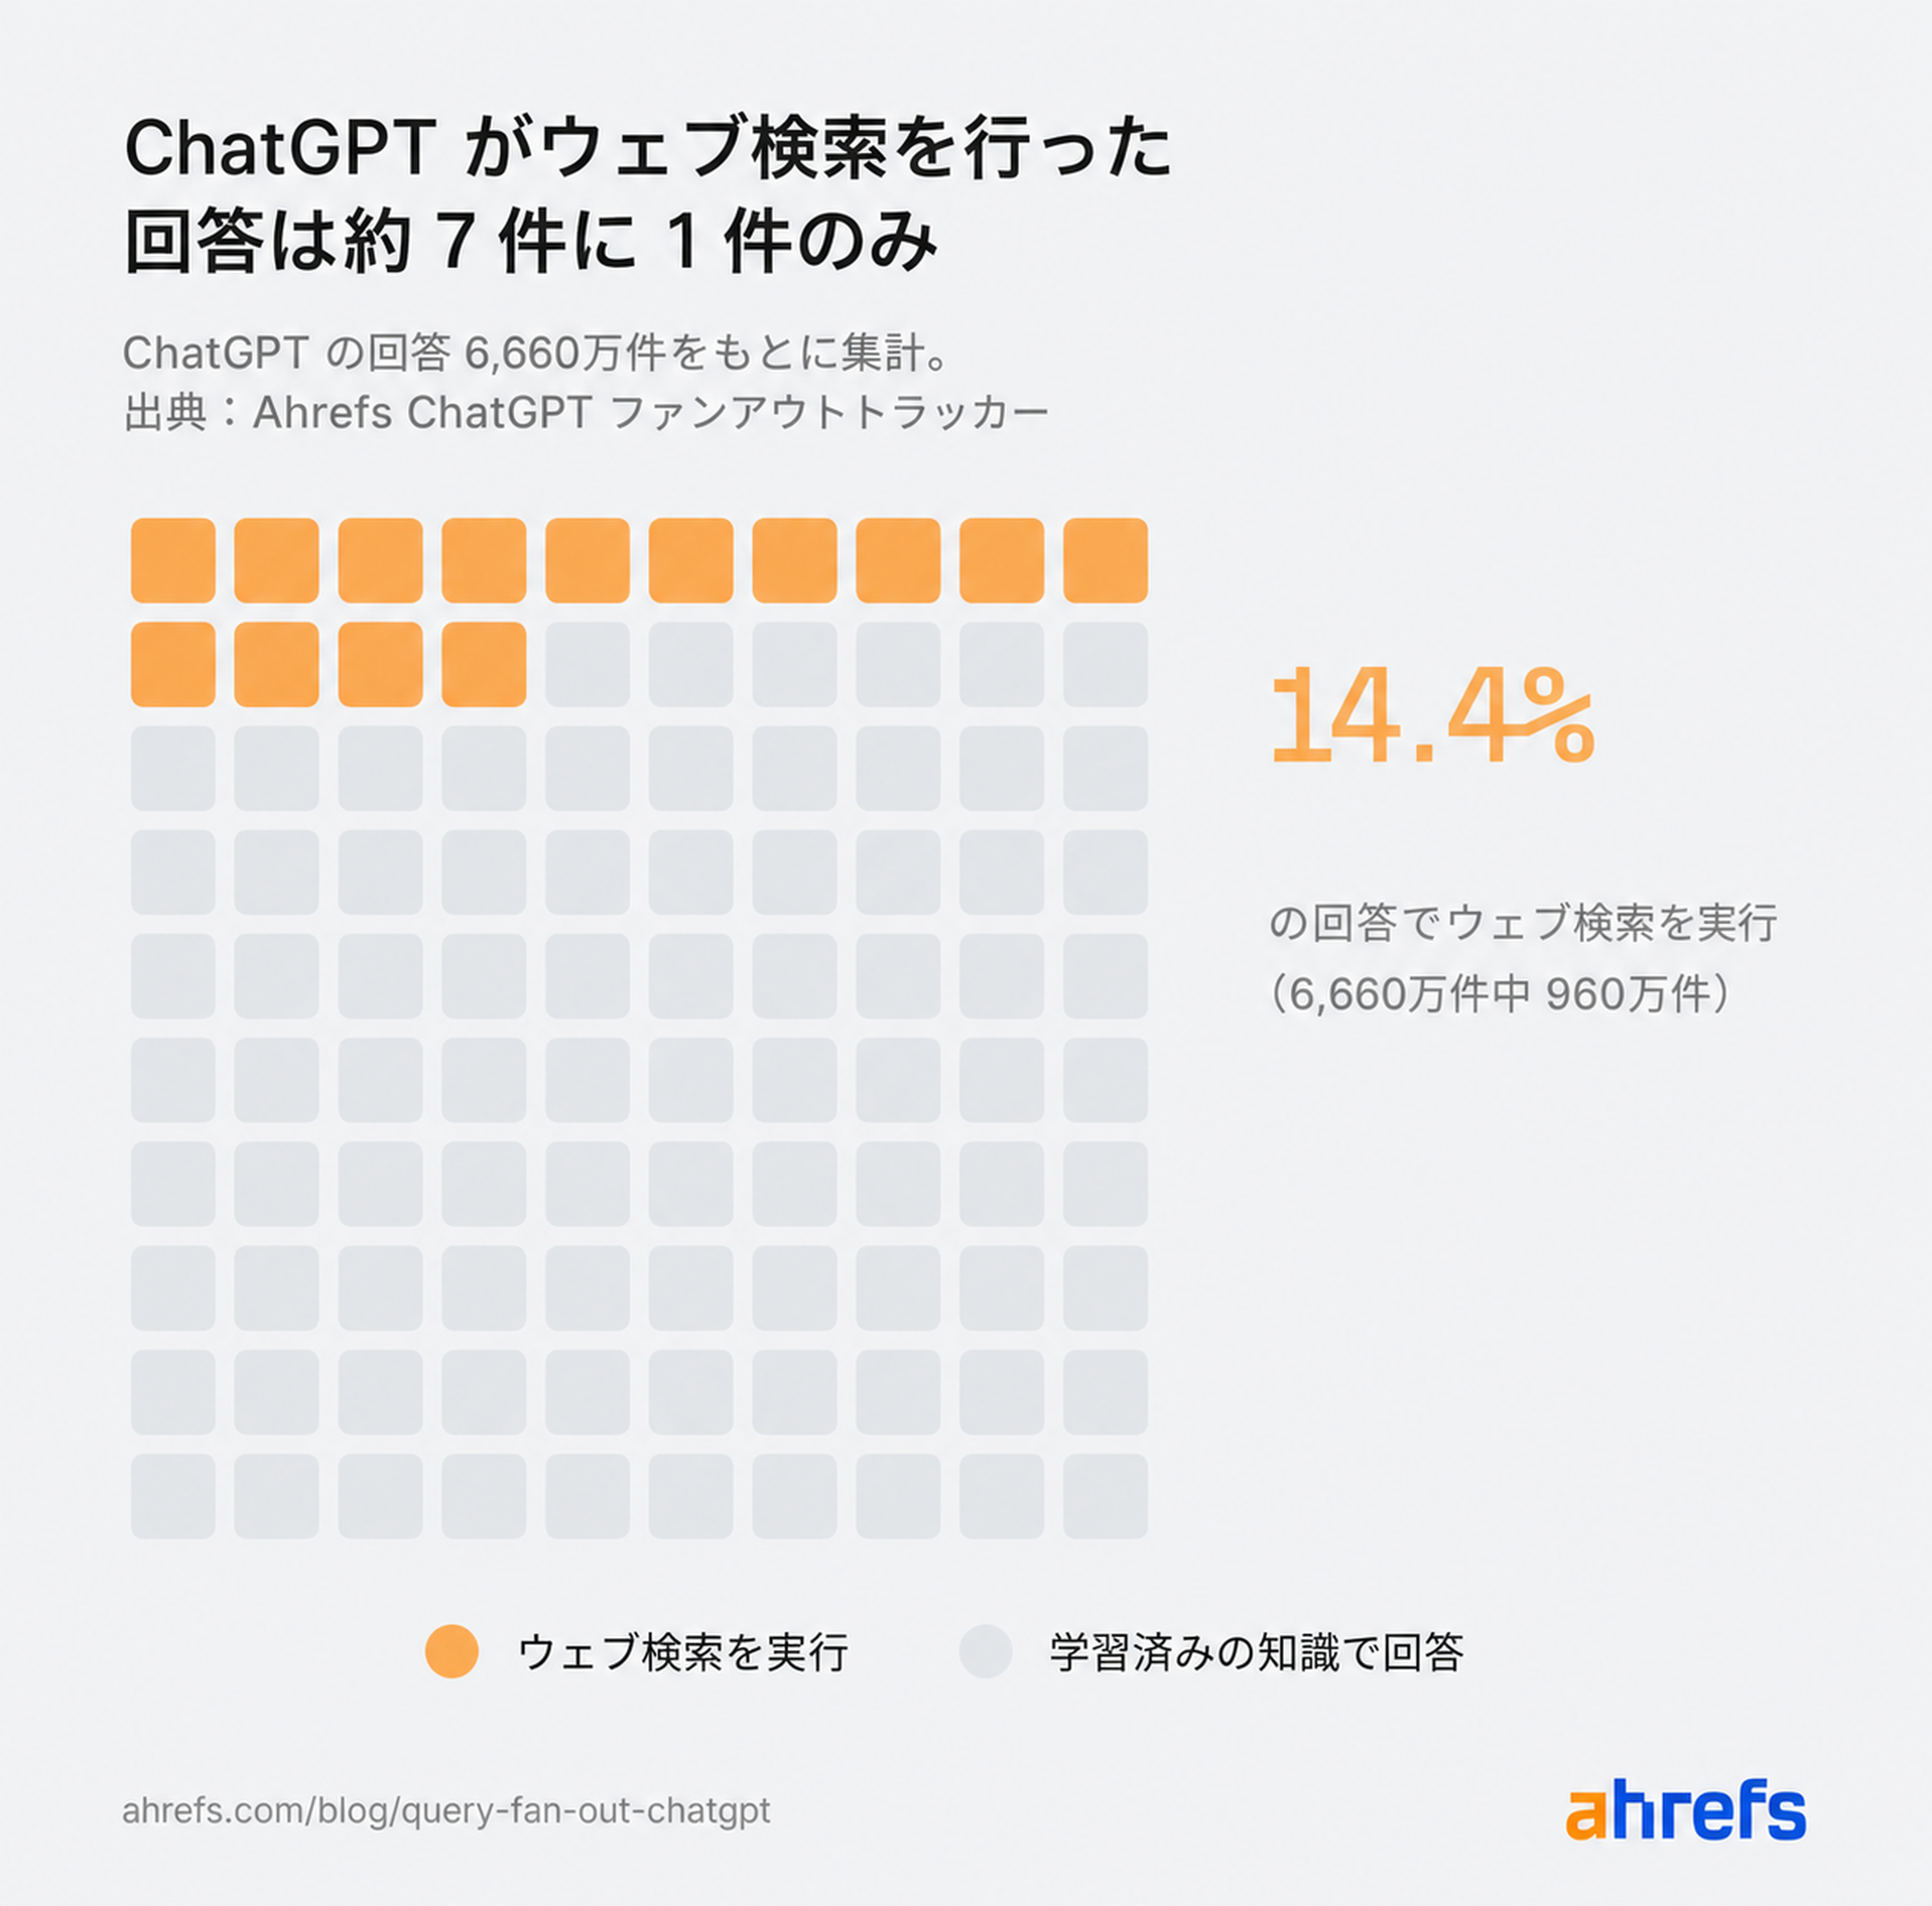
- 6,660 万件のレスポンスのうち、Web 検索が必要だったのはわずか 14.4% でした。
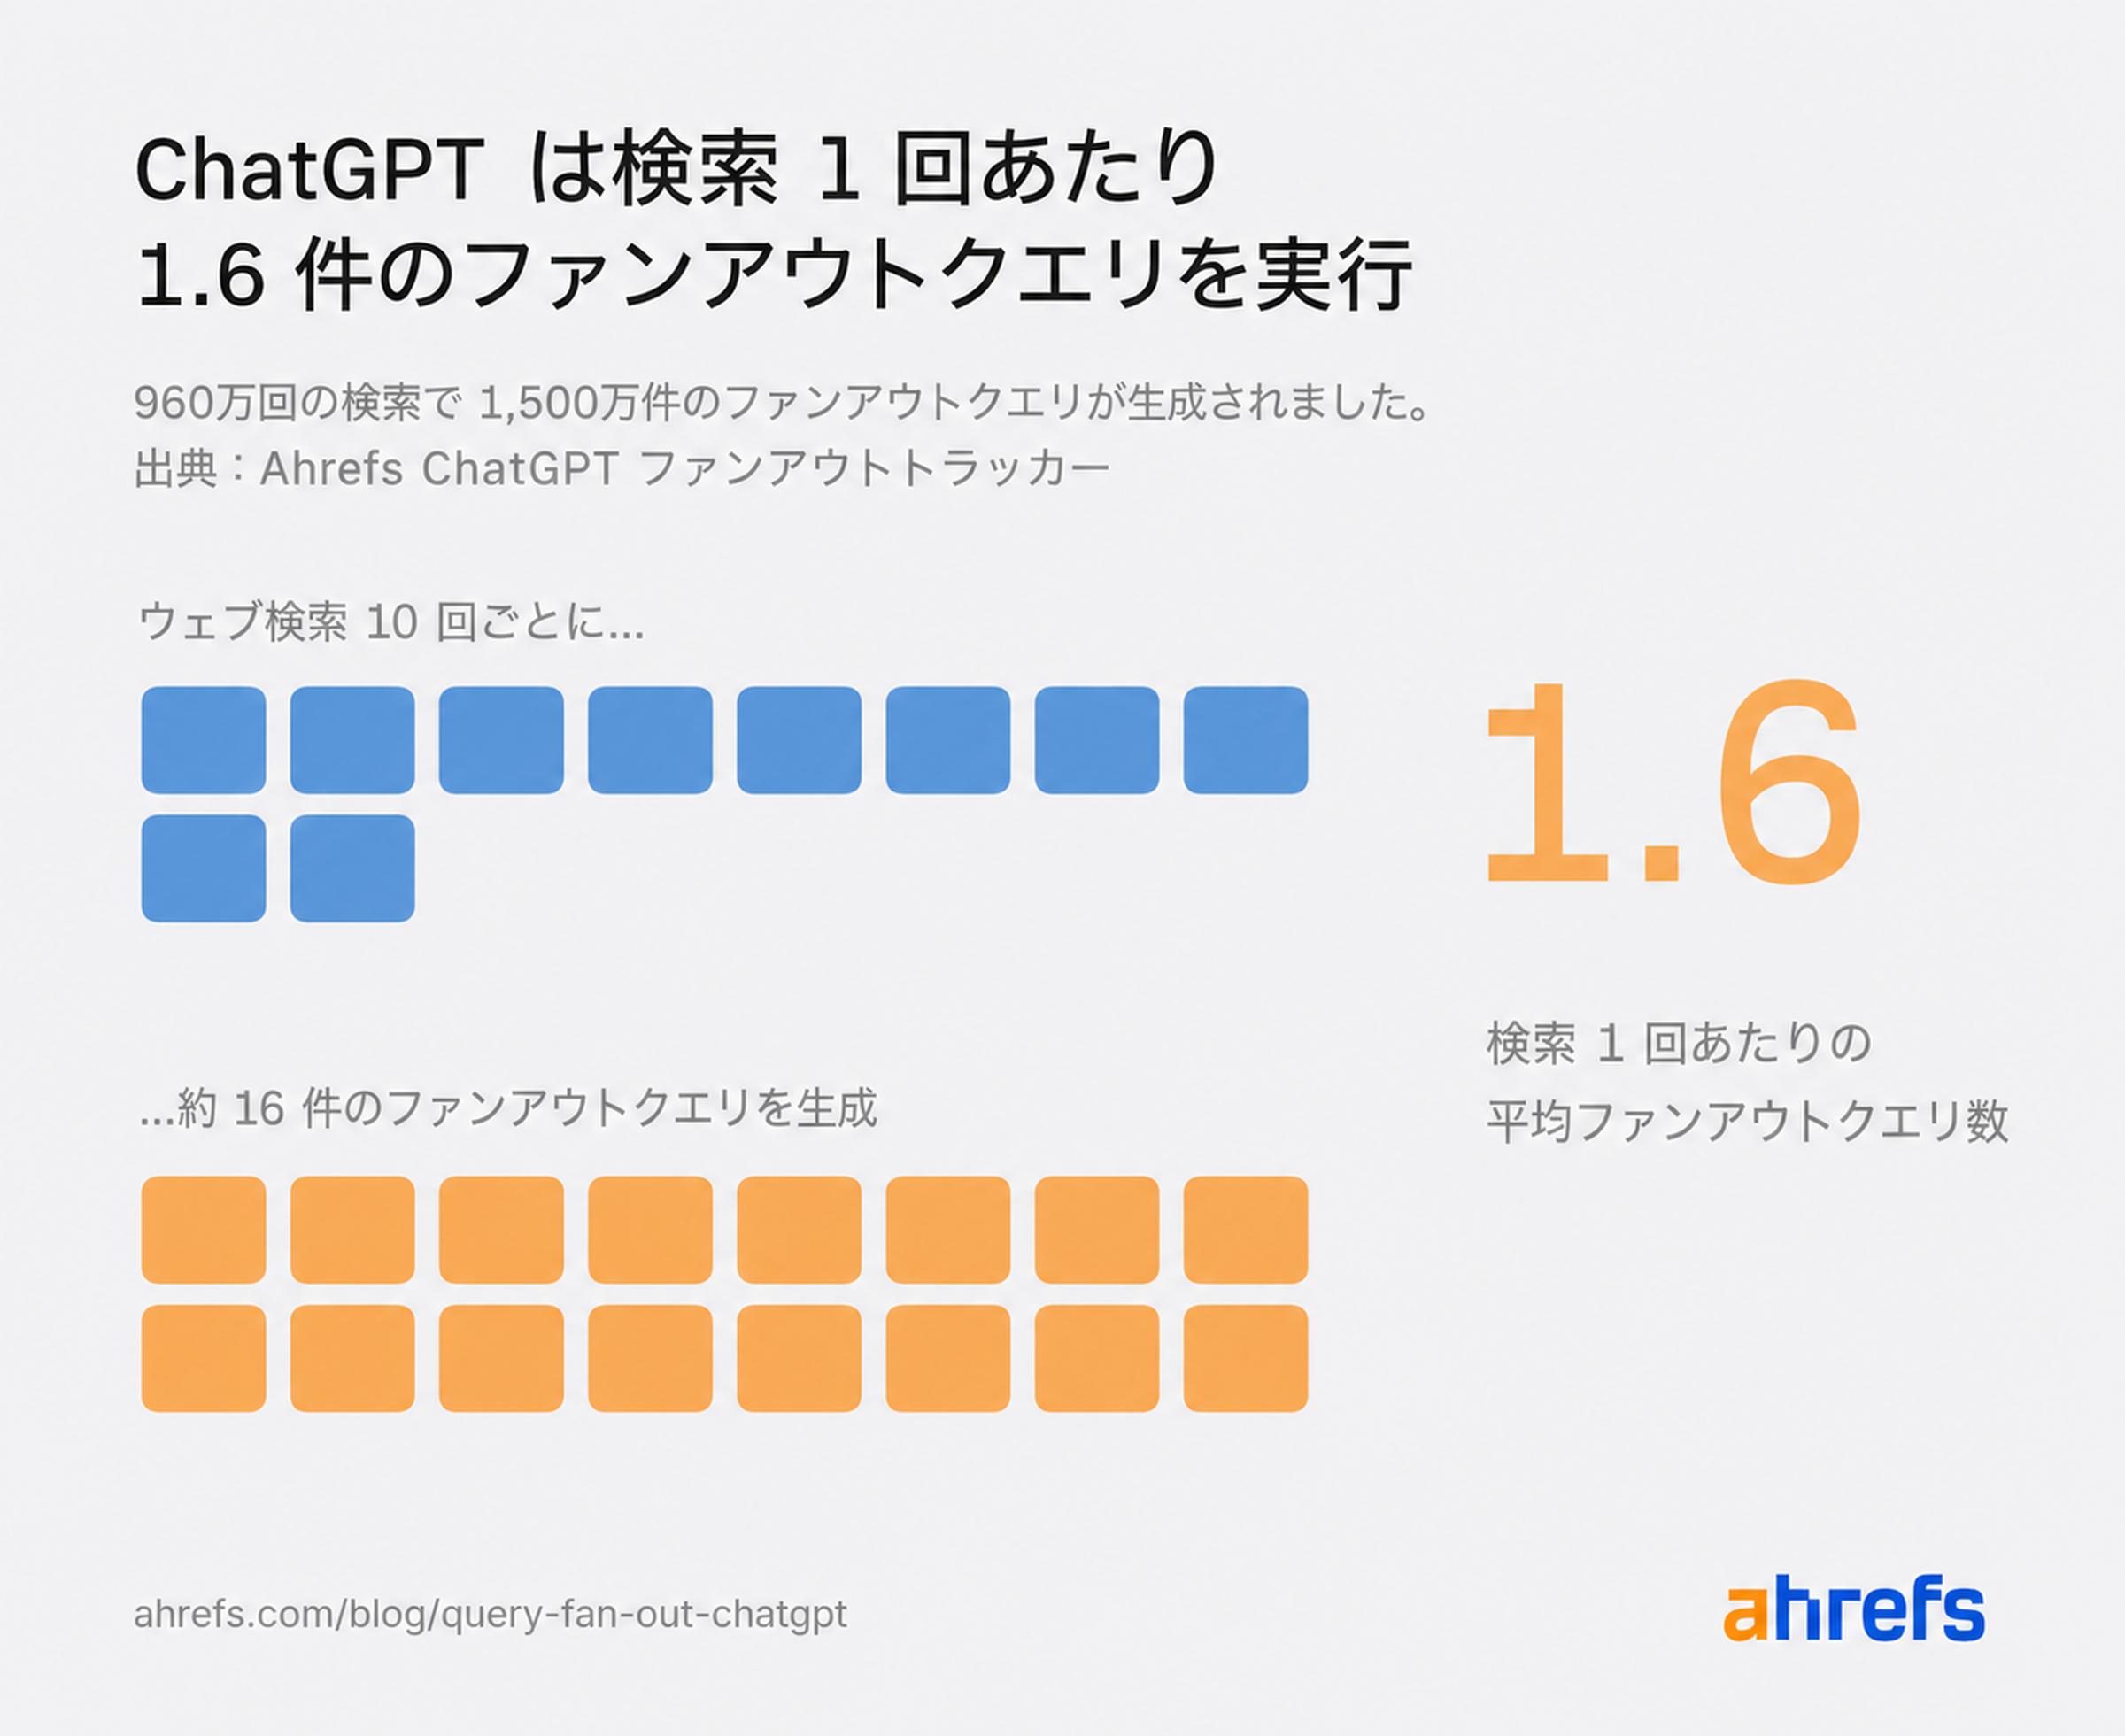
- ウェブ検索が実行された場合、ChatGPT は平均約 1.6 回のファンアウトクエリを発行していました。
- ファンアウトクエリの 6.8%(14.4% のうちの 6.8%)が
site:検索演算子を使用し、約 11.6 万の異なるドメインに対して検索を行っていました。 - 最も多く使われた
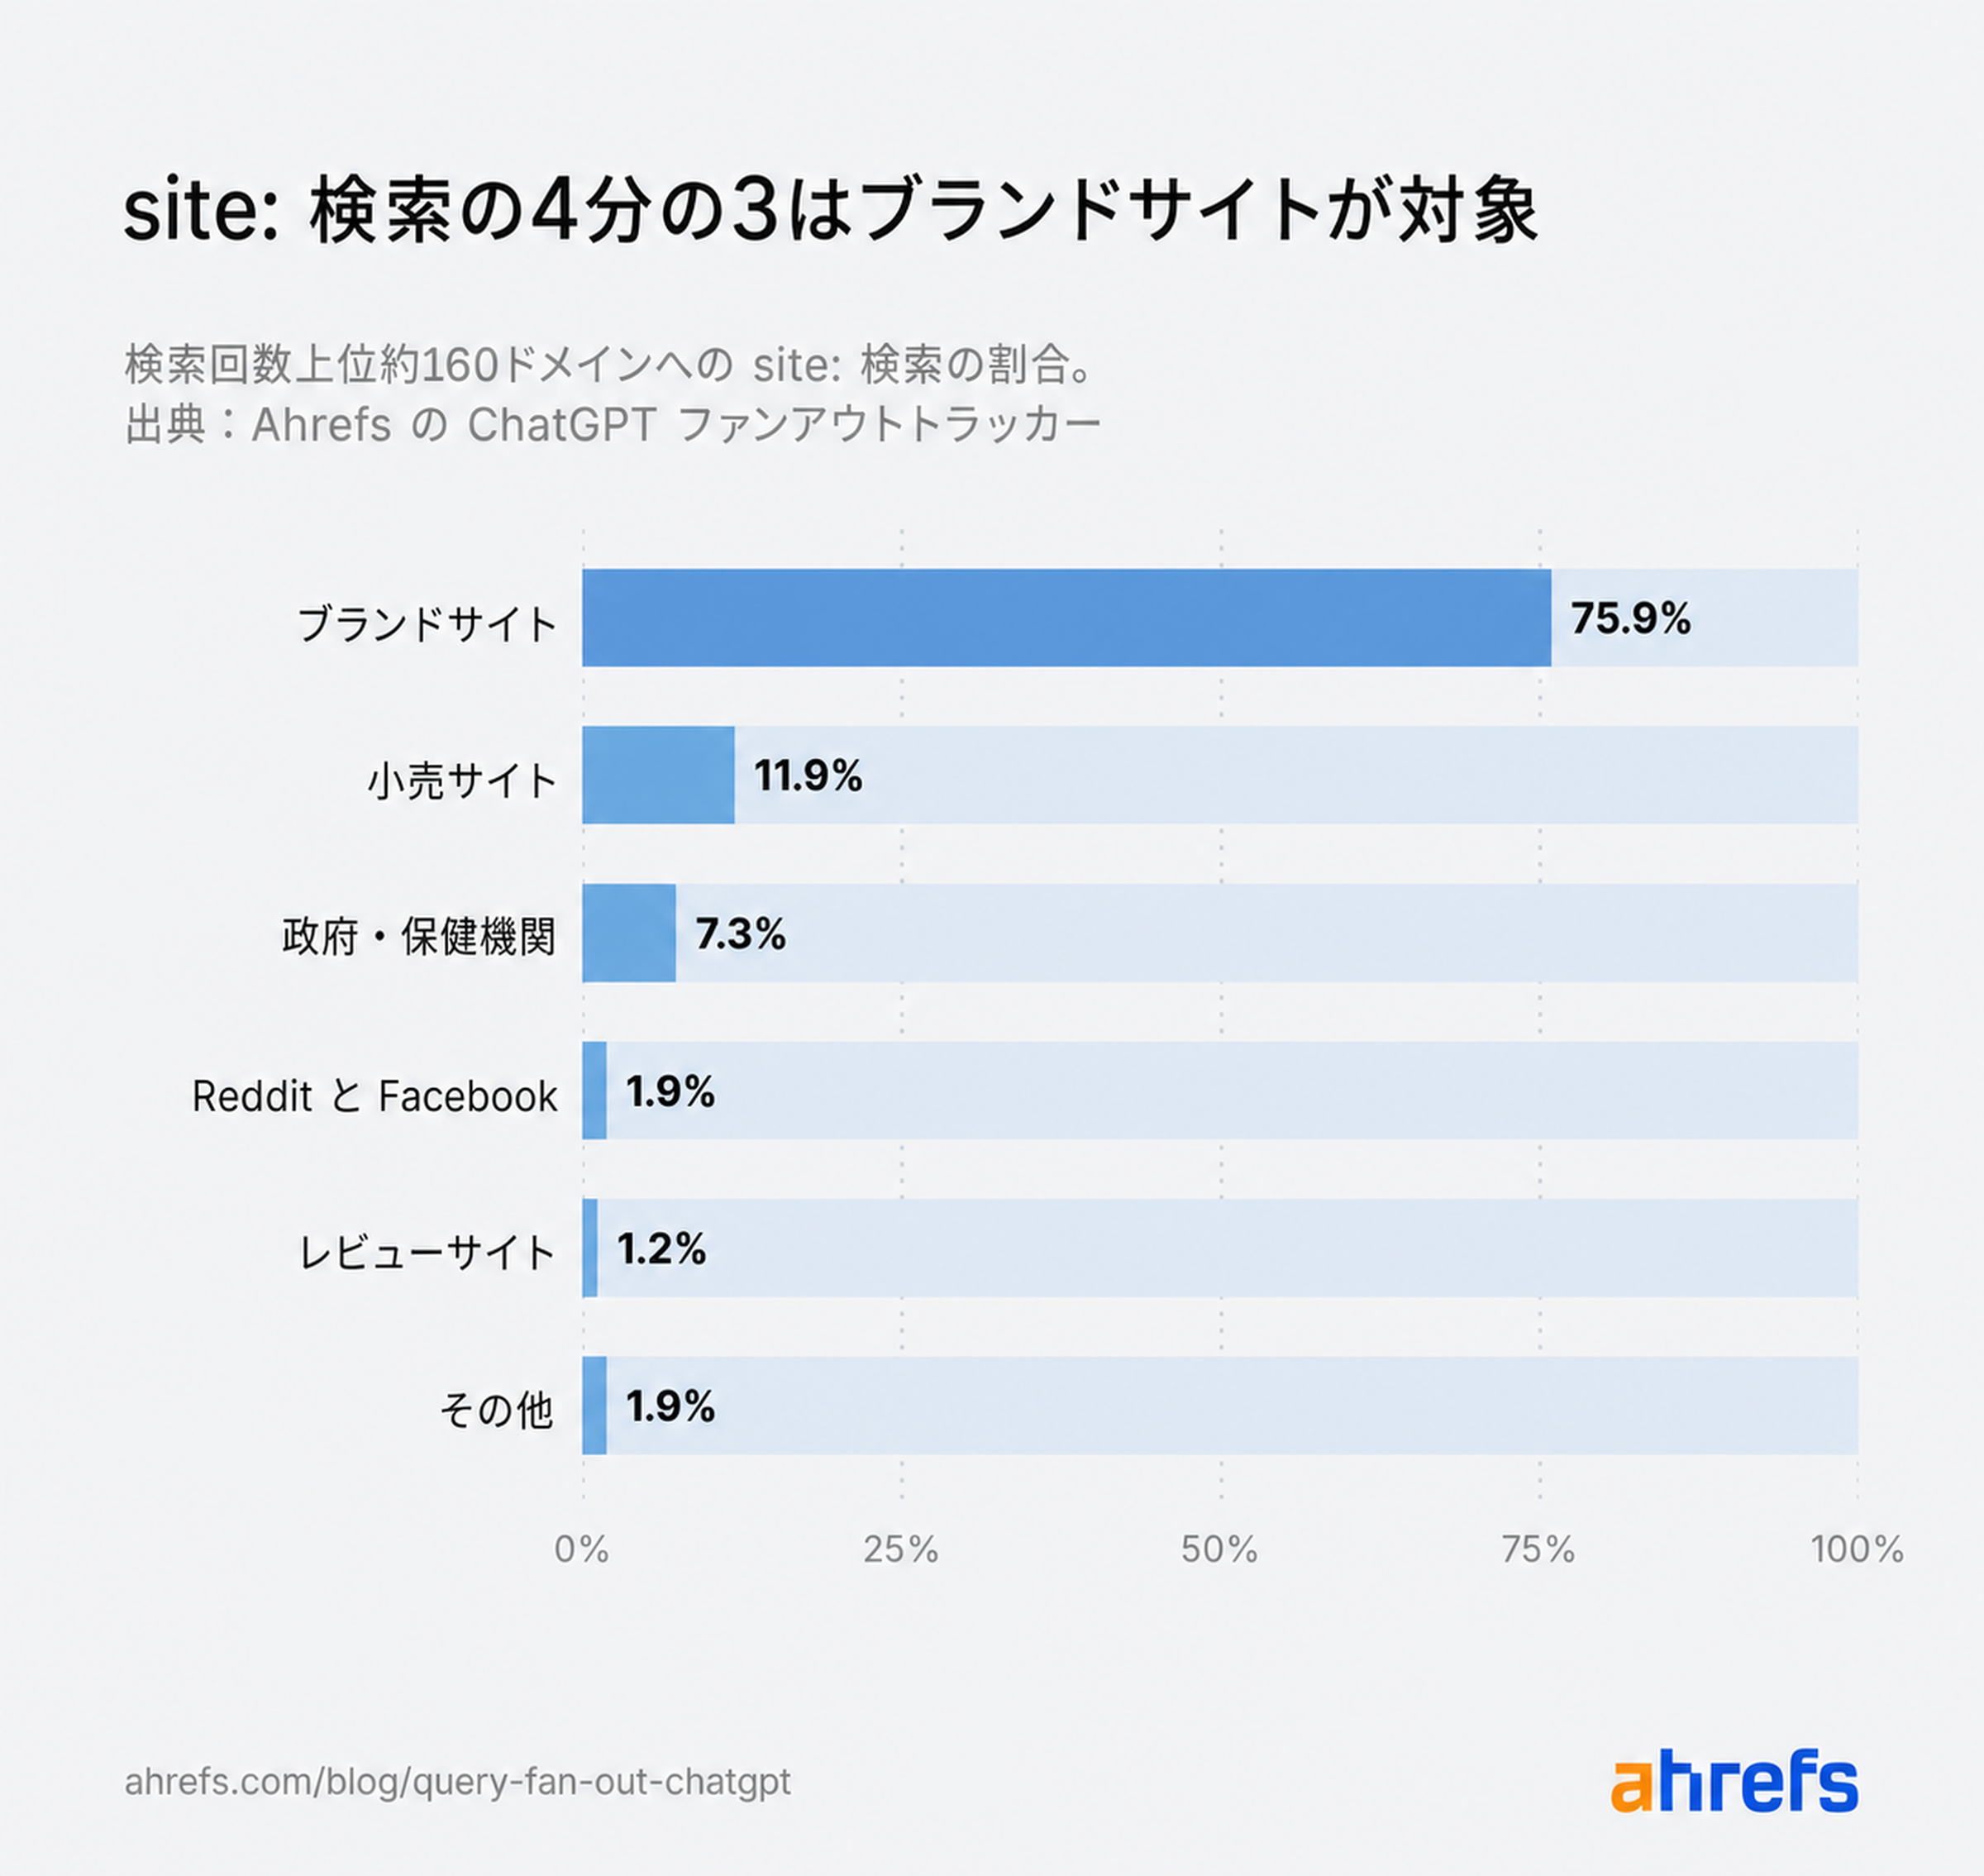
site:検索のうち 75.9% がブランドサイトを対象としており、小売サイト、政府系サイト、フォーラム、レビューサイトを大きく上回っていました。 - 9 月の英語のファンアウトクエリでは、「official」という単語が 13.1% に出現しており、8 月の 10.1% から増加しました。
- 「price」と「review」を含むファンアウトクエリは、1 か月で最大 47% 増加しました。
- 別の引用データでは、ChatGPT の Reddit 引用数が 6 か月間で 88% 減少しました。
- ChatGPT は、情報をまとめるサイトから情報を生み出す一次ソースへと重心を移しつつあるようです。
ChatGPT は 7 回中 6 回、Web 検索なしで回答している
Ahrefs チームが追跡した 6,660 万件の ChatGPT レスポンスのうち、ウェブ検索がトリガーされたのはわずか 14.4% でした。
ウェブ検索が実行された場合、1 レスポンスあたり平均約 1.6 回のファンアウトクエリが発行されていました。
ウェブ検索の実行には OpenAI 側のコストがかかるため、学習済みデータだけで十分回答できる場合はスキップするのが合理的です。
この傾向は WordLift の調査とも一致しています。同調査では、無料ティアのモデルはコスト削減のためにトレーニングデータへの依存度が高い可能性があると指摘されています。
つまり多くのプロンプトにおいて、ChatGPT の応答に表示されるかどうかは、ChatGPT が検索で何を見つけるかよりも、すでにそのブランドについて何を「知っている」かに左右されるということです。
ChatGPT の site: 検索の 76% はブランドサイトを対象としている
分析対象の 1,500 万件のファンアウトクエリのうち、6.8% が site: 演算子を使って特定のサイトを検索していました。
検索頻度の高い上位約 160 サイトを見ると、その 4 分の 3 がブランドサイトを対象としていました。
補足
ここでいう「ブランドサイト」とは、apple.com や ikea.com のような企業の公式サイトを指し、小売サイト、政府系サイト、フォーラム、レビューサイトとは区別しています。
リテールサイト(ウォルマート、コストコ、アマゾンなど)は 11.9%、Reddit と Facebook は合わせてわずか 1.9% でした。
ファンアウトクエリに含まれる単語を見ても、公式かつ一次情報への重点が読み取れます。「official」と「price」は「2026」に次いで最も多く出現し、月ごとに数ポイントずつ増加しています。
# | 単語 | 8 月 | 9 月 | 変化 |
|---|---|---|---|---|
1 | 2026 | 17.6% | 22.9% | +5.2 pts |
2 | official | 10.1% | 13.1% | +3.0 pts |
3 | price | 6.0% | 8.9% | +2.8 pts |
4 | india | 3.0% | 6.2% | +3.2 pts |
5 | best | 5.0% | 5.3% | +0.3 pts |
6 | site | 4.0% | 4.8% | +0.8 pts |
7 | australia | 1.4% | 4.3% | +2.9 pts |
8 | how | 3.3% | 3.6% | +0.2 pts |
9 | reviews | 2.7% | 3.6% | +0.9 pts |
10 | philippines | <0.8% | 3.2% | トップ 50 に新規参入 |
11 | what | 2.3% | 3.0% | +0.7 pts |
12 | company | 2.2% | 2.5% | +0.2 pts |
13 | meaning | 2.9% | 2.3% | −0.6 pts |
14 | review | 2.2% | 2.3% | +0.1 pts |
15 | september* | 1.4% | 2.1% | +0.7 pts |
16 | new | 1.4% | 2.1% | +0.7 pts |
17 | cost | 2.2% | 2.0% | −0.2 pts |
18 | ingredients | 1.6% | 1.9% | +0.4 pts |
19 | brand | 1.8% | 1.9% | +0.1 pts |
20 | owner | 1.5% | 1.8% | +0.3 pts |
この結果は驚くべきことではありません。製品の価格や仕様を知りたい場合、ブランドの公式サイトが最も自然な情報源です。
一方、唯一の正解がない質問に対しては、ChatGPT は公式ソース以外にも目を向ける傾向があります。
たとえば、別途実施した 2 万件の米国プロンプトを対象としたテストでは、価格・製品特徴・会社情報に関する事実確認型の質問の 84.4% が、少なくとも 1 つの公式ソースを引用していました。
一方、「A と B の比較」や「どちらが安いか」といった比較型の質問では、この割合が 68.3% に低下しました。
引用元の構成にも違いが見られます。
事実確認型の質問では、引用の 63.4% が公式サイトを参照していました。
比較型の質問では 46.4% にとどまり、引用の過半数は公式サイト以外のソースでした。
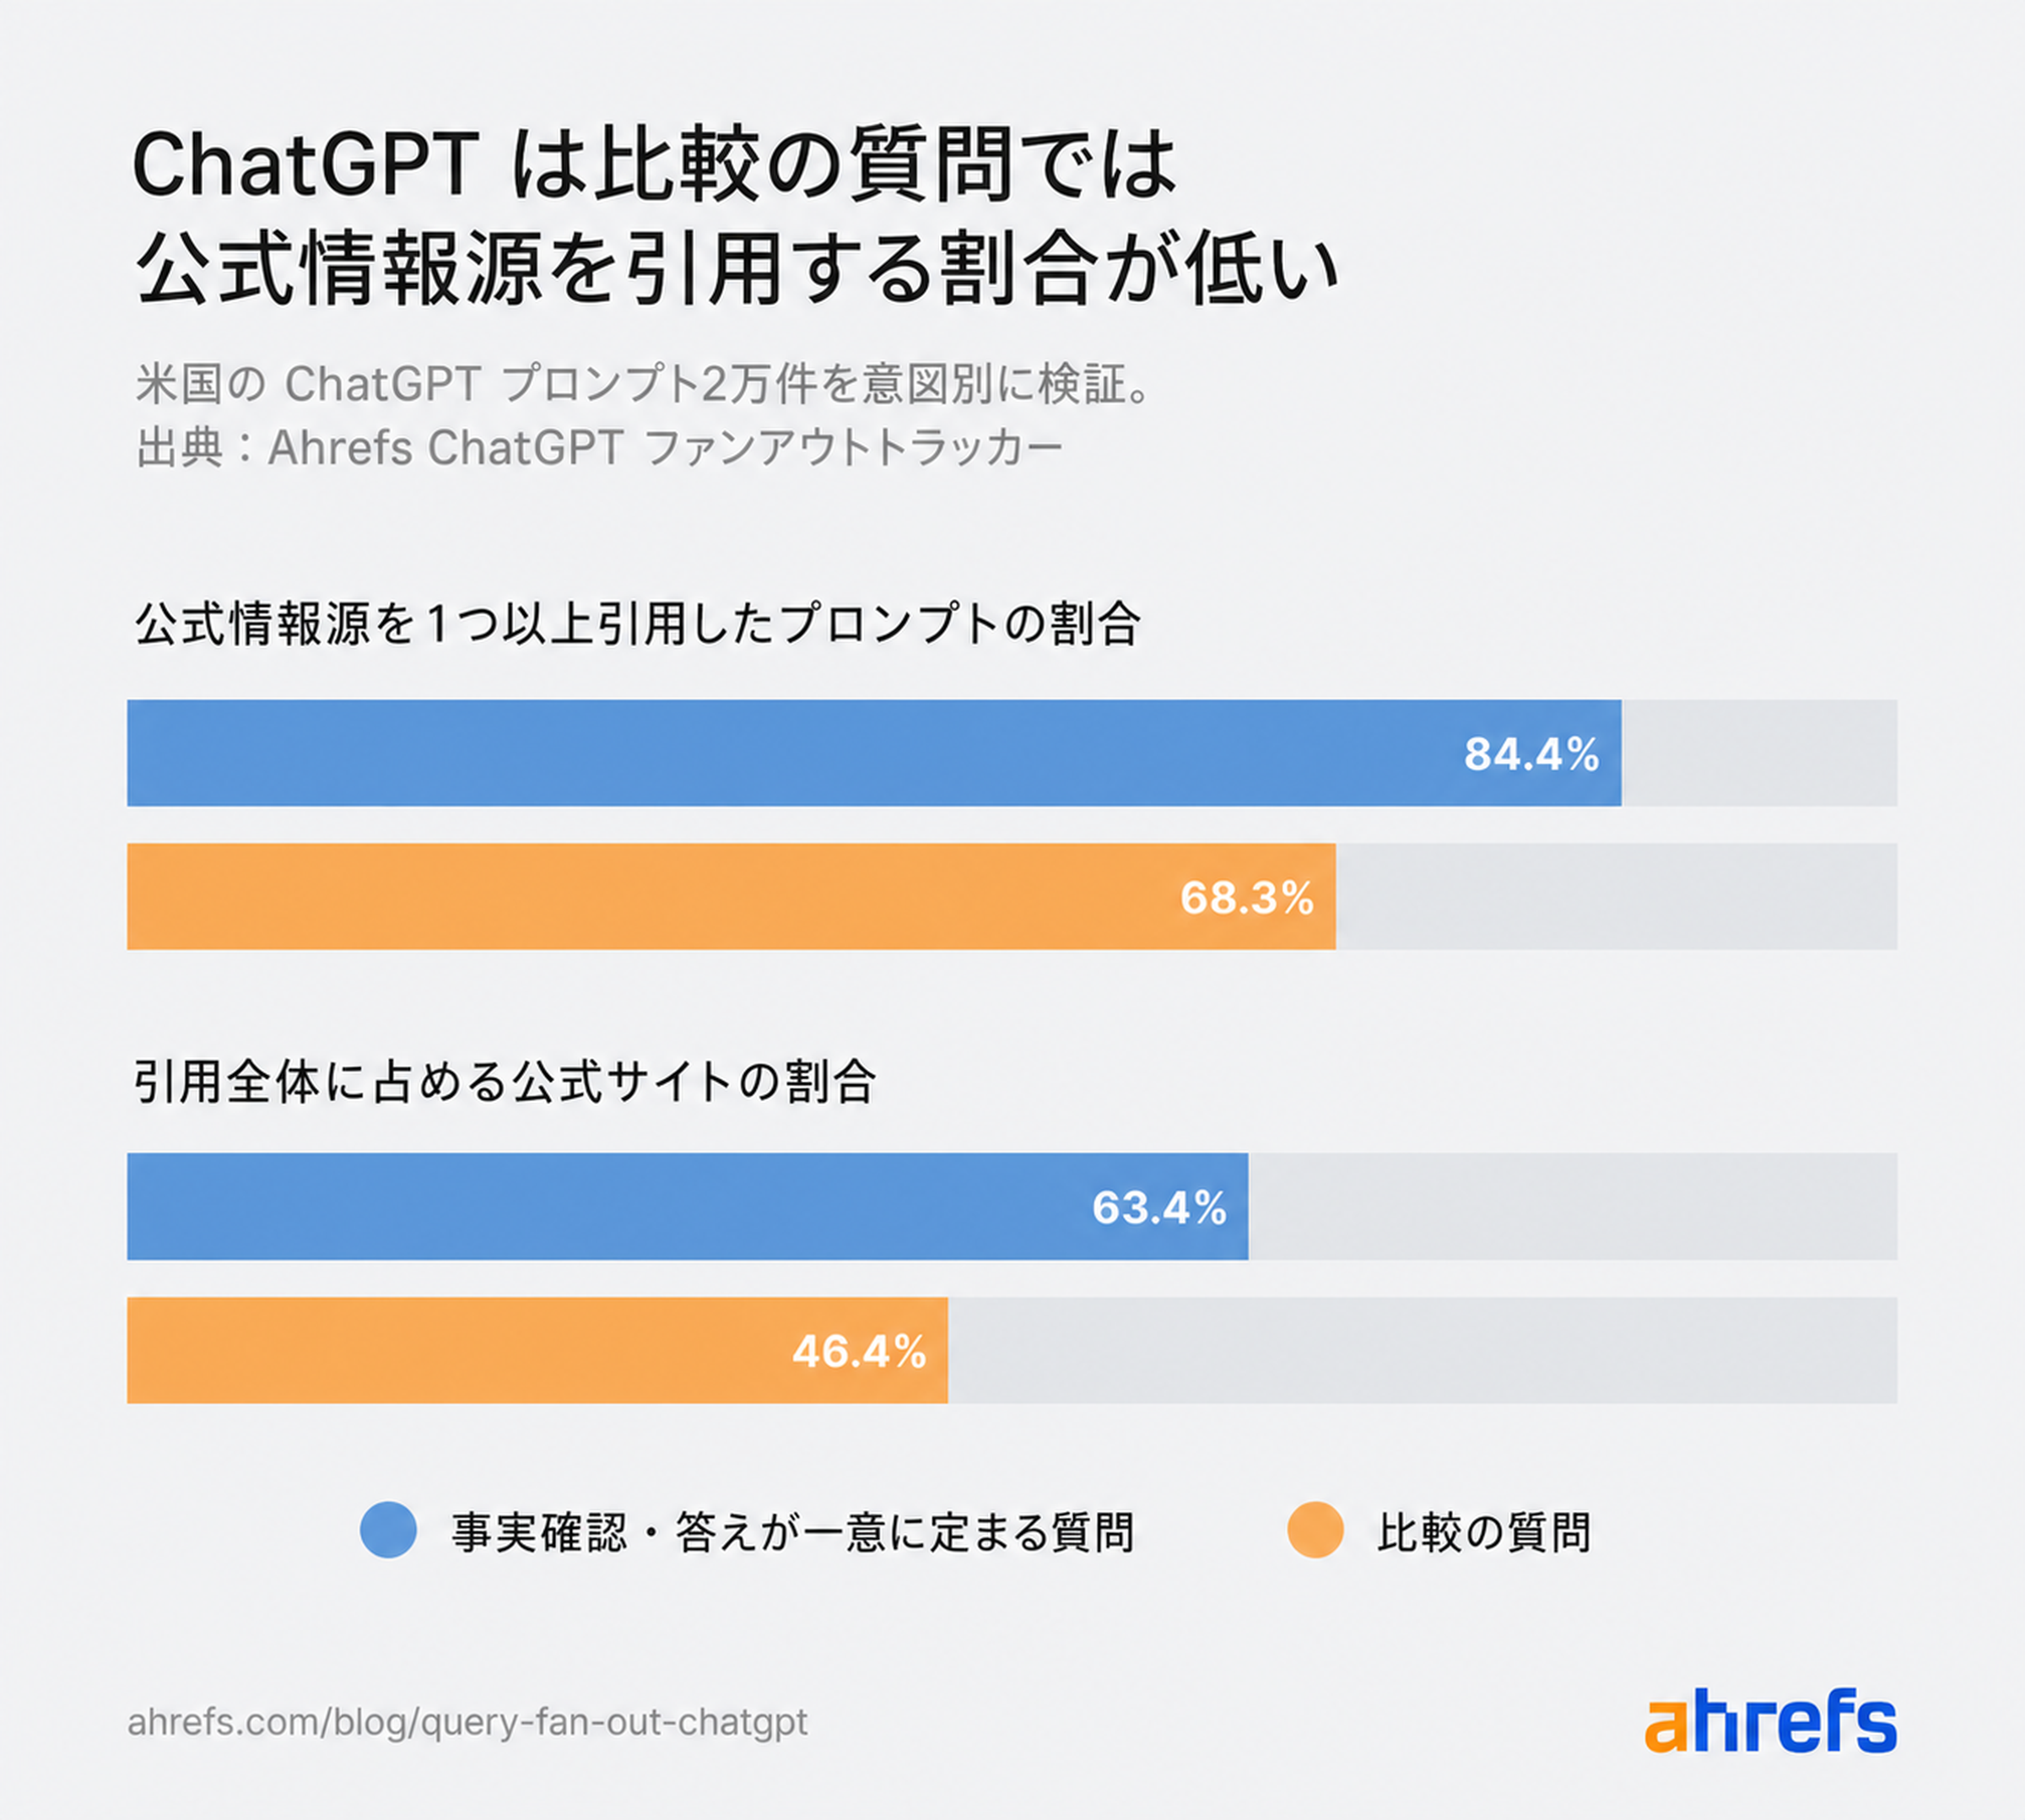
つまり ChatGPT は、事実の確認には公式ソースを最も頼りにし、選択肢を比較検討する場面ではより多様なサイトを参照するということです。
ファンアウトクエリに使われる言語パターンについては、後のセクションで詳しく掘り下げます。
[recommendation title="ブランドサイトで事実に関する質問に回答できるようにする"]
ChatGPT が site:自社ドメイン.com で価格、スペック、サポート情報を検索してくる可能性があるため、これらの情報をサイト上にプレーンテキストで掲載し、クロール可能なページに配置しておくことが重要です。
消費者向けブランドが ChatGPT の site: 検索トップ 10 中 8 つを占める
ChatGPT が site: 演算子で最も頻繁に検索するドメインは、大手消費者向けブランドのサイトです。
以下のランキングは今回のデータセットとプロンプトに基づくものですが、約 100 万件の site: クエリを基盤としているため、ChatGPT がどのドメインに最も依存しているかを把握する上で十分な信頼性があります。
上位にランクインしているのは主に製品を販売するブランドであり、価格やスペックなどの詳細情報を取得する先としてブランドサイトが自然な情報源となっています。
# | ドメイン | `site:` 検索数 |
|---|---|---|
1 | apple.com | 9,442 |
2 | ikea.com | 7,361 |
3 | nike.com | 5,210 |
4 | adidas.com | 4,619 |
5 | samsung.com | 4,432 |
6 | mi.com | 3,303 |
7 | lego.com | 3,106 |
8 | dior.com | 2,662 |
9 | reddit.com | 2,586 |
10 | gov.br | 2,583 |
11 | playstation.com | 2,304 |
12 | gov.uk | 2,116 |
13 | walmart.com | 2,096 |
14 | support.apple.com | 2,005 |
15 | costco.com | 1,942 |
政府系ドメインも目立った存在感を示しています。
gov.br、gov.uk、フランスの service-public.fr、NHTSA(米国道路交通安全局)、FDA(米国食品医薬品局)、SEC(米国証券取引委員会)がいずれもトップ 150 内に入っています。この傾向は、Algorythmic の創業者であるリリー・レイ氏の分析と一致しており、ChatGPT は YMYL(健康・お金に関わる重要領域)の質問に対して公式ソースを優先する傾向にあります。
また、Reddit が依然として site: 検索の 9 位に位置していることにも注目すべきです。
これは Snippet Digital 共同創業者のスガンサン・モハナダサン氏の調査結果とも合致しています。同氏の分析によると、ChatGPT は引用頻度こそ低下しているものの(この点は後述します)、実際のユーザーの意見を取得したい場合には依然として Reddit を参照しています。
ChatGPT は OpenAI のパートナーを site: 検索することはまれだが、引用シェアは倍増
現在 OpenAI とライセンス契約を結んでいるパブリッシャーやプラットフォーム 17 社のうち、site: 検索頻度トップ 150 に入っているのは Reddit だけです。
考えられる理由の一つは、ChatGPT がパートナーのコンテンツをあらかじめ取り込み、すぐに利用できる状態にしている可能性があることです。
- QueryBurst の創業者であるデイヴィッド・マクスウィーニー氏は、Time、Business Insider、Forbes など一部の高権威パブリケーションについて、事前に合成されたページレベルの要約が ChatGPT のコンテキストに直接取り込まれているようだと指摘しています。
- スガンサン・モハナダサン氏は、ChatGPT のトラフィックの中に「labrador」と呼ばれる別の取得ソースを発見しました。同氏はこれを「ライセンスティア」と説明し、このソースに含まれるパブリッシャーの多くが OpenAI とコンテンツ契約を締結していると指摘しています。
site: 検索のデータは、ChatGPT がファンアウトクエリ中に何を検索しているかを示すものであり、最終的に何を引用しているかとは異なります。
引用先ドメインを見ると、状況は大きく変わります。パートナーパブリケーションの存在感が際立っているのです。
ブランドレーダーのデータによると、ChatGPT の引用数トップ 200 ドメインに含まれるパートナーメディアの合計引用シェアは、3 月の 7.5% から 7 月には 15.8% へと倍増し、9 月下旬でも 12.5% を維持しています。
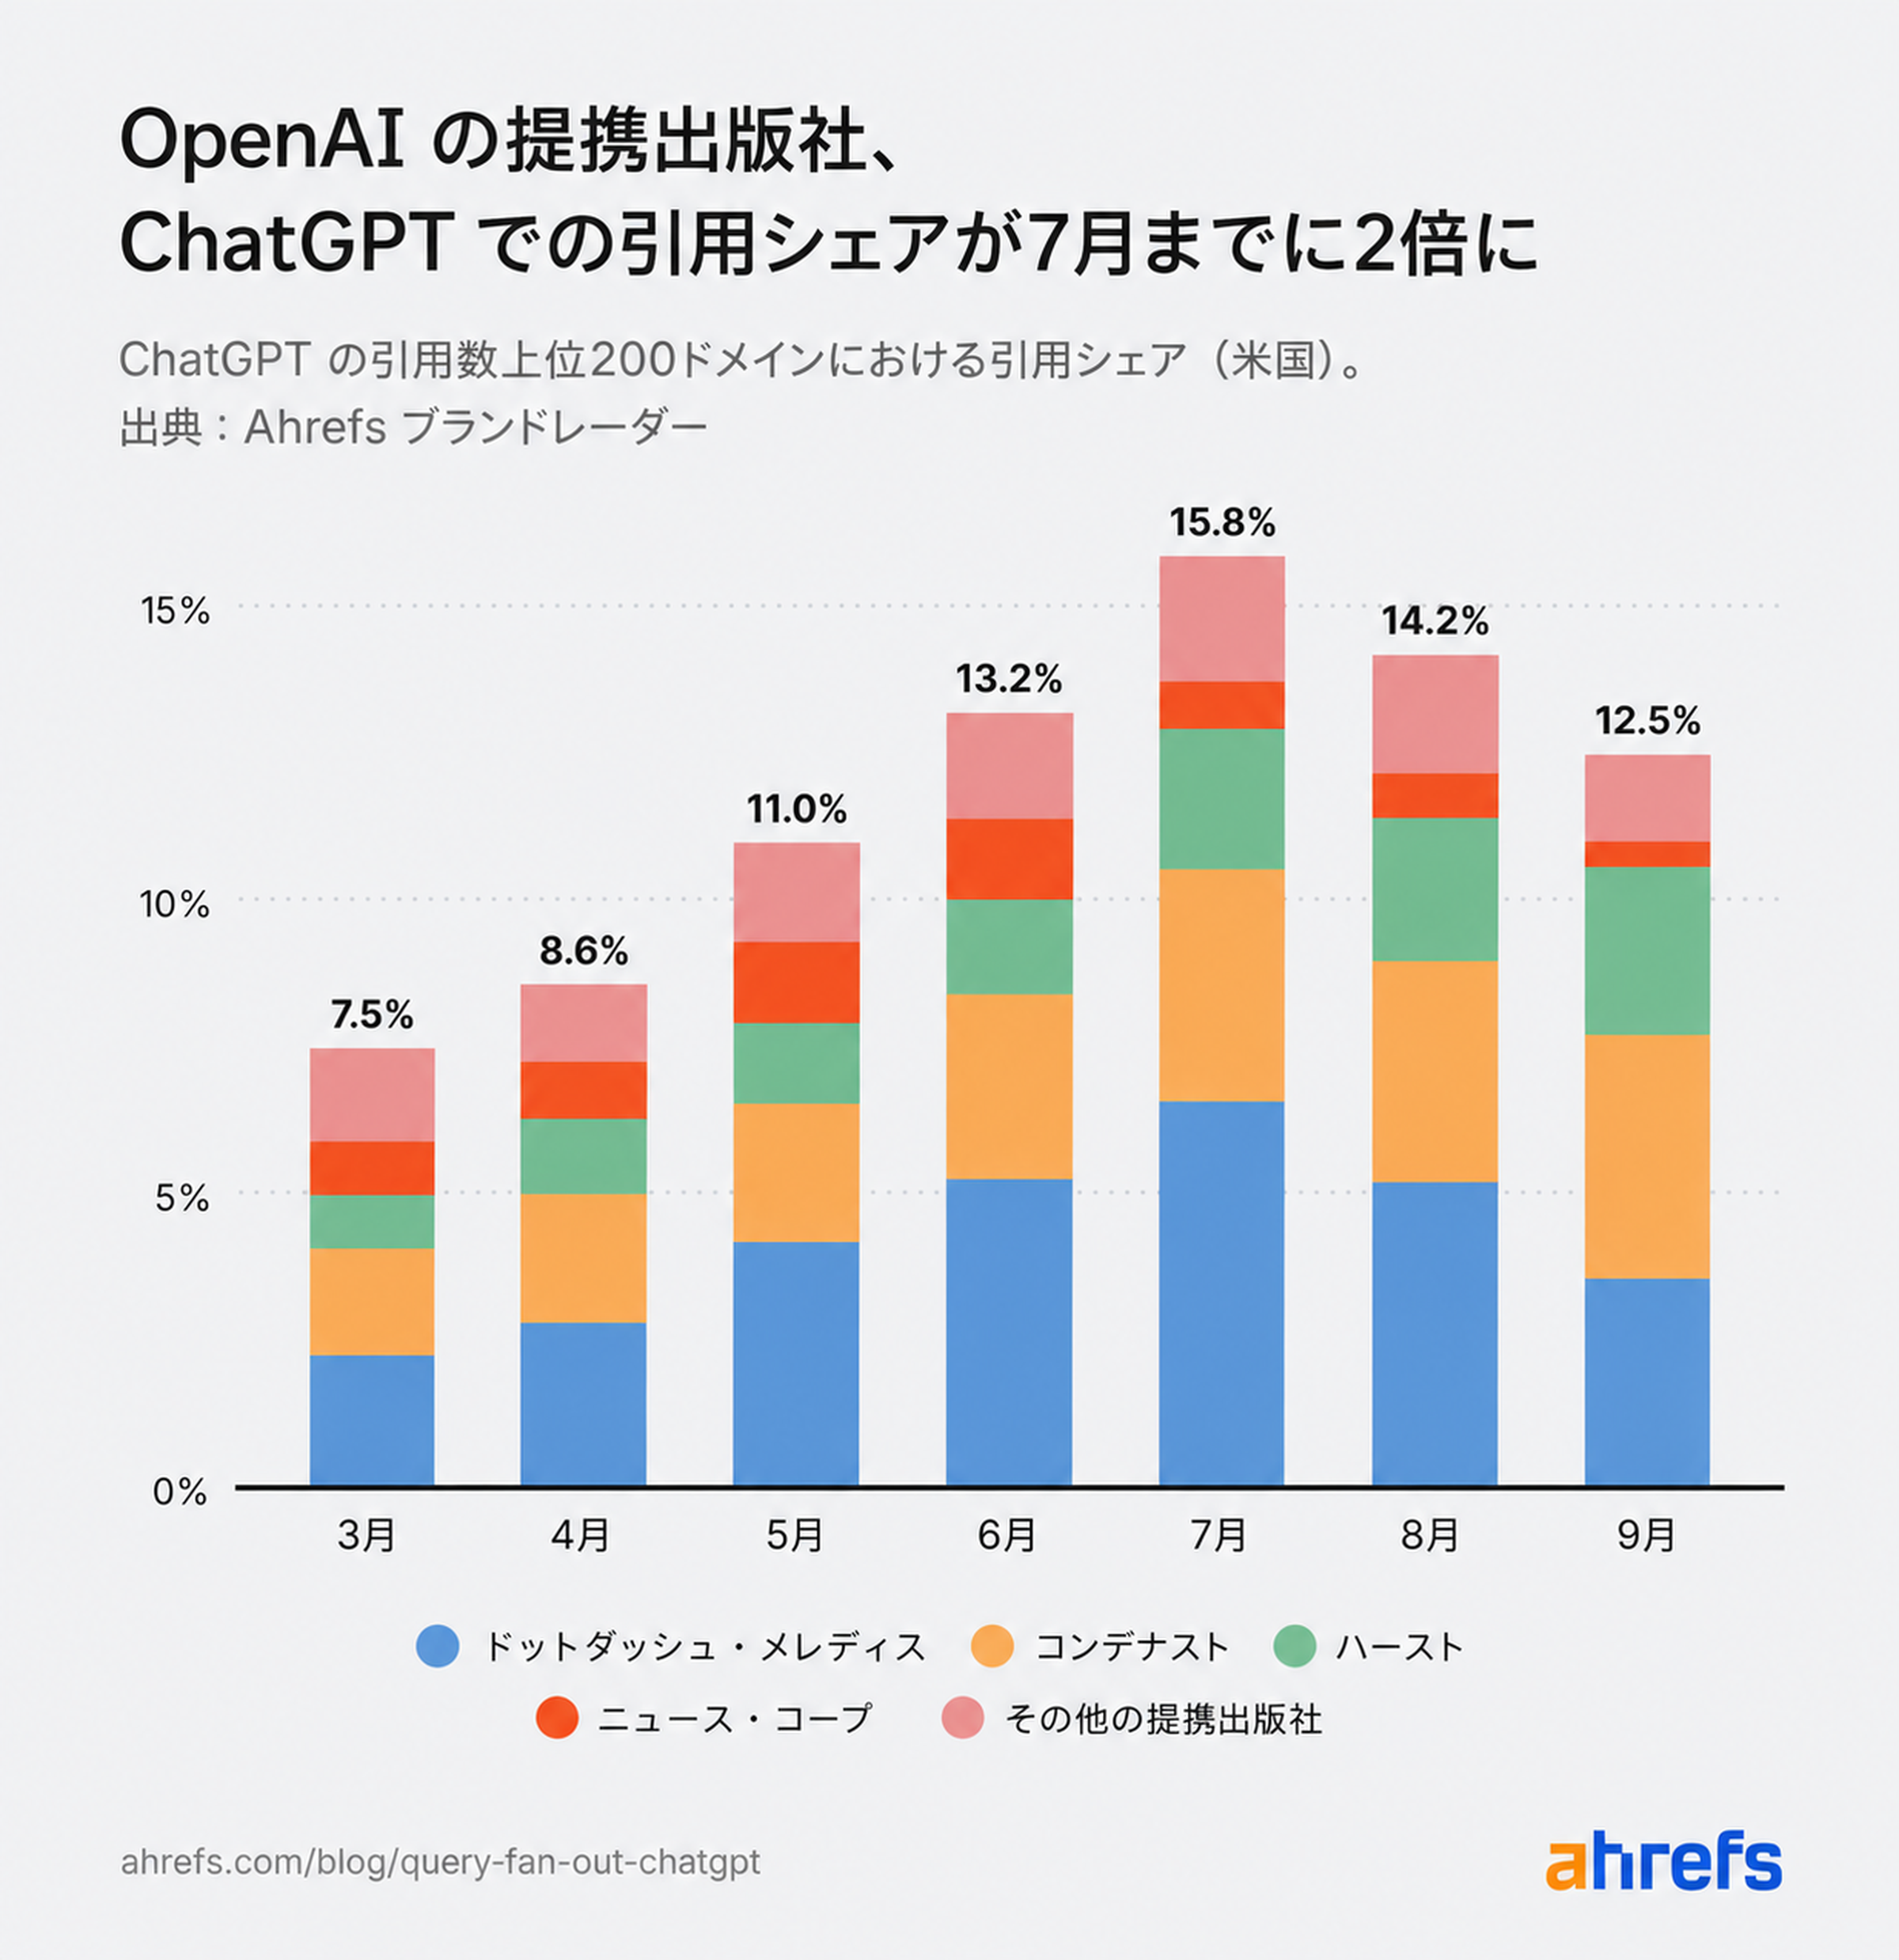
ChatGPT がこれらのパートナーメディアを引用する頻度は増加傾向にあるため、パートナーパブリケーションでブランドに関する記事を掲載してもらうことは、検討する価値があります。
「price」「review」を含むファンアウトクエリが 1 か月で最大 47% 増加
ChatGPT がファンアウトクエリに追加する単語は、取得しようとしているページの種類を示すヒントになります。
8 月から 9 月にかけて、ChatGPT のファンアウトクエリでは価格、製品仕様、レビューに関するクエリが増加し、定義に関するクエリはやや減少しました。
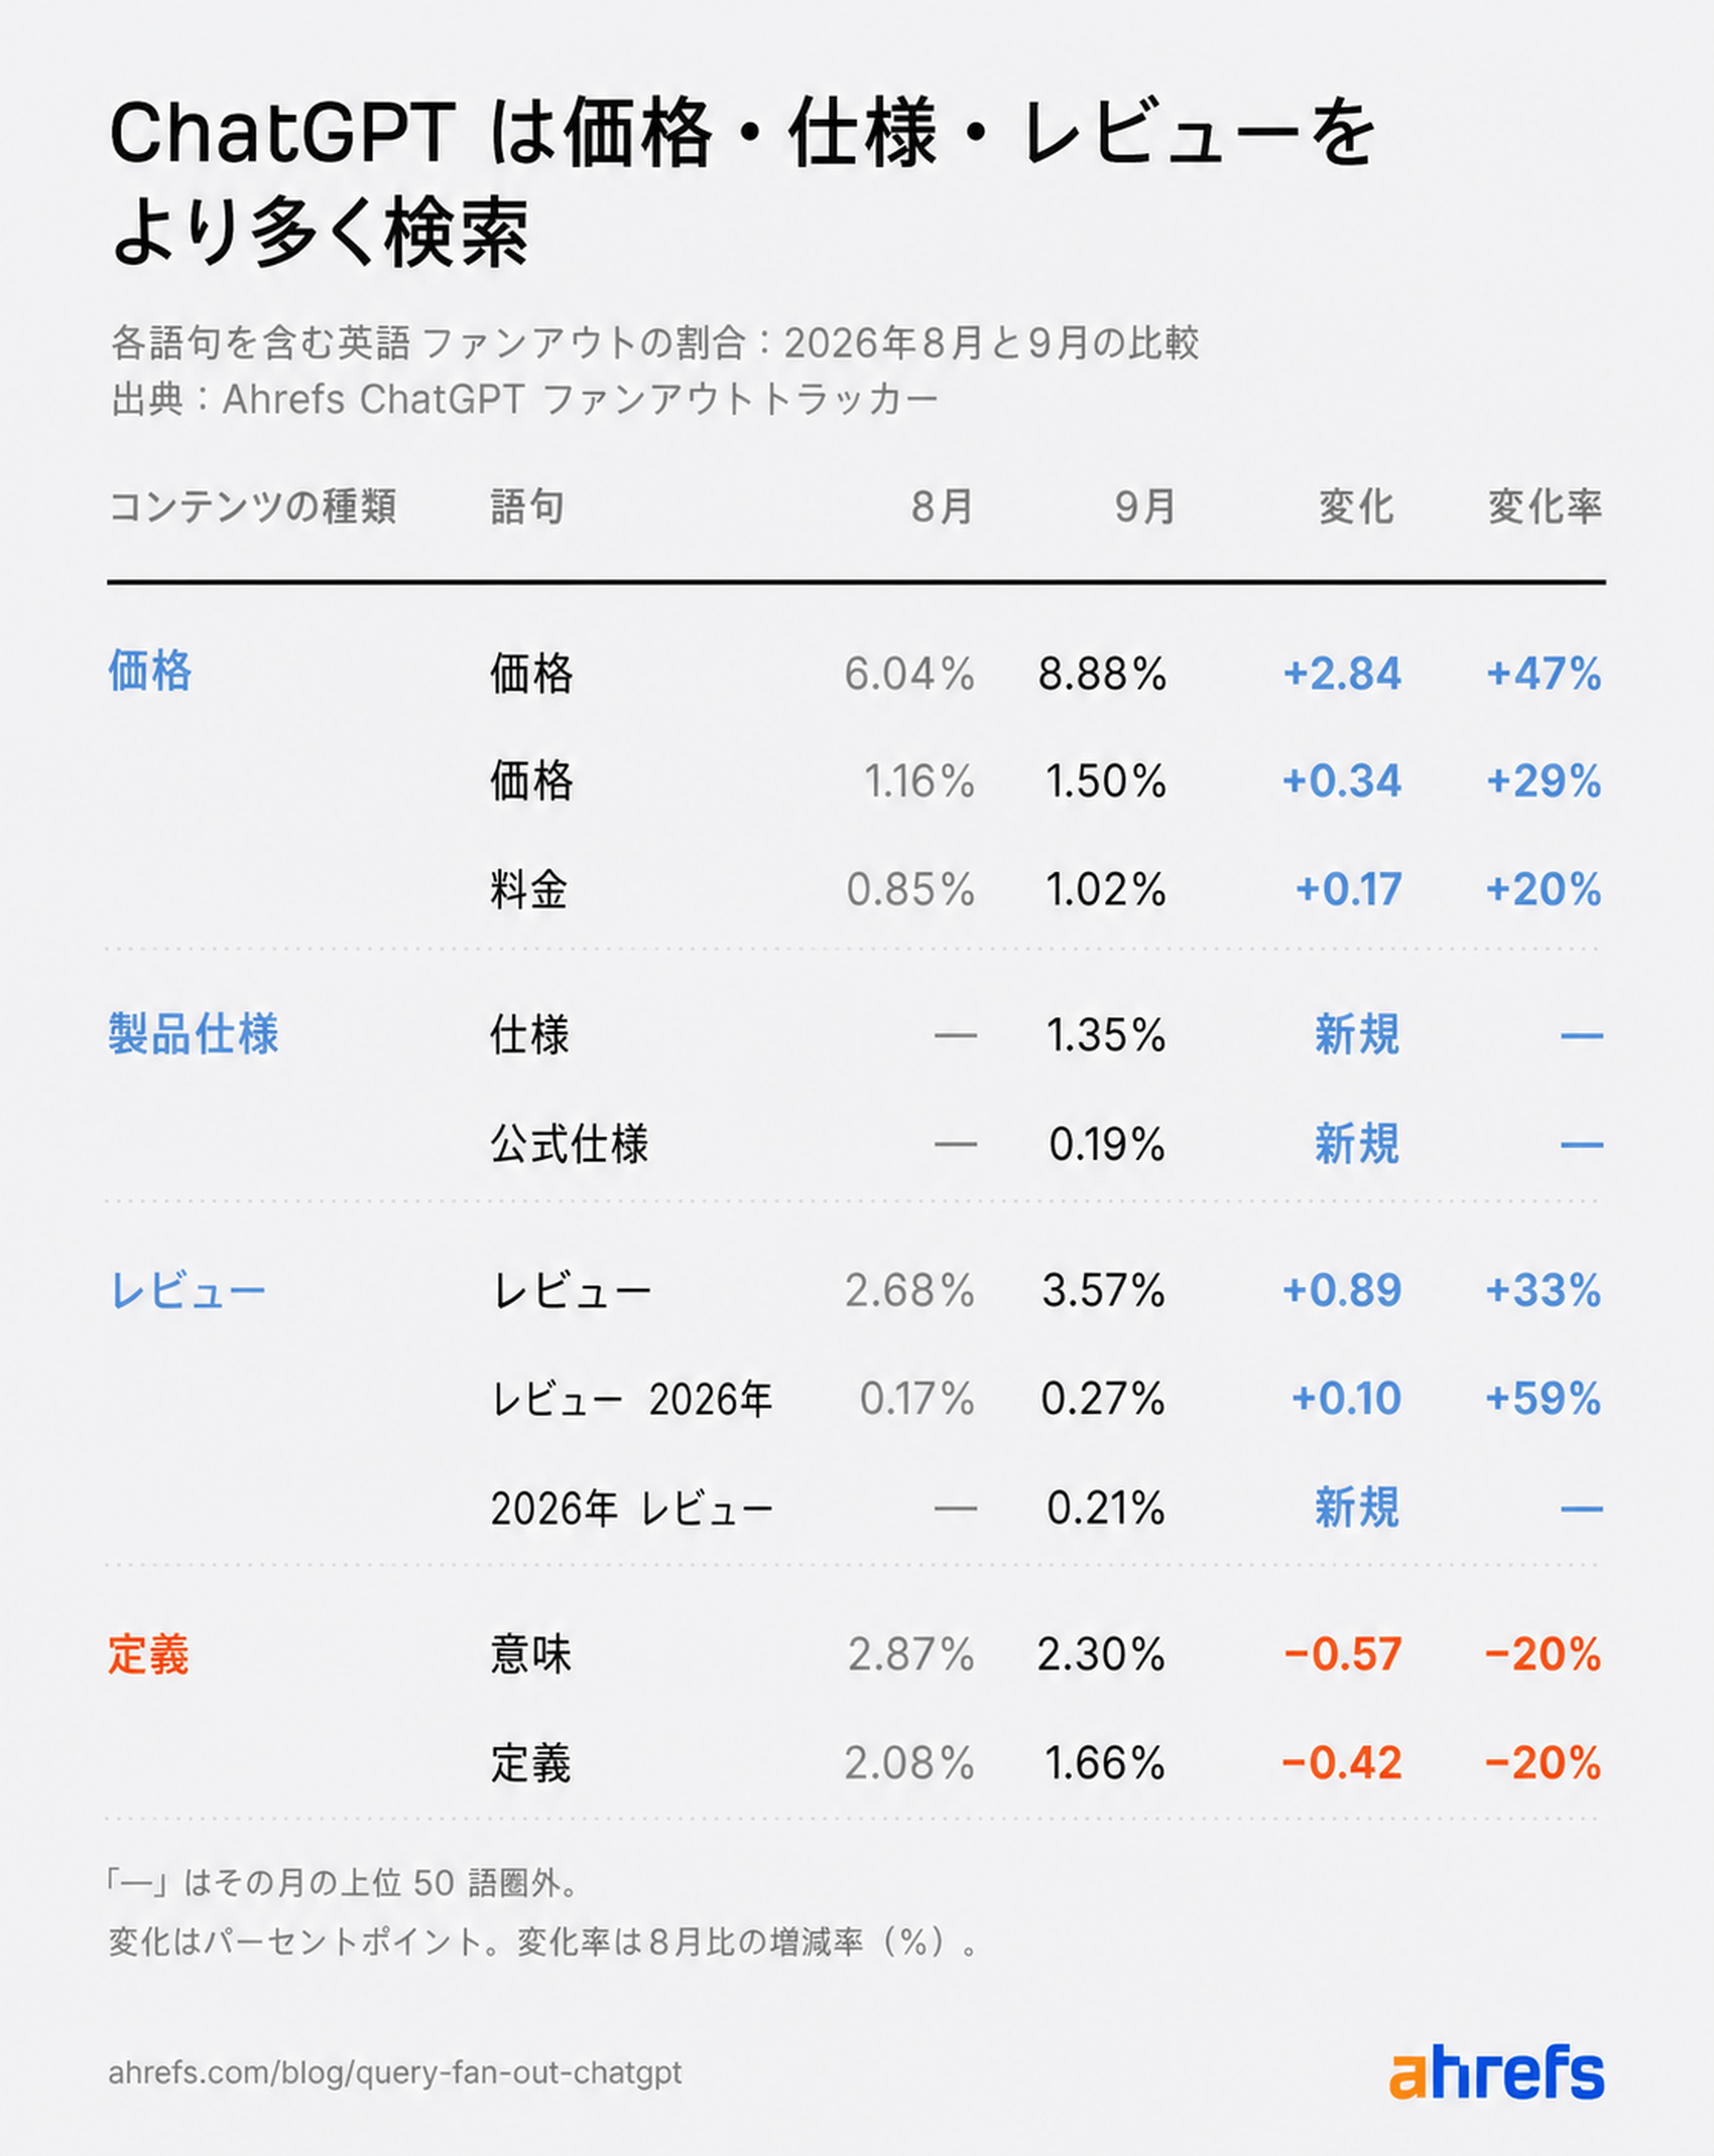
1〜2 ポイントの増加は小さく見えるかもしれません。しかし、これらの単語はいずれも低い出現率からスタートしているため、相対的な増加率で見ると急成長していることがわかります。
たとえば、「price」(費用)はファンアウトクエリ全体の 6.04% から 8.88% へと増加しました。相対的には約半分(47%)の上昇を、わずか 1 か月で記録したことになります。
さらに、「reviews」(レビュー)は約 3 分の 1 の増加を示し、「specifications」(仕様内容)は初めてトップ 50 に入りました。
一方で、「meaning」(意味)と「definition」(定義)はそれぞれ約 5 分の 1 減少しました。ただし、もともとのシェアが小さいため、トレンドというよりは一時的な変動と見るのが妥当です。
[recommendation title="成長中のクエリタイプに自社ページが対応しているか確認する"]
ブランドレーダーを使えば、自社の業界でどのファンアウトクエリタイプが多いかを評価できます。
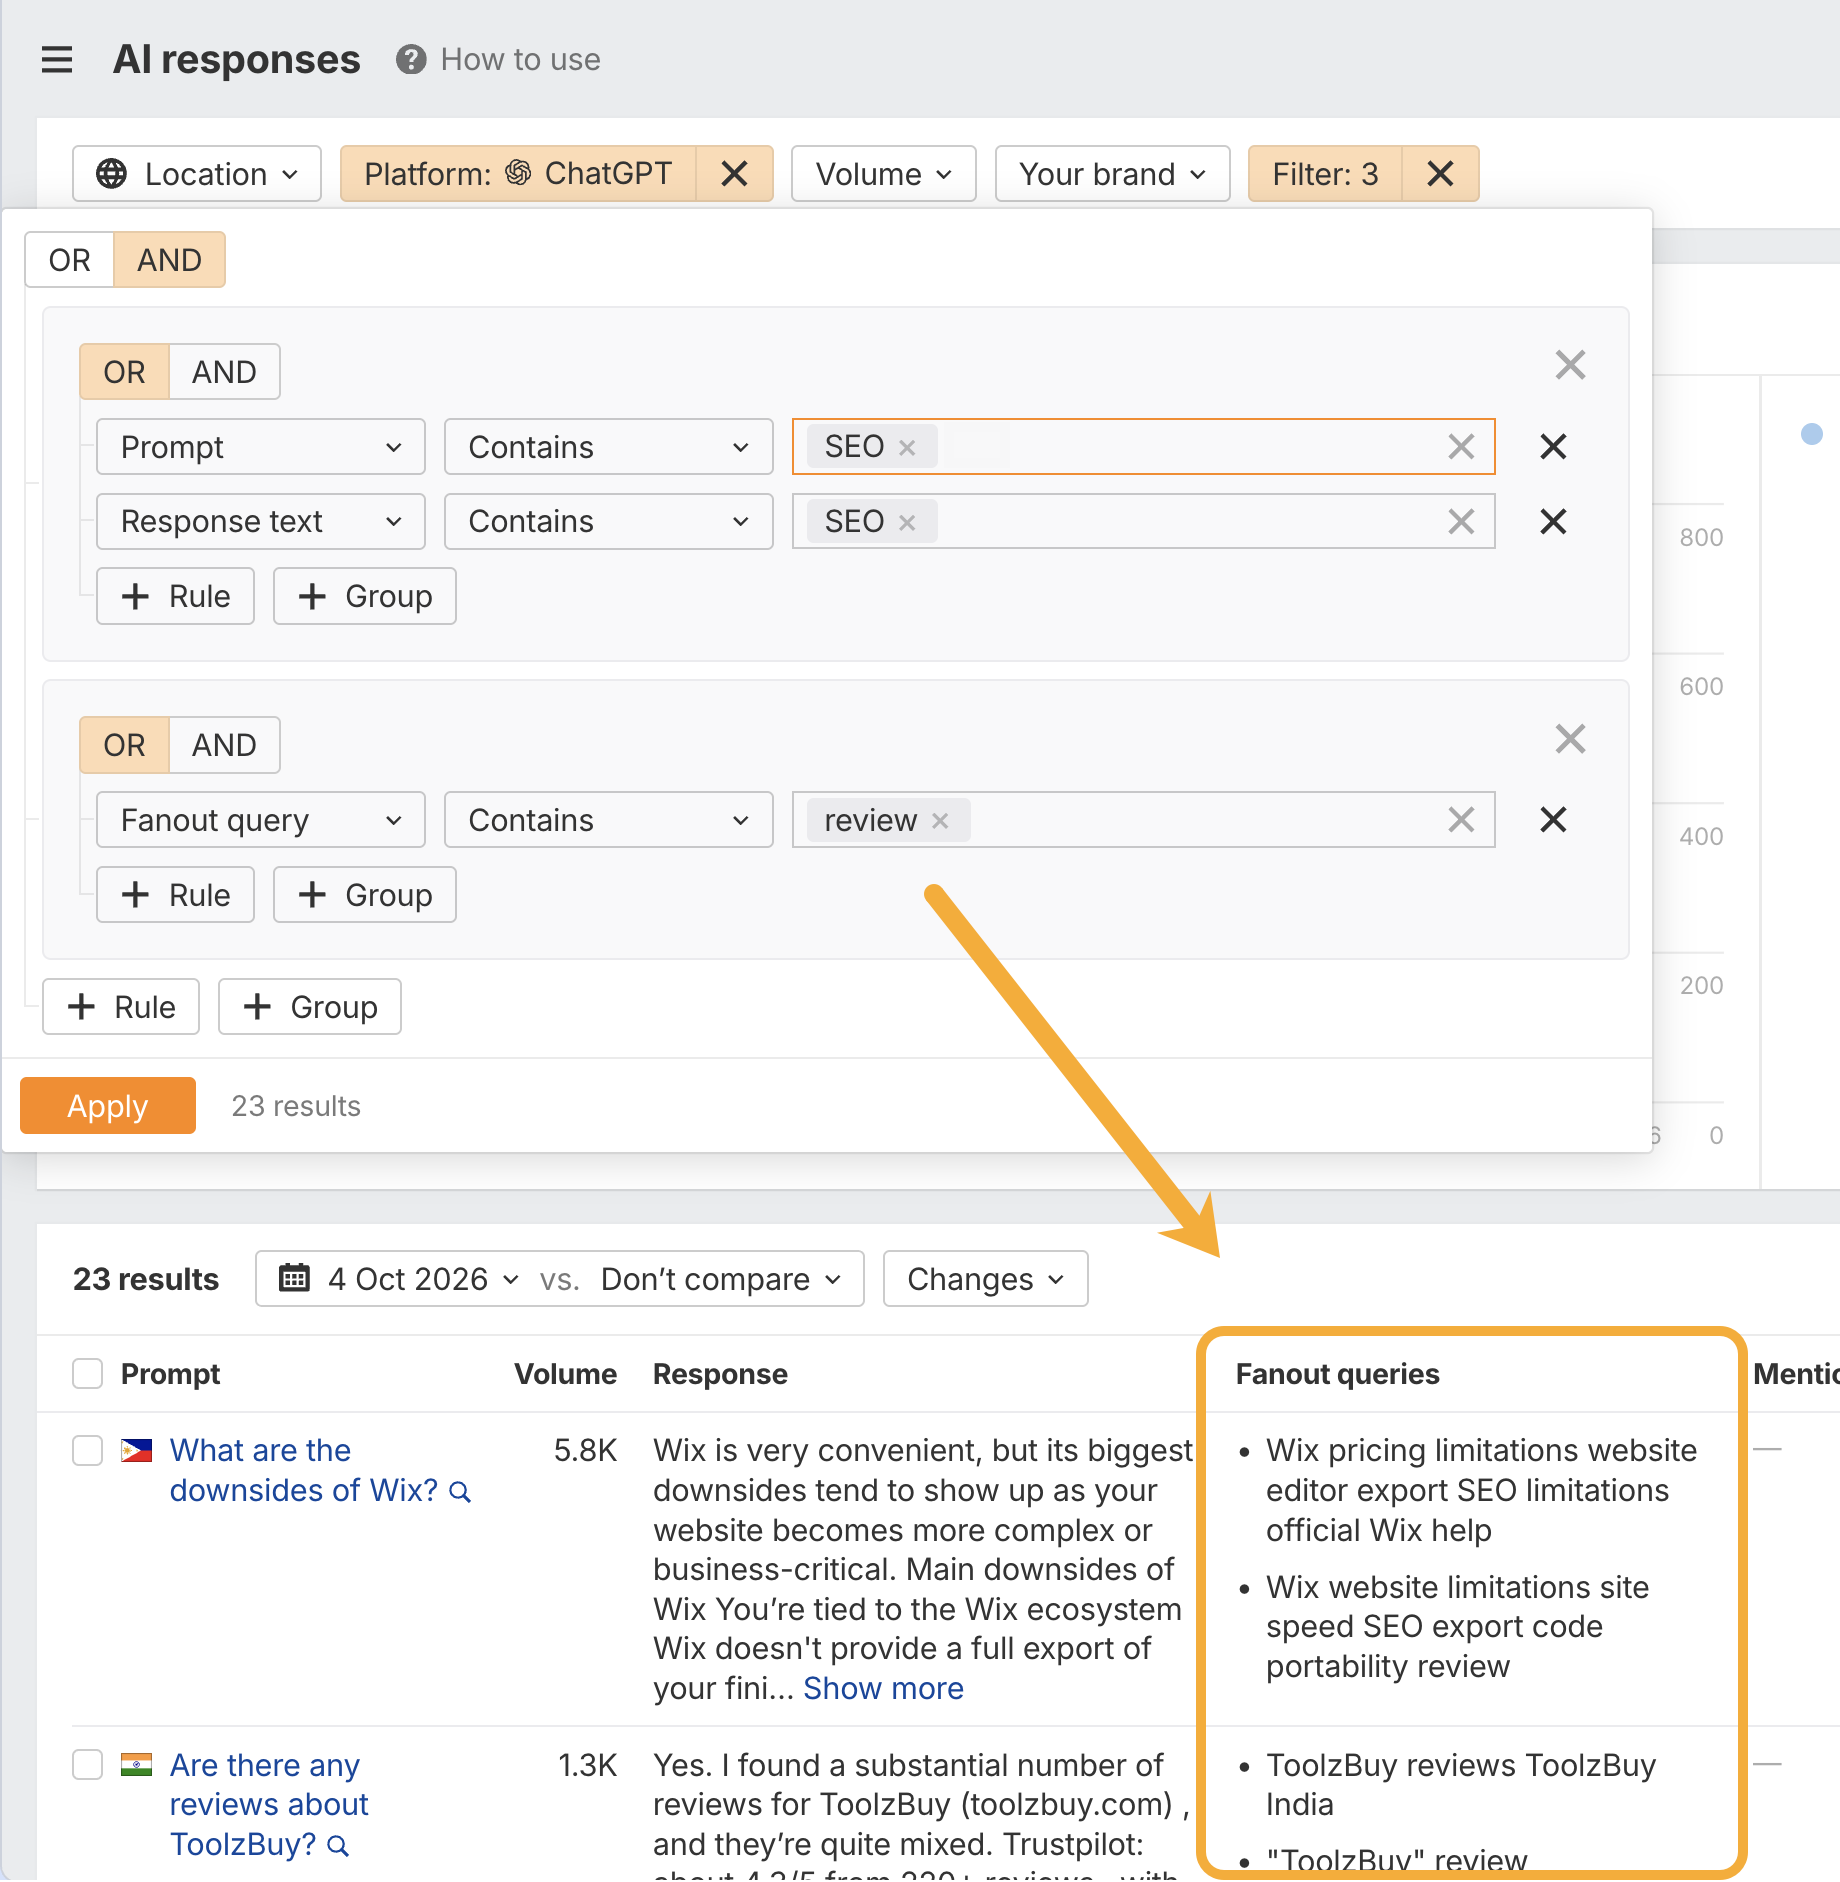
「AI の応答」レポートにアクセスし、ChatGPT と対象市場でフィルタリングしたうえで、「ファンアウトクエリ」列を「price」「specifications」「reviews」などの単語で絞り込むと、ChatGPT が対象トピックでどの程度の頻度で各タイプの検索を行っているかを確認できます。
ChatGPT における Reddit 引用数が 6 か月で 88% 減少
ファンアウトデータとあわせて、ChatGPT がどのサイトを引用しているかも調査しました。
この分析には別のデータセットを使用しています。2026 年 3 月から 9 月にかけて、ブランドレーダーが米国で収集した ChatGPT の引用データで、月あたり 240 万~380 万件の回答を対象としています。
スニペットデジタルは、8 月に ChatGPT における Reddit 引用が 86% 減少したことを報告しました。また、SEO コンサルタント会社 Orainti の創設者であるアレイダ・ソリス氏が共有したデータでは、7 月から 8 月にかけてソーシャルサイト、リファレンスサイト、ニュースサイトの引用シェアが最も大きく低下していました。
Ahrefs のブランドレーダーのデータでも、Reddit、Wikipedia、YouTube にわたって同様の低下が確認できます。
3 月の時点では、ChatGPT の回答のおよそ 5 件に 1 件が Reddit を引用していました。それが 9 月末には約 43 件に 1 件まで減少しています。
同様に、Wikipedia は 7 件に 1 件から 35 件に 1 件へ、YouTube は約 370 件に 1 件から 500 件に 1 件へと、それぞれ同じ期間で低下しました。
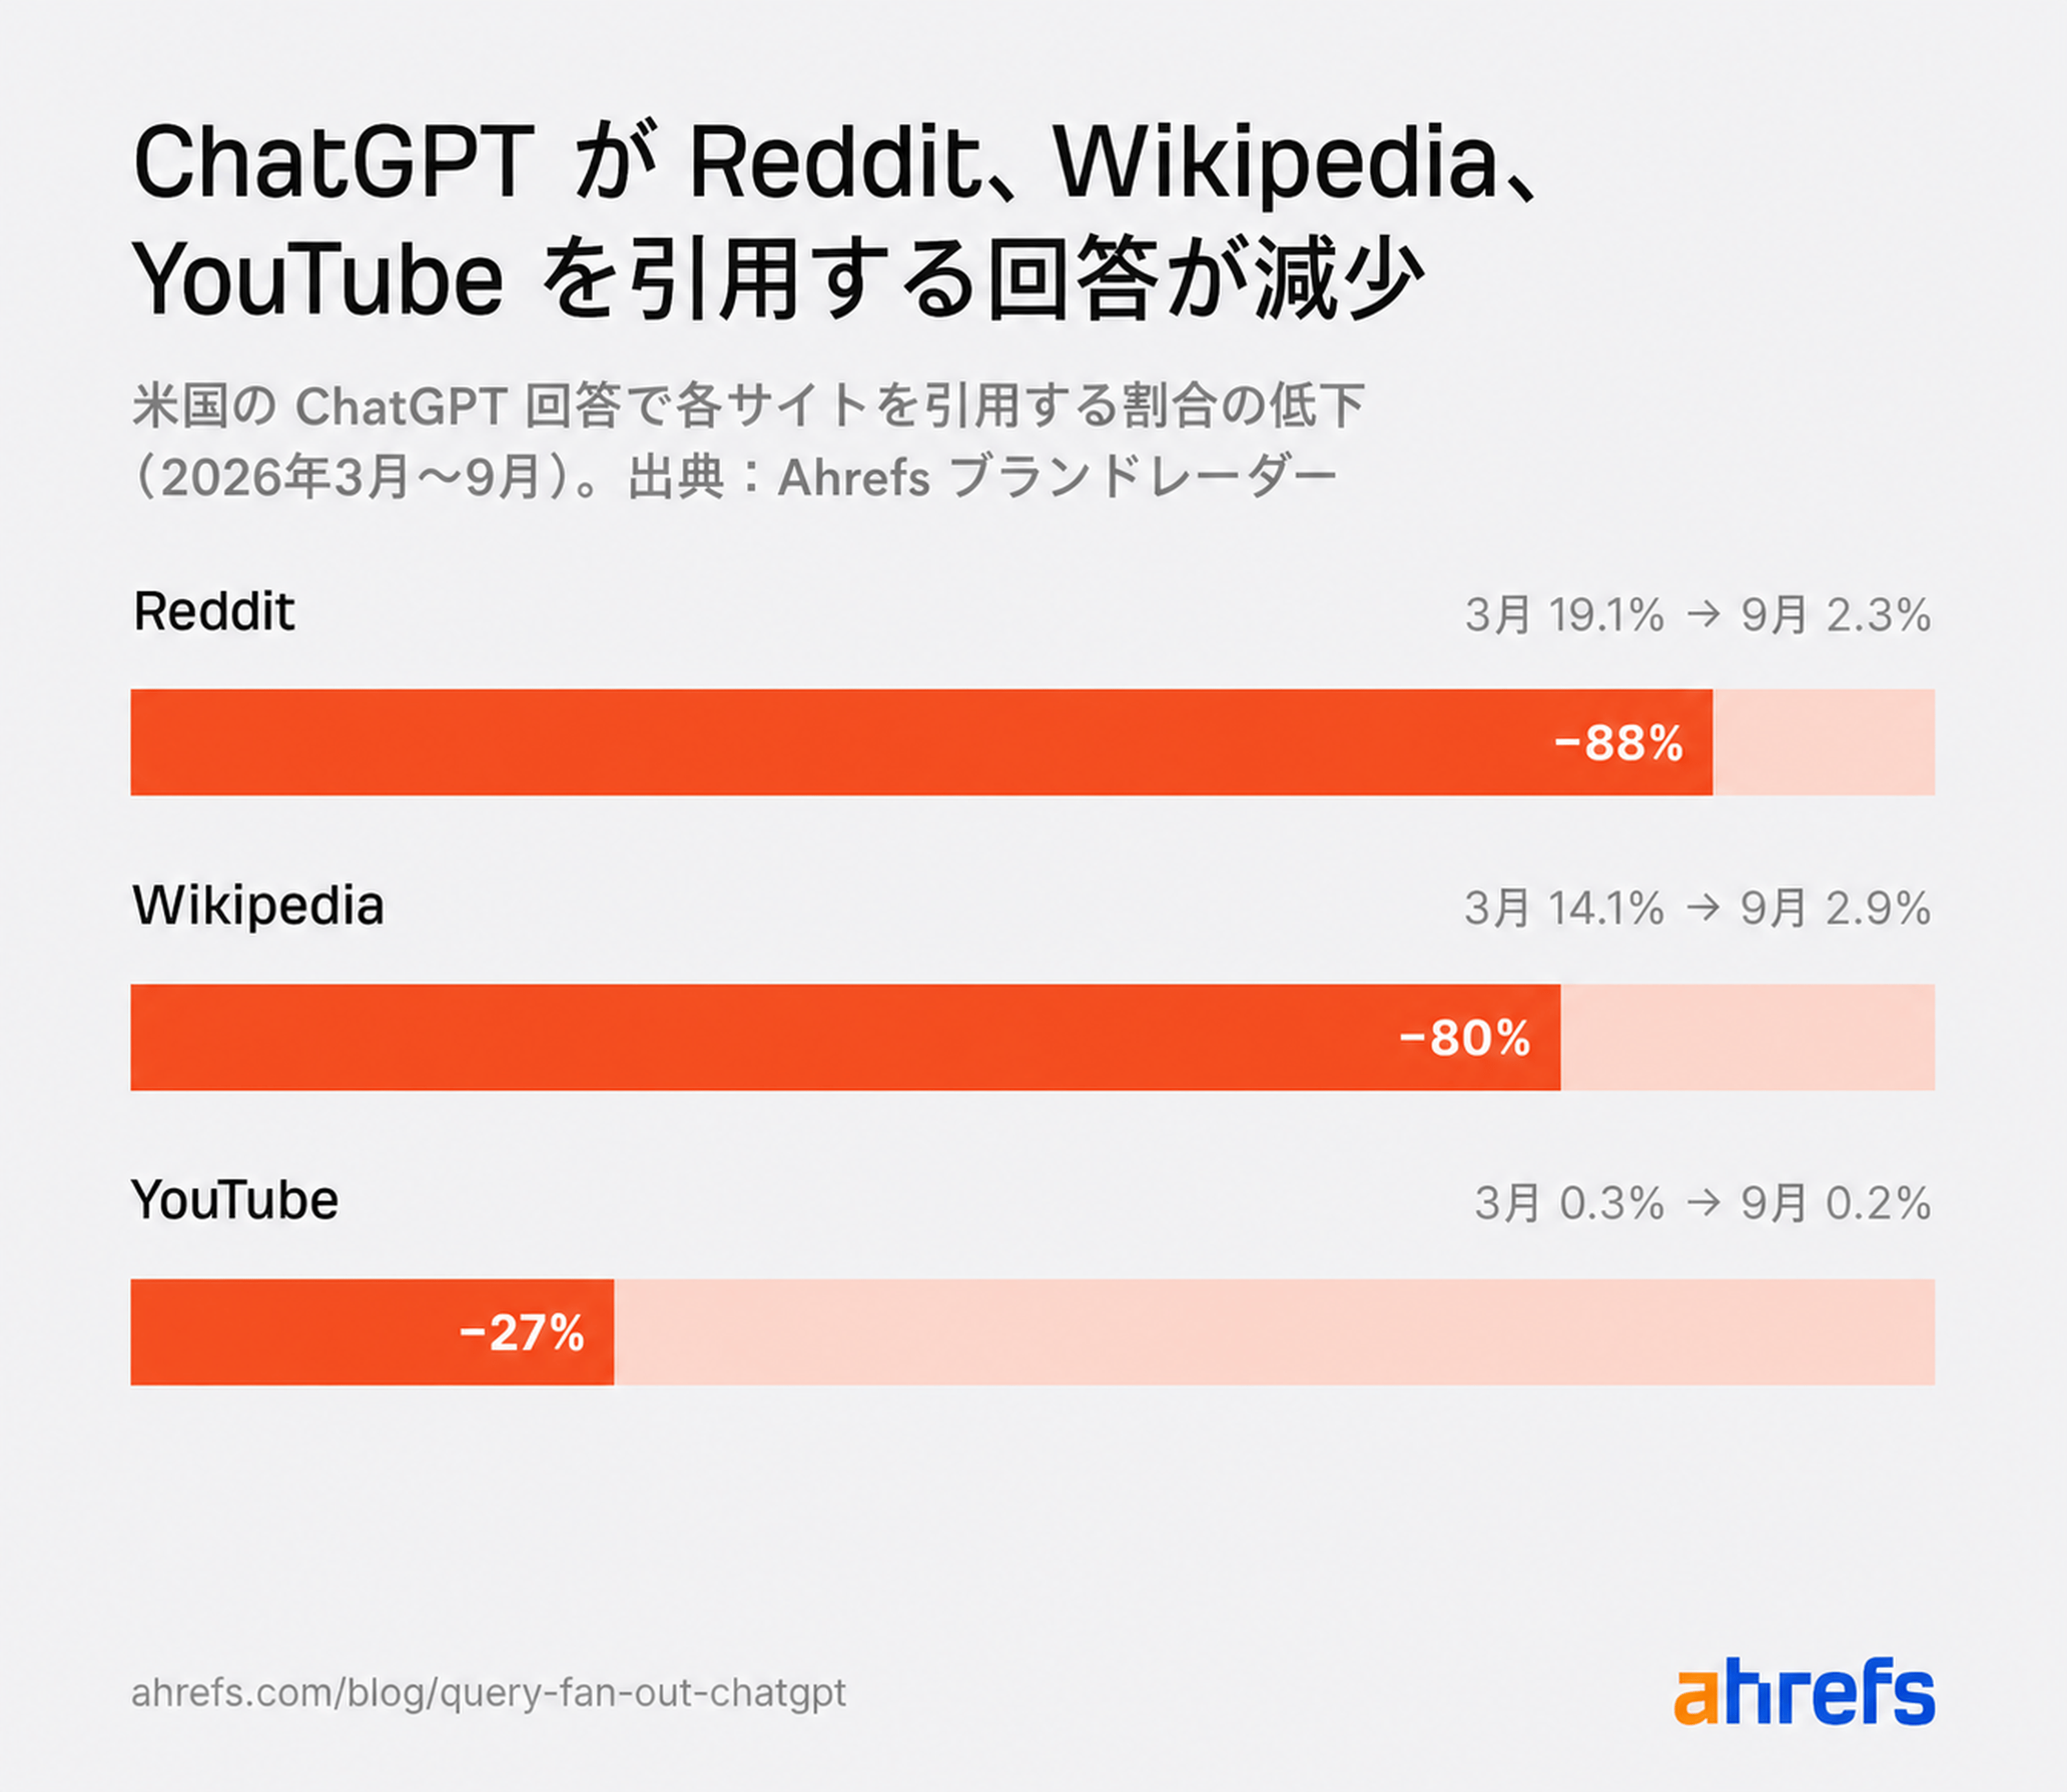
これらのサイトは依然として ChatGPT の引用数上位ドメインに含まれていますが、そのシェアは急速に縮小しています。AI における可視性の多くをこれらのサイト経由で得ている場合は、自社のトピックでどの程度引用が続いているか注視する必要があります。
ChatGPT は「情報をまとめるサイト」から「情報を生み出すサイト」へ移行している
Reddit、Wikipedia、YouTube が失った引用シェアの行き先は、研究機関、規制当局、ブランドサイト、そして実際に製品をテストするサイトでした。一方で、解説サイトやアグリゲーターサイトは低下しています。
以下のチャートは、ChatGPT の引用数上位 200 ドメインの中で、特に大きく順位が変動したサイトを示しています。3 月の 240 万件の回答と 9 月の 380 万件の回答を比較した結果です。
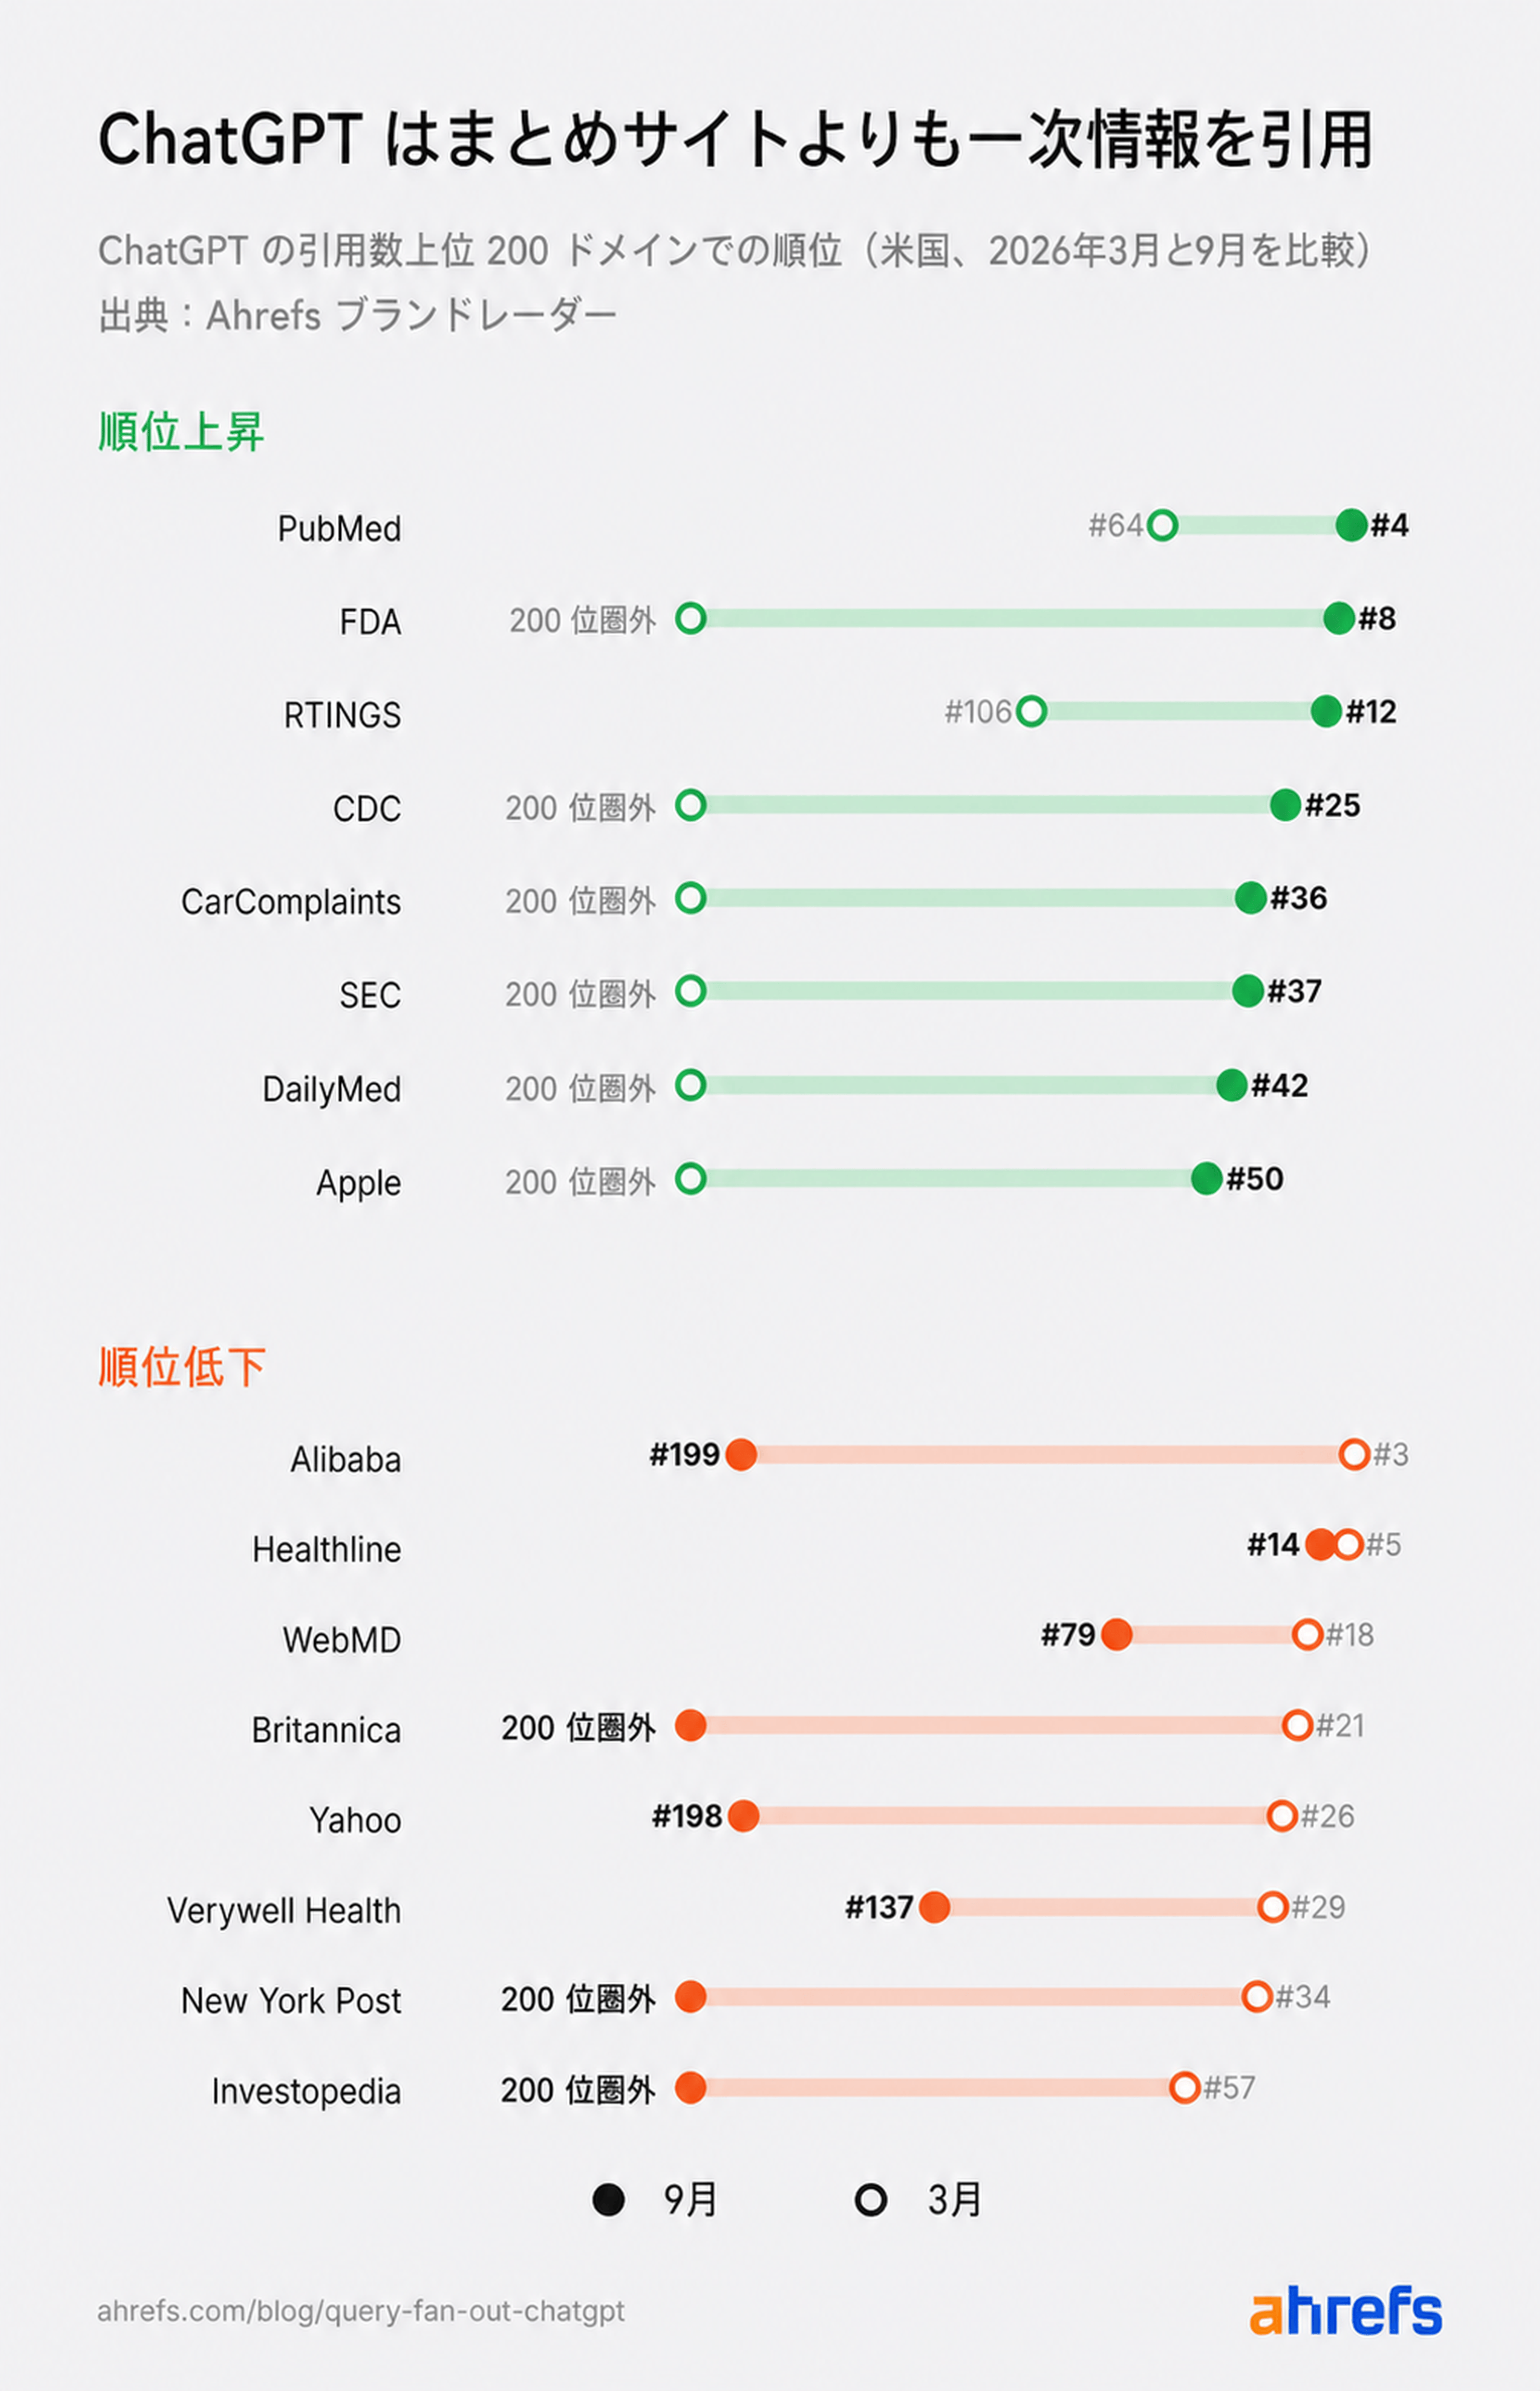
PubMed は ChatGPT の引用数上位ドメインの中で 64 位から 4 位へ急上昇し、FDA は 8 位に新規ランクインしました。一方、その研究成果をまとめる健康情報サイト(WebMD や Verywell Health など)は順位を落としています。
この結果がブランドレーダーに新しいプロンプトが追加された影響でないことを確認するため、3 月と 9 月の両方で上位 15 万プロンプトに含まれていた約 2.5 万件の同一プロンプトも比較しました。
チャート内のすべてのサイトが、同一プロンプトにおいても同じ方向に変動していました。
プロンプトの構成によって引用されるサイトは変わりますが、傾向は一貫しています。ChatGPT は、情報をまとめるサイトよりもオリジナルの情報源を優先するようになっているようです。
引用が増えたサイト | 引用が減ったサイト |
|---|---|
政府系の医療・研究機関:PubMed、FDA、CDC、MedlinePlus、DailyMed、NIH、NHS | 医療・金融の解説サイト:WebMD、Healthline、Verywell Health、Investopedia、Livestrong |
規制当局:SEC、EPA、FTC、CFPB、NHTSA、CPSC | 百科事典:Wikipedia、Britannica |
専門団体:American Academy of Dermatology、American Academy of Pediatrics、American Kennel Club | マーケットプレイス:Alibaba とそのサブドメイン、Accio |
ブランドサイトとサポートページ:Apple、Google Support、Microsoft Support、Toyota、Lowe's | シンジケーターとタブロイド:Yahoo、AOL、New York Post、The Sun |
実機テストサイト:RTINGS、CarComplaints、RepairPal | 低品質コンテンツサイト:flavor365、biologyinsights、enviroliteracy |
自社コンテンツが主に他者が先に公開した情報をまとめただけのものであれば、ChatGPT はまとめ記事ではなくオリジナルの情報源を引用する可能性が高まっています。
引用を維持しているのは、自社にしか作れないコンテンツです。独自調査、実際の製品テスト、自社の製品情報がこれに該当します。
自社の業界でファンアウトクエリを分析する方法
ファンアウトクエリをまとめて分析すると、ChatGPT が特定の業界でブランドを推薦する前にどんな情報を確認しているかが分かります。これにより、作るべきコンテンツや獲得すべきメディア露出が明確になります。
Ahrefs のブランドレーダーで分析でき、パターンの発見は Ask Ahrefs に任せることも可能です。
業界全体のファンアウトクエリを一括で取得する
1 件のファンアウトクエリだけではほとんど分かりません。多数を並べて見ることで、パターンが浮かび上がります。
ブランドレーダーでは、ChatGPT と Perplexity のファンアウトクエリを調査できます。
「AI の応答」レポートを開き、フィルターを追加して、プロンプトまたはレスポンスのテキストにトピックを入力します。
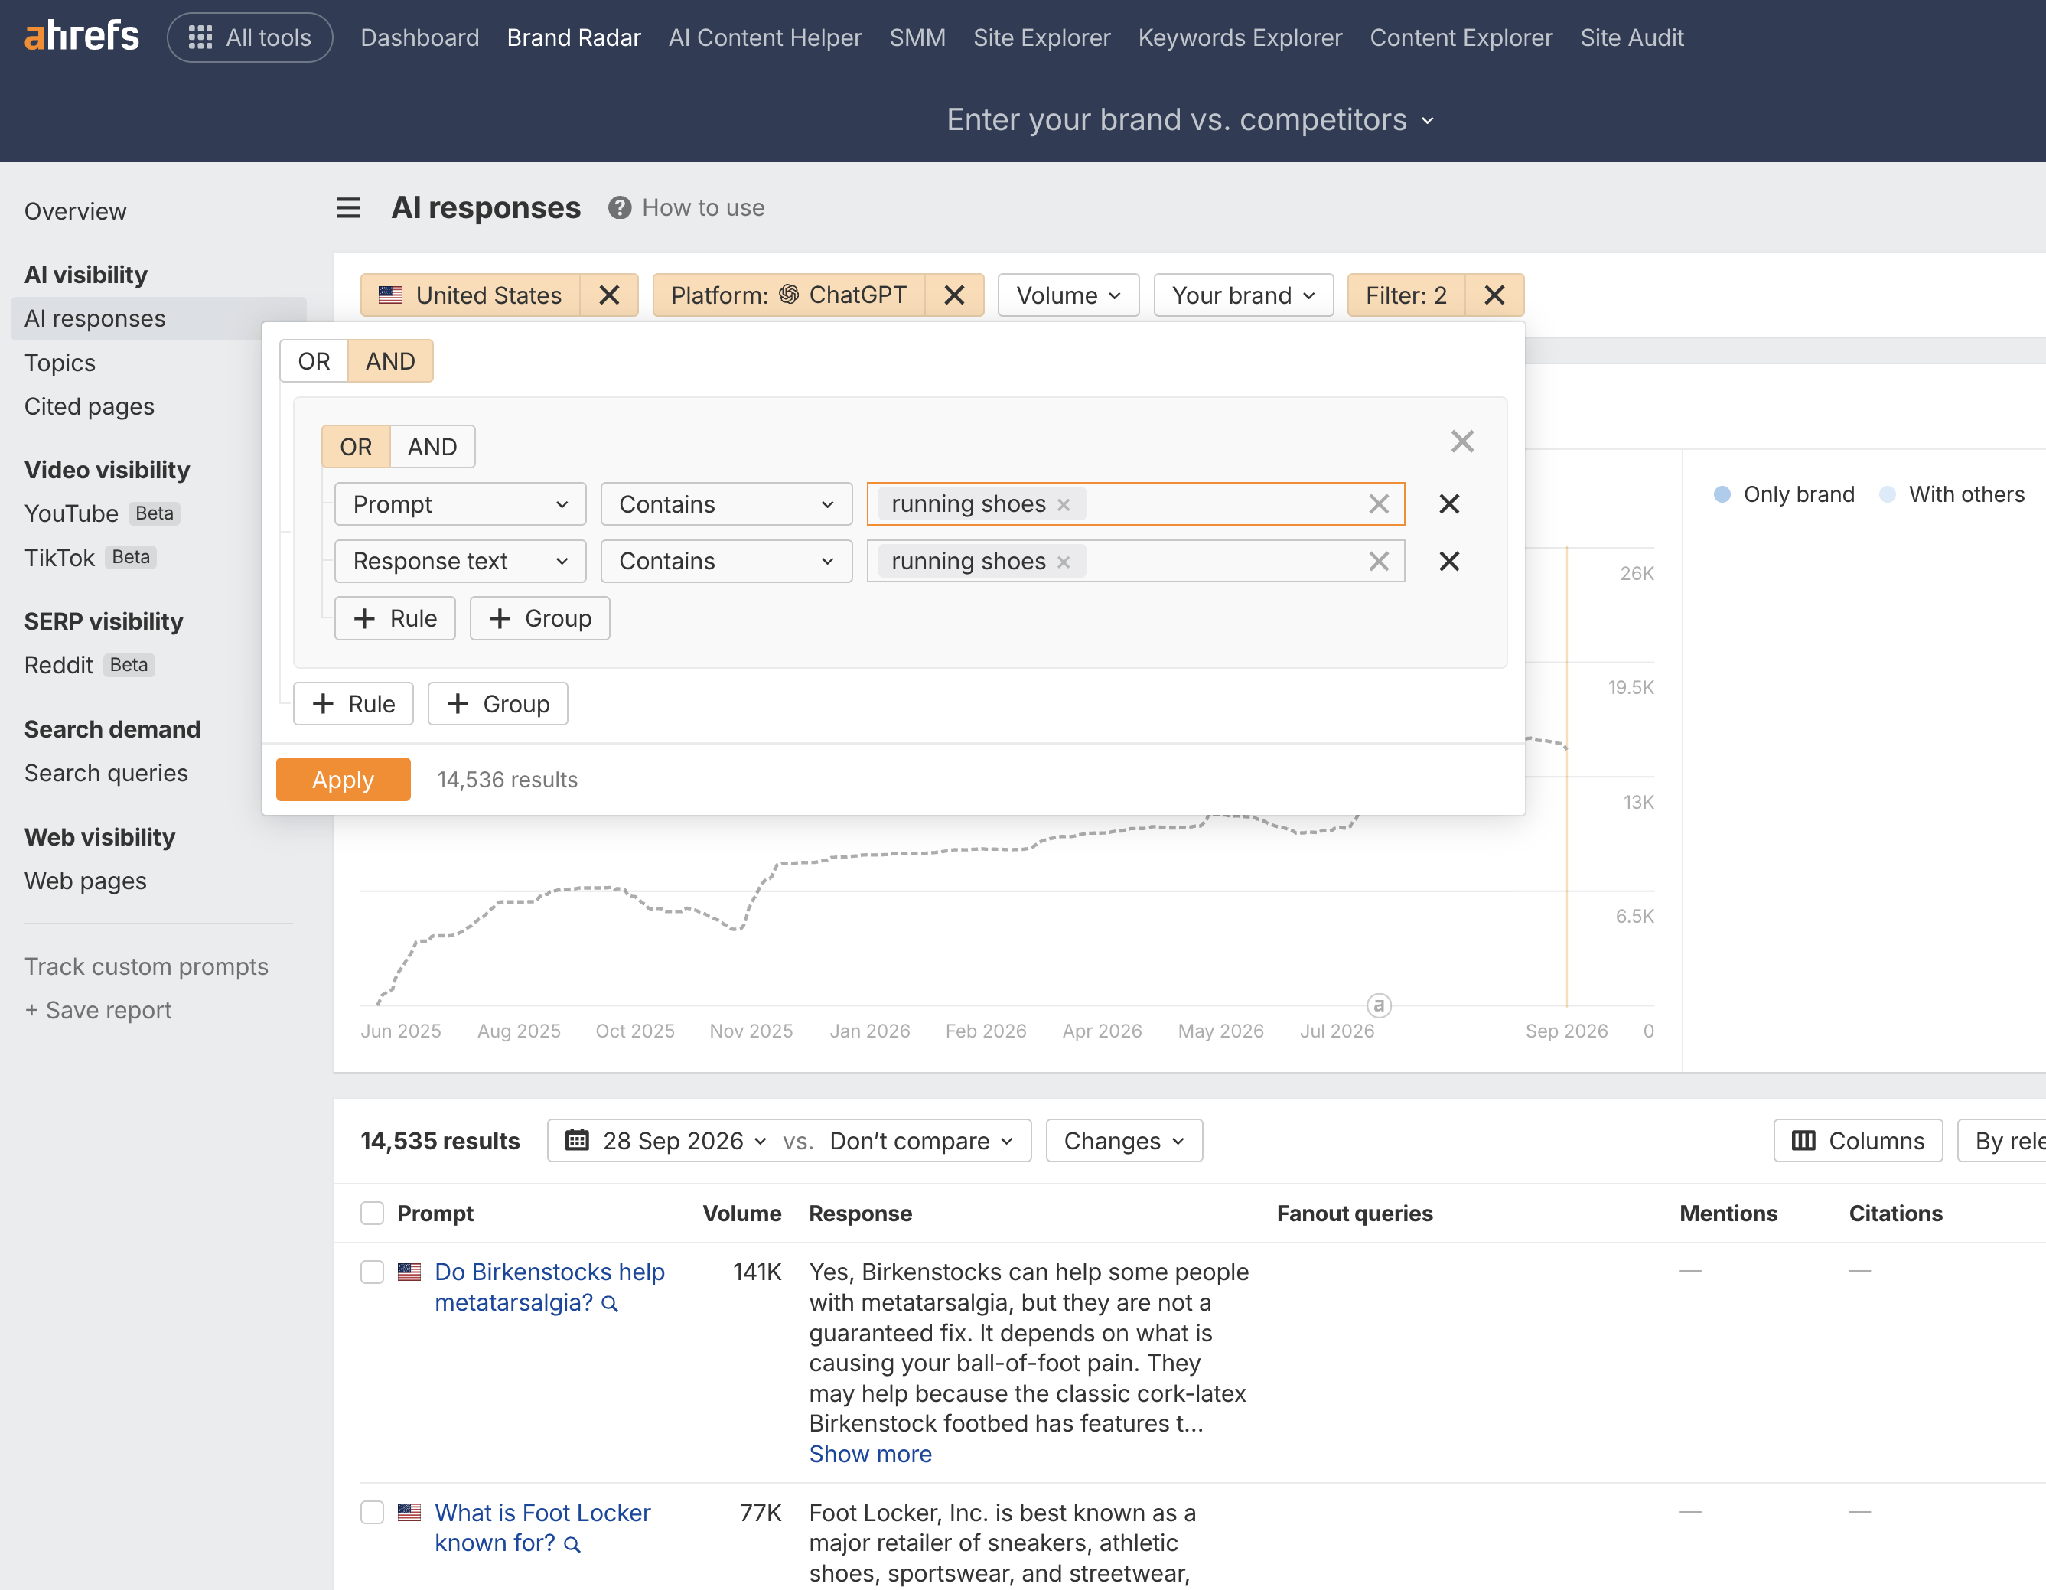
ここでは「running shoes」を例に選びました。
次に、プラットフォームを ChatGPT に、ロケーションをターゲット市場に絞り込み、各プロンプトの横にある「ファンアウトクエリ」列を確認します。
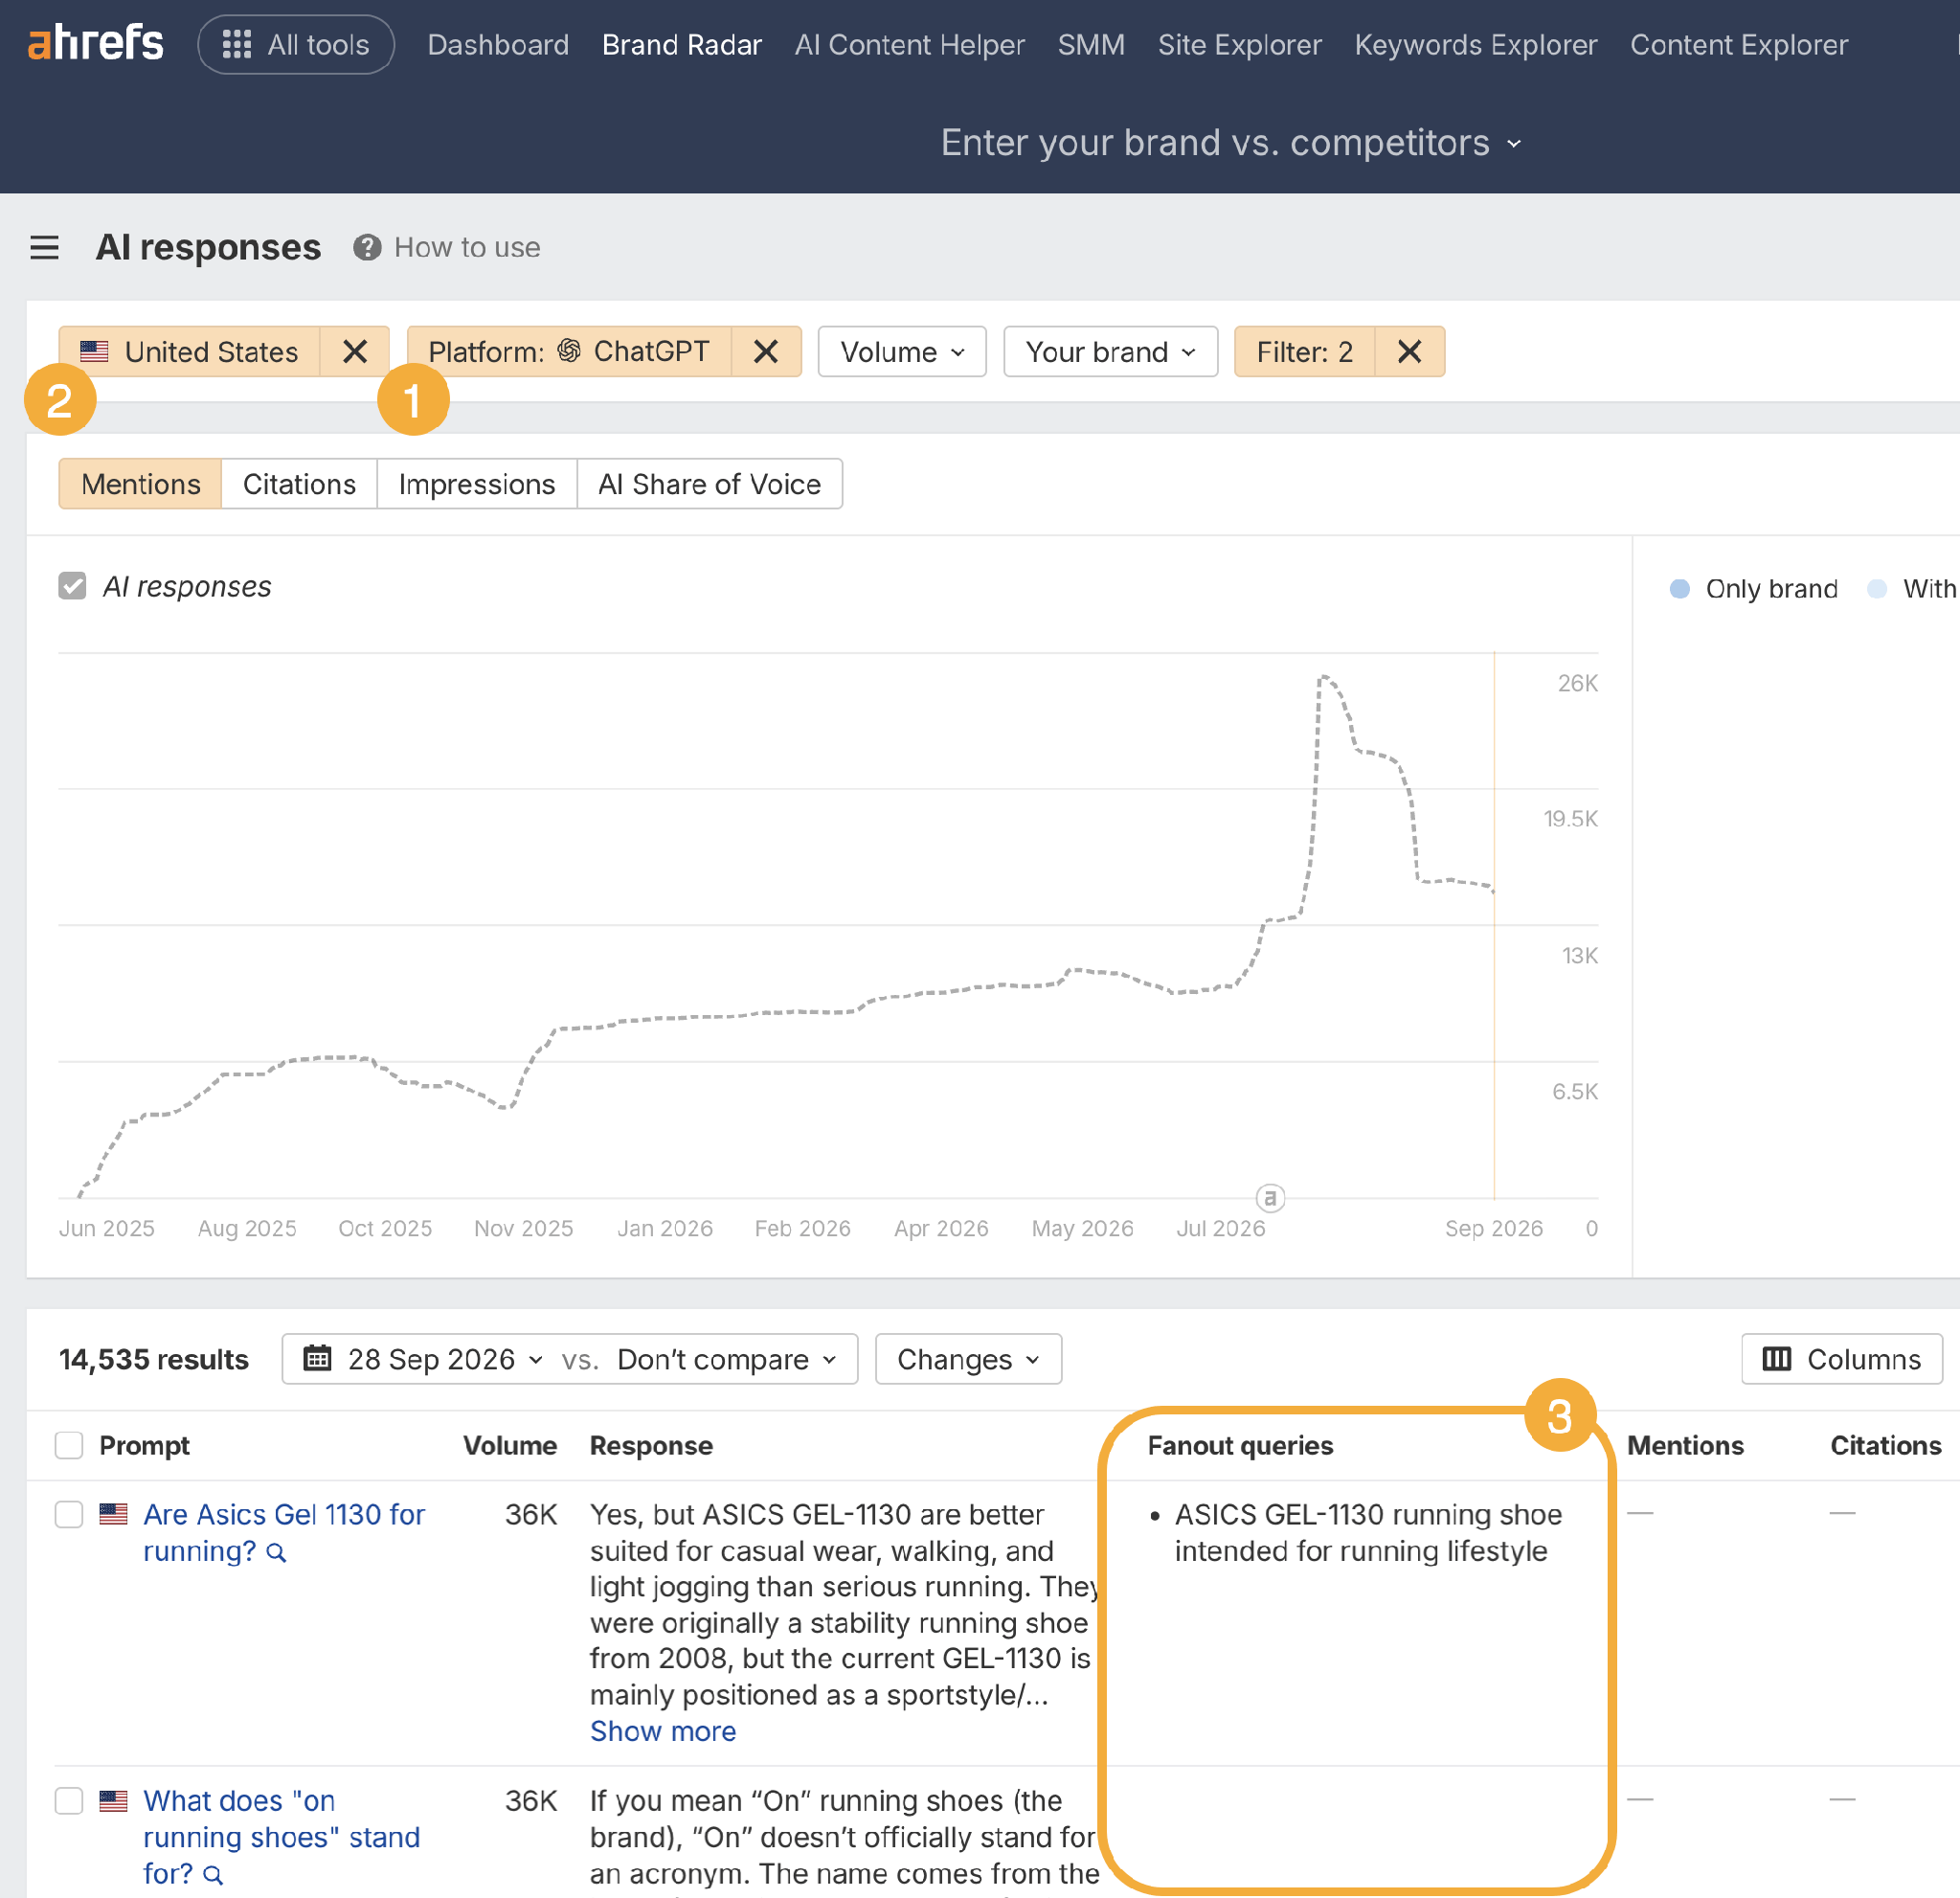
一括で分析するには、ファンアウトテキストでレポートをフィルターします。site:、「official」、「price」、「review」、「best」などのキーワードで絞り込めます。プラットフォーム上で分析することも、スプレッドシートにエクスポートすることも可能です。
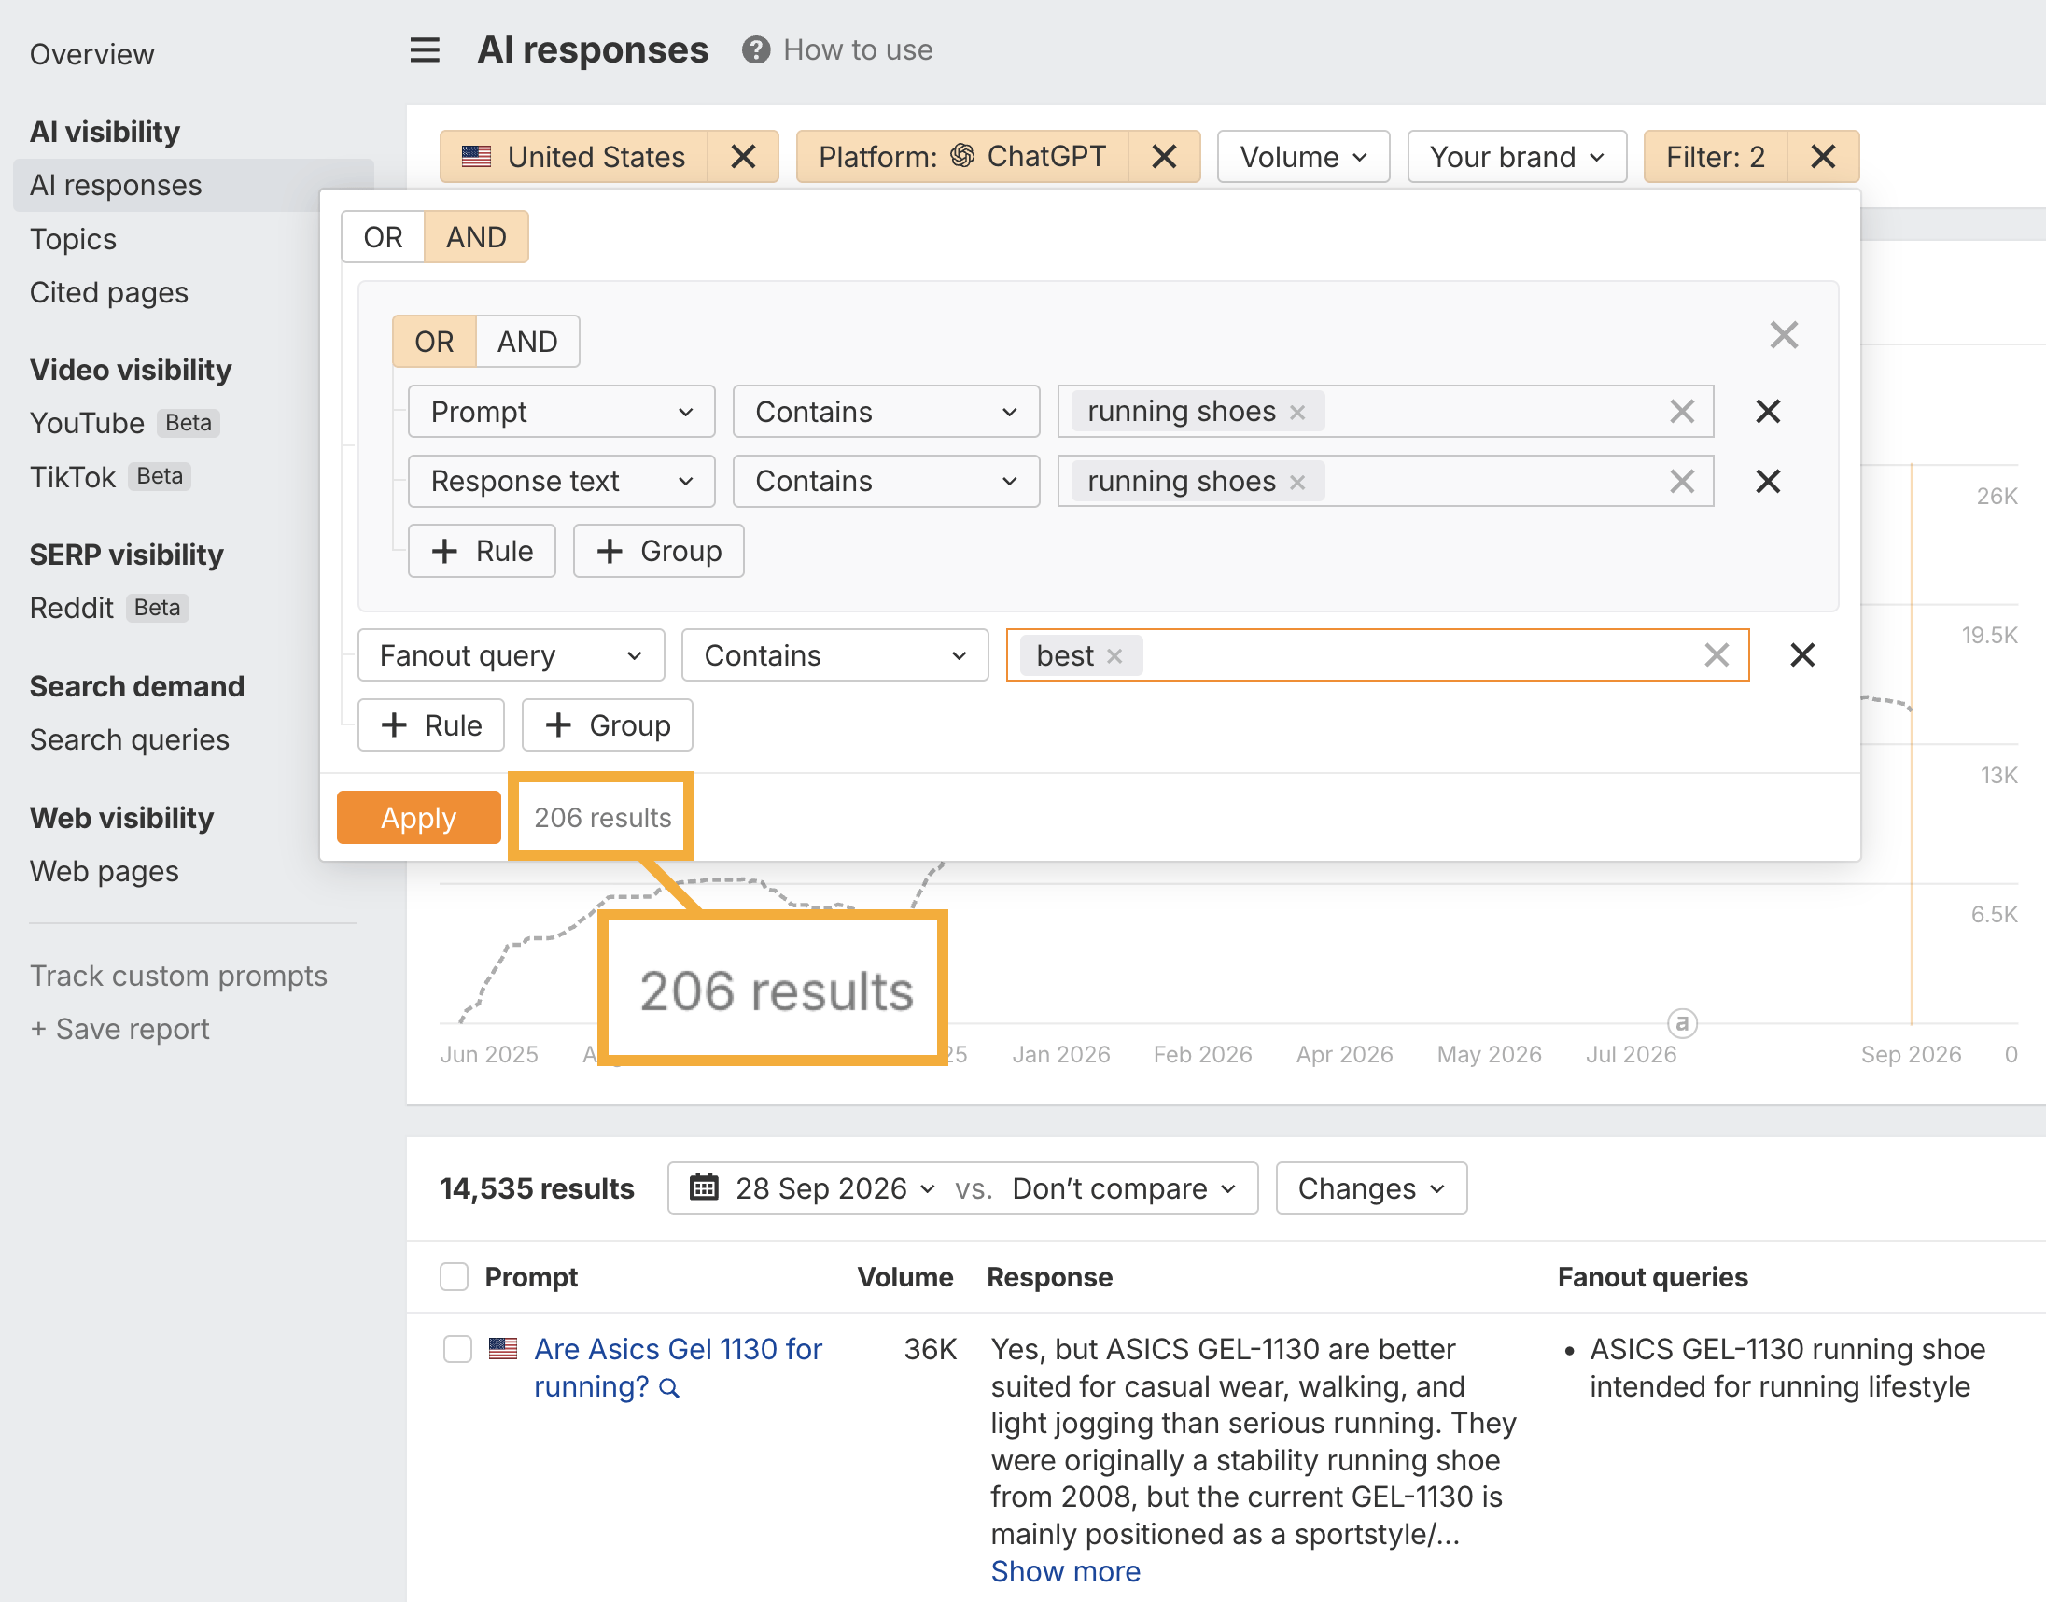
「running shoes」で分析したところ、ブランドレーダーはファンアウトクエリを含む米国 ChatGPT レスポンスを 1,474 件返しました。
「best」が 206 回、「2026」が 160 回、「review」が 117 回、「vs」が 105 回、「official」はわずか 65 回でした。
つまり、ランニングシューズの場合、ChatGPT は主に最新のサードパーティレビューや比較記事を探しています。先述の全体データとは異なる傾向です。
ランニングシューズブランドにとっては、製品ページだけに注力するより、レビュー掲載や比較ページの充実を図る方が効果的と言えます。
この分析はブランドレーダーのデータベースに含まれる既存のプロンプトに基づいていますが、独自の「カスタムプロンプト」でも同じ分析が可能です。
[recommendation title="Ask Ahrefs にファンアウトクエリのグルーピングを任せる"]
Ask Ahrefs を使えば、スプレッドシートで何時間もかかるグルーピングやカウント作業を自動化できます。
たとえば、以下のプロンプトをそのまま貼り付けるだけです。
ブランドレーダーから、トラッキングプロンプト/[カテゴリ名]に関するプロンプトの ChatGPT ファンアウトクエリを取得してください。意図別(価格、スペック、レビュー、比較、ハウツー)にグルーピングし、頻出ワードと
site:ドメインをカウントして、自社サイトがカバーしているグループとカバーできていないグループを教えてください。
このプロンプトを毎月実行すれば、どのクエリタイプが増加しているか把握できます。
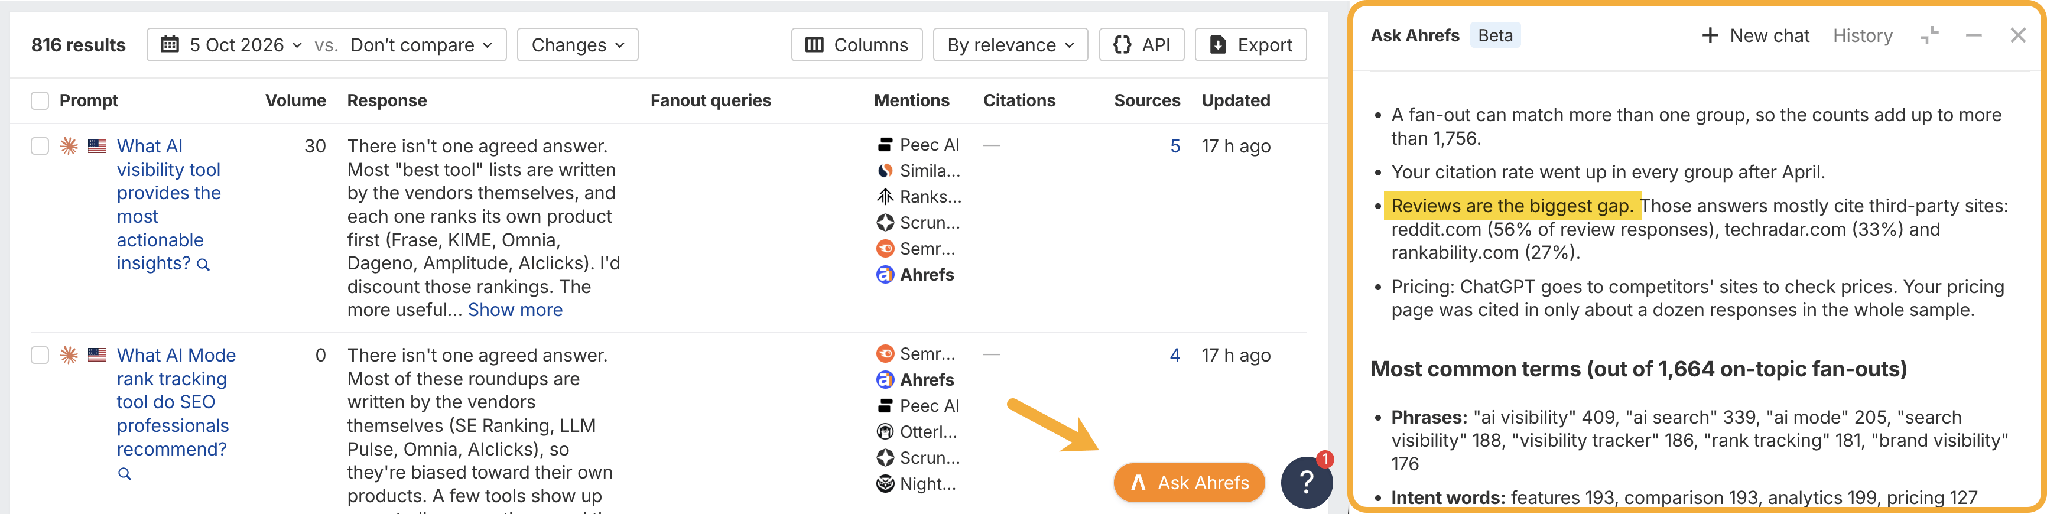
Agent A(旧 Ask Ahrefs)はトピック別のファンアウトクエリの内訳、競合ドメインと比較した site: プレゼンス、そして埋めるべきギャップについてアドバイスを含む分析レポートを作成します。
たとえば、Ahrefs のブランドレーダーツールを「AI visibility tool」関連のレスポンスでより多く言及してもらうには、レビューの獲得を増やす必要があることが分かりました。
他の調査との比較
今回のデータは、ChatGPT が公式ソースや site: 検索を重視し、引用を絞り込む方向に進んでいるという点で、他の調査結果と一致しています。
主な違いはスケールです。他の調査ではプロンプトあたりのファンアウト数や site: 検索の割合がはるかに高い値を示しています。
調査 | 条件 | プロンプトあたりのファンアウト数 | site: 割合 |
|---|---|---|---|
Ahrefs (本調査) | GPT-5.6 Luna、無料版、ログアウト状態、6,660 万レスポンス、全世界 | 約 1.6 (検索を実行したレスポンスのみ) | ファンアウトの 6.8% |
GPT-5.6 Sol (API 経由)、約 4,000 プロンプト | 7.61 | クエリの 64% | |
GPT-5.6 Luna、少数のトラッキングサブセット | 該当データなし | ファンアウトの 76% | |
GPT-5.6 と 5.5 の比較、サンプルサイズ非公開、一部トランザクショナルプロンプト | 56.5% のプロンプトで 2 件以上 | ファンアウトの約 23% | |
ログイン済みアカウント、57 件の会話、SaaS 寄りのプロンプト | Thinking モードで 15~40 | 商用プロンプトで頻出 |
本調査のプロンプトは幅広いトピックをカバーしています。
あらゆるトピックと国の実際の検索需要に基づいており、他の多くの調査が使用した「best X」のような商用プロンプト(ブランド検索を自然に誘発する)とは性質が異なります。
また、本調査は無料版のログアウトセッションを追跡しています。有料版や推論モデルと比べて検索頻度が低い条件です。
これらの数値は、2026 年 8 月から 9 月の 1 つのモデルのスナップショットにすぎません。OpenAI は ChatGPT の情報取得方法を常に変更しています。
ファンアウトクエリを定期的にトラッキングすれば、変化が起きた時点で察知でき、数か月遅れで気づくことを防げます。
まとめ
ChatGPT の無料モデルは、多くの質問をすでに学習済みの知識だけで回答しています。
そして Web 検索を行う場合、その情報の所有者(たとえば価格を設定しているブランド自体)に直接アクセスする傾向を強めています。
ChatGPT の回答に登場するルートは 2 つです。ChatGPT が検索しなくても名前を出せるほどの認知度を持つか、検索した際に見つかるオリジナルの情報源になるかです。
他者の情報をまとめただけのページは、現在最も引用を失っているカテゴリです。投資すべきは、自社にしか作れないコンテンツ、つまり自社の製品情報や独自の調査データです。
ただし、次のモデルアップデートで状況が再び変わる可能性もあります。ファンアウトクエリや AI レスポンスにおける自社の存在感を、継続的にウォッチしていきましょう。
Ahrefs をもっと活用 👉
▶︎ Ahrefs 公式ブログ --- 本社発信の記事
▶︎ Ahrefs Canny --- 開発チームへ意見を送る
▶︎ X 公式アカウント--- 最新情報をリアルタイムで
▶︎ YouTube 公式チャンネル--- 動画コンテンツをチェック
▶︎ Ahrefs note --- 日本チーム発信の記事
Ahrefs のコンテンツマーケター。Pi Datametrics、BuzzSumo、Cision といった SaaS 企業でシニアコンテンツ担当として 10 年以上の経験を積む。日中はコンテンツや SEO について書き、オフや仕事の後はサッカーやカラオケを趣味として楽しむ。